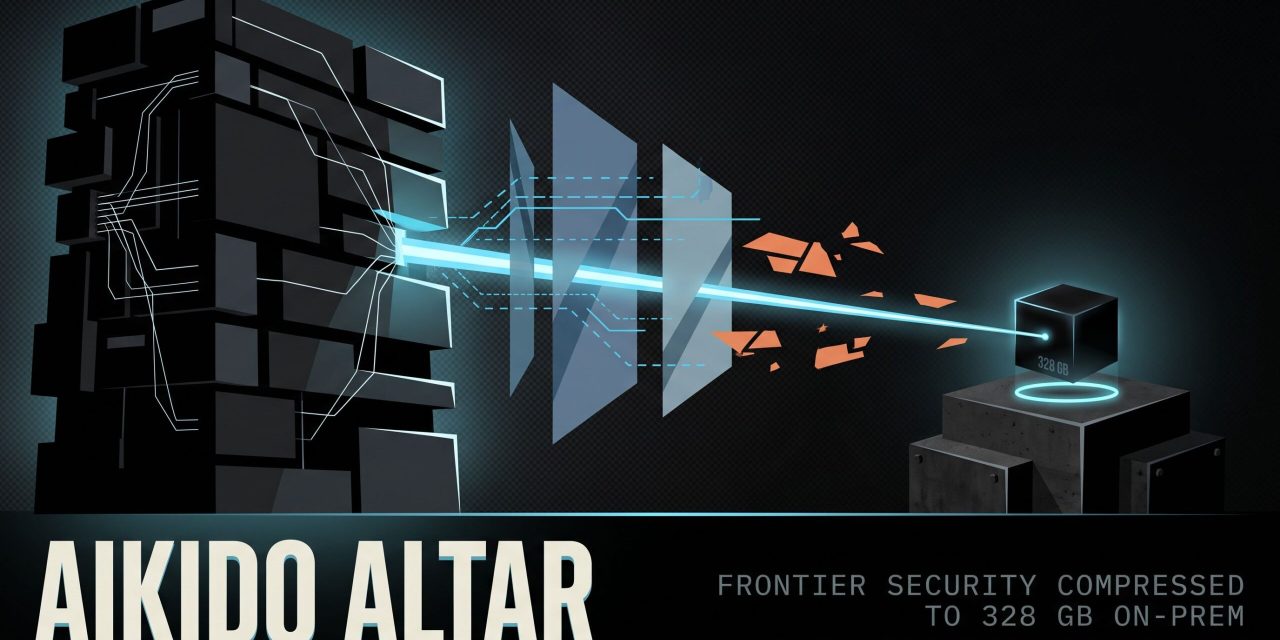
Aikido lanceerde op 21 september Altar, zijn eerste open-weight securitymodel. Defensieve AI op frontierniveau draait volledig op de infrastructuur die je zelf beheert. Altar is een sterk gecomprimeerde variant van GLM-5.3 van Z.AI en draait op een enkele node met vier H200 GPU’s. Dat maakt het model relevant voor elke organisatie die gevoelige code nooit naar een externe inference-dienst wil of mag sturen.
Waarom security-AI lokaal moet kunnen draaien
Wie een gesloten frontiermodel gebruikt, stuurt in de praktijk broncode, interne architectuurdocumentatie en nog onopgeloste bevindingen naar de infrastructuur van een derde partij. Voor veel teams is dat onwenselijk. Voor een bank met verplichtingen rond data residency, een ziekenhuisgroep met strikte verwerkingsregels of een industriële speler waarvan de OT-omgeving geen internetverbinding heeft, is dit geen optie.
Aikido zette eerder al een stap in deze richting met Aikido Machine, een appliance voor autonome pentesting die volledig binnen de infrastructuur van de klant draait, inclusief air-gapped omgevingen. Altar levert daar nu het model bij. Het beoordeelt code, stelt patches voor en ondersteunt pentests, terwijl de meest gevoelige context van een organisatie het netwerk nooit verlaat.
Waarom de sterkste open modellen zo zwaar zijn
Het deploymentprobleem zit in de omvang. GLM-5.3 op volle precisie neemt 1,51 TB in beslag. Zo’n model serveren vraagt honderden gigabytes aan unified memory, en de snelheid zakt weg zodra je meerdere gesprekken parallel draait met grote context windows.
Een deel van die omvang komt door de mixture-of-experts-architectuur. Zo’n model bestaat uit veel kleine gespecialiseerde neurale netwerken, experts genoemd. Per token is er maar een handvol actief, maar de volledige pool moet wel in het geheugen aanwezig zijn. Securitywerk zoals code reviewen, patches voorstellen en pentesten raakt slechts een klein deel van die pool.
Elke agent houdt een lopend verslag bij van alles wat hij heeft gezien en gedaan. Dat verslag staat in hetzelfde GPU-geheugen als het model en groeit naarmate een onderzoek langer duurt en er meer onderzoeken parallel lopen. Model en context putten uit dezelfde vaste geheugenpool. Hoe kleiner het model, hoe meer ruimte overblijft voor alles wat ernaast draait.
Van 1,51 TB naar 328 GB met quantization en expert pruning
Aikido combineerde twee technieken. Met quantization worden de gewichten van een model met minder bits opgeslagen. Het startpunt was een checkpoint met AWQ, dat de meeste expertgewichten in vier bits bewaart in plaats van zestien. De tussenwaarden tijdens inference blijven zestien bits, vandaar de aanduiding W4A16. Dat bracht het model van 1,51 TB naar 488 GB.
De tweede techniek is expert pruning, het verwijderen van complete expertblokken. Dat verwijderen is mechanisch eenvoudig. Bepalen welke experts weg kunnen is het moeilijke deel. Verwijder de verkeerde experts en het model kan zijn programmeerkennis behouden maar een bepaalde taal grotendeels verliezen, waardoor het documentatie of business rules in die taal onbetrouwbaar interpreteert.
Voor de selectie gebruikte Aikido traces van zijn eigen pentesting harness op interne benchmarks. Die traces bevatten de code, tool calls en antwoorden die agents tijdens een volledige pentest gebruiken. Er was geen klantdata bij betrokken. Om het taalbegrip te beschermen voegde het team meertalige tekst toe, zodat documentatie in het Frans, Nederlands of een andere taal correct verwerkt blijft.
De pruning gebeurde met REAP van Cerebras, een methode die de bijdrage van een expert inschat op basis van zowel de routergewichten als de omvang van de output. Gewoon tellen hoe vaak een expert wordt gekozen geeft maar een deel van het beeld. Het team keek ook per domeingroep naar bijdragen, zodat een capaciteit die voor een minder gangbare workload belangrijk is, niet verdwijnt in een algemeen gemiddelde.
Wat er na compressie overblijft
Altar behoudt 168 van de oorspronkelijke 256 routed experts per expertlaag. Er verdwenen er 88, ofwel 34,4 procent. De router kiest nog steeds acht experts per token, nu uit een kleinere pool. Het eindresultaat is 328 GB aan opgeslagen gewichten. Dat is 78,2 procent minder dan GLM-5.3 op volle precisie en 32,8 procent minder dan de gekwantiseerde ouder. De pruning schrapte dus nog eens 160 GB.
Aikido testte Altar op een interne benchmark met 32 bekende CVE’s verspreid over 30 repositories en drie runs per geval. Altar haalde gemiddeld 60,4 procent recall per run en vond 23 van de 32 kwetsbaarheden minstens één keer terug. De gekwantiseerde GLM-5.3 kwam op 61,5 procent met dezelfde 23. Het origineel op volle precisie scoorde 65,6 procent en dekte er 25.
Het inkrimpen van de gekwantiseerde ouder met bijna een derde kostte dus ongeveer één procentpunt gemiddelde recall, met alle vulnerability coverage behouden. Ten opzichte van het origineel bleef 92 procent van de gedekte kwetsbaarheden over.
Limieten van de benchmark voor Altar
De benchmark meet gerichte herontdekking van bekende kwetsbaarheden binnen een pipeline waarin andere modellen de omliggende stappen uitvoeren. Blinde discovery over een volledige codebase, het uitvoeren van exploits om bevindingen te valideren en de kwaliteit van de voorgestelde fixes werden niet getest.
Wat de cijfers aantonen is dat een groot deel van de geteste securitycapaciteit forse compressie overleeft.
Zelf aan de slag
De gewichten van Altar zijn publiek beschikbaar via de Aikido website. Je vindt er ook de modelkaart, licentie, serving flags en deploymentinstructies. Je kan het model draaien op een node met vier H200 GPU’s en de nieuwste versie van vLLM. Binnen de eigen productlijn rolt Aikido het model uit over Aikido Attack, Code Security Audit en Deep PR Review.
Wat na compressie
Aikido noemt Altar een beginpunt. Op het vlak van compressie kijkt het team naar formaten met nog minder bits, zoals EXL3, waarmee mogelijk meer experts behouden blijven.
De volgende stap is trainen in plaats van comprimeren. Denk aan fine-tunen voor securityworkflows, beter toolgebruik, redeneren over langere trajecten en een zelflerende pipeline die gevoed wordt door interne benchmarks. Dat werk moet zich uitstrekken over vulnerability research, codeanalyse, remediation en andere defensieve workflows.
Wat afwegen
Altar lost een reëel knelpunt op voor organisaties die securitydata om wettelijke of principiële redenen binnenshuis moeten houden. Levert een model van 328 GB op eigen hardware een resultaat dat betrouwbaar genoeg is om de operationele last van zelf hosten te dragen? Dikwijls is er geen alternatief.