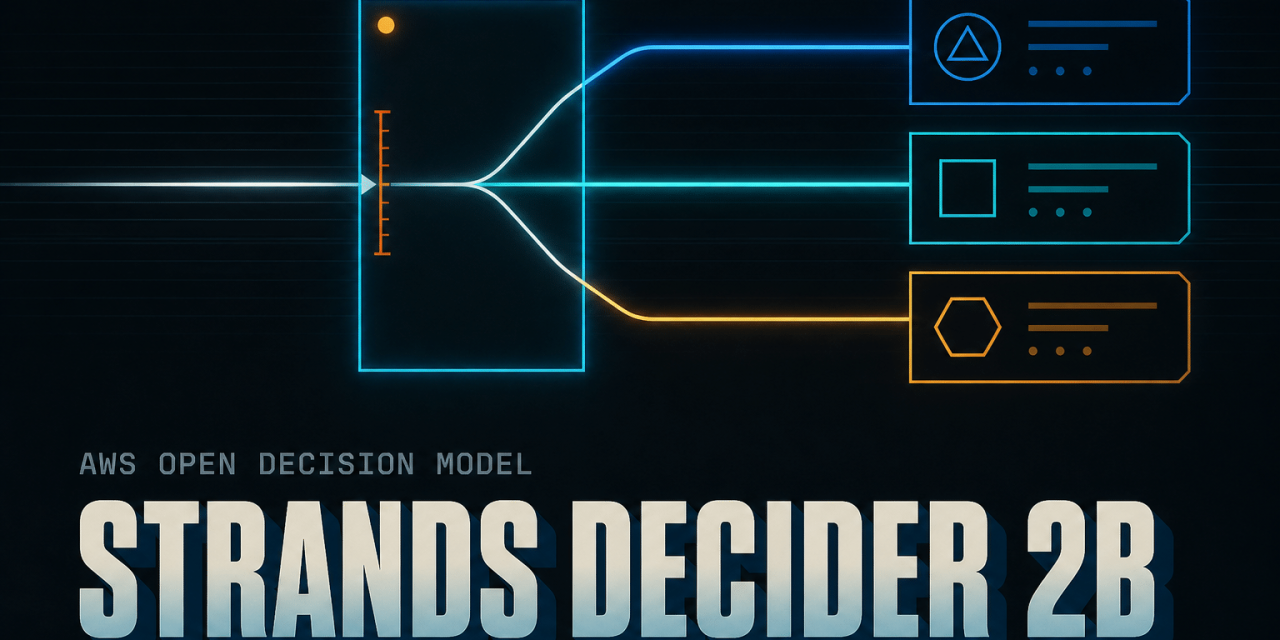
AWS lanceerde op 1 oktober Strands Decider 2B, een klein open source decision model. Het model beslist in een fractie van een seconde of een voorgestelde actie verder mag, en het vertelt je hoe zeker het daarvan is.
De release volgt op TypeSafe’s Jev, het model dat medio september de huidige golf van decision models op gang trok. Sindsdien verschenen Kev, Laya, Mapika’s decider familie en tientallen andere varianten. OpenAI kondigde in dezelfde week een Decisions API aan als limited preview. AWS kiest een andere route: je kunt het model downloaden, lokaal draaien en zelfs volledig opnieuw trainen.
Wat een decision model anders doet dan een LLM
Een LLM genereert vrije tekst. Een decision model kiest uit opties die jij als developer aanlevert, of geeft een numerieke score. Denk aan vragen zoals gaat de zin “turn on the lights” over de koffiemachine, ja of nee? In welke taal staat “sihamba ngokushesha”, Engels, Zulu of Nederlands? Hoe positief is een review op een schaal van 0 tot 1?
Die eenvoud levert drie dingen op. Het model antwoordt sneller, het kan geen opties verzinnen die je niet hebt aangeboden, en elke beslissing krijgt een betrouwbaarheidsscore. Frontier LLM API’s bieden zo’n gecalibreerde score niet aan. Daar staat tegenover dat een decision model slecht is in complexe redeneringen en onbruikbaar is voor coding, chatbots of het samenvatten van documenten. AWS noemt het daarom ook een system one model, verwijzend naar snel en intuïtief denken.
Volgens het team valt deze klasse van modellen tussen LLM’s en klassieke classifiers in. Een klassieke classifier vraagt tijd, data en expertise om te trainen voor één specifieke taak. Strands Decider is een algemeen inzetbaar classificatie en scoringmodel dat je per request nieuwe labels kunt geven.
Hoe Strands Decider 2B werkt
De basis is Qwen3.5-2B, een open model van Alibaba. AWS noemt dat deel de torso. Het team verwijderde de language model head die tekst genereert en verving die door een pointer head van iets meer dan een miljoen parameters. Die head vergelijkt de hidden state op de positie van het antwoord met de hidden state aan het einde van elke aangeboden optie. Het resultaat is een kansverdeling over de opties, berekend in één forward pass zonder decoding loop. De torso zelf is aangepast met een LoRA adapter van rank 16. In totaal telt het model 1,9 miljard parameters.
Een slim detail zit in het ontwerp van die head. Ze bevat geen parameters per optie. Het model kan dus niet aanleren dat de eerste optie meestal juist is, er is geen maximum aantal opties en de labels komen uit het request in plaats van uit de weights. Uit hetzelfde mechanisme komen drie vraagtypes: ja of nee, één keuze uit N, en een score op een geordende schaal.
De huidige versie is de tweede grote iteratie van de architectuur. De eerste gebruikte een slot head die de laatste hidden state naar een vaste set slots vertaalde, en die presteerde duidelijk slechter. Het referentiemodel is v19, en alle eerdere versies staan in de repository.
Een agent controleren voordat hij handelt
Het voorbeeld van AWS draait in het eigen open source Strands agent framework. Een gebruiker vraagt naar het weer zonder locatie. De agent is via de system prompt bewust gretig gemaakt, gokt een stad en wil de weertool aanroepen. Vlak voor die aanroep leest Strands Decider het gesprek en de voorgestelde tool call, en beantwoordt twee vragen: komen deze argumenten uit iets wat de gebruiker effectief zei, en is het te vroeg om deze tool aan te roepen? Met een paar regels Python wordt dat een beslissing en vraagt de agent alsnog welke stad bedoeld is.
Dat verloopt via het intervention system van Strands. Een InterventionHandler met een before_tool_call methode geeft een getypeerde actie terug: Proceed, Deny, Confirm om een mens te laten bevestigen, of Guide, waarmee de agent feedback krijgt en opnieuw aan zet is. Wat er in die handler gebeurt, laat Strands volledig aan jou over. Je kunt er een decision model, een Cedar policy of een andere agent in plaatsen.
AWS benadrukt dat de vragen en drempelwaarden in dit voorbeeld met de hand gekozen zijn. De kern van het verhaal is dat een beslissing die zo goedkoop is, een plek krijgt waar een volledige LLM call te traag en te duur zou zijn. In de demo draait de decider lokaal, terwijl de agent zijn generatieve model via Amazon Bedrock aanspreekt. Er wordt gewerkt aan aparte libraries voor de integratie van decision models.
Accuracy, calibratie en latency in cijfers
AWS stuurt op drie doelen: hoe vaak het antwoord klopt, hoe betrouwbaar de confidence scores zijn en hoe snel het model beslist. Voor de eerste twee gebruikt het team de publieke set van JevBench, een externe benchmark voor deze klasse modellen, aangevuld met de Brier score voor calibratie.
- JevBench tiers: v19 beantwoordt alle taken in de easy tier correct, scoort 0,875 op standard en 0,505 op hard.
- Positie: derde van 33 in de 2B klasse, en eerste van 30 als je de modellen die net boven 2 miljard parameters zitten niet meetelt. Onder publieke modellen met een volledig beschikbaar trainingsrecept staat het bovenaan.
- Calibratie: op korte classificatietaken die het model nooit zag, zijn antwoorden met een confidence van 0,9 of hoger in ongeveer 95 procent van de gevallen juist. Daaronder raadt het team aan om te bevestigen of een mens in te schakelen.
- Latency: een mediaan van ongeveer 115 milliseconden per vraag op een Nvidia RTX 3090 en zo’n 153 milliseconden voor kleine taken op een M3 MacBook. De tijd stijgt ongeveer lineair met de lengte van de input.
Een open recept met onderzoeksdiscipline
Het sterkste punt van deze release is reproduceerbaarheid. Weights staan op Hugging Face, code, trainingsdata en scripts op GitHub, onder een Apache 2.0 licentie. Het volledige recept hertrainen duurt ongeveer 11 uur op één RTX 3090, of 1 uur en 10 minuten op acht H100’s.
Opvallend is de werkwijze. Sinds v9 legt het team vóór elke trainingsrun vast wat het verwacht en wanneer de run als mislukt geldt. Het resultaat wordt achteraf toegevoegd zonder de voorspelling aan te passen. De meeste runs haalden hun doel niet. V20 scoorde 169 van de 231 taken tegenover 168 voor v19, binnen de ruis, en vier voorspellingen faalden. V19 bleef daarom het referentiemodel. Wie zelf een experiment wil voorstellen, doet dat met zo’n preregistratie.
Het project ontstond als hobby van Amazon distinguished engineer Marc Brooker, die na de lancering van Jev zijn eigen versie bouwde. Toen die kort bovenaan de JevBench ranking voor zijn grootteklasse stond, werkte Strands Labs het uit tot een officiële release. Brooker tegen TechCrunch: “What originally piqued my interest in this class of models was that they make a perfect decider for a workflow step.”
Strands Decider 2B tegenover Jev
Op prijs ontstaat een paradox. Strands Decider kost niets om te downloaden, maar je betaalt zelf voor hardware of cloud compute. Jev rekent $0,042 per miljoen input tokens, wat neerkomt op $42 voor een miljard tokens. AWS gaf geen schatting van de operationele kost per request, dus of zelf hosten goedkoper uitvalt, hangt af van je infrastructuur. Ook de snelheid is moeilijk te vergelijken: TypeSafe meldt 70 tot 500 milliseconden end to end via de hosted service, AWS mat lokaal op heel andere hardware.
Waar Strands duidelijk wint, is controle. Je beslissingen blijven in je eigen omgeving, je kunt het model inspecteren en finetunen op je eigen policies. Jev blijft een API zonder publieke weights of trainingsrecept. Voorlopig biedt AWS geen hosted versie aan, wat voor productie een drempel is. Je beheert de inference dus zelf.
Waar je het model inzet
AWS en de community zien vooral succes bij taken die herhaaldelijk terugkomen in agentic workflows:
- model routing om de juiste LLM voor een taak te kiezen
- tool selection en het controleren van argumenten vóór een tool call
- triage van binnenkomende requests naar het juiste team
- guardrails zoals grounding checks en policy classificatie
- goedkope evaluaties van modeloutput
- hybride agents waarin de LLM de moeilijke beslissingen neemt en de decider de routinematige