Eleven Realtime is de nieuwe familie spraakmodellen waarmee ElevenLabs voice agents wil laten luisteren, denken en antwoorden in één beweging. De zwaarste versie, Max, begint gemiddeld na 0,57 seconden te praten en beantwoordt 98,8 % van een reeks gesproken redeneervragen juist. Geen ander model met zo’n score is sneller. Kijk je naar het aantal taken dat een agent echt afmaakt, dan eindigt Max wel onder Grok Voice 3.0 en Gemini 3.8 Live. Nederlands zit in het pakket, en een gesprek kost je volgens een eigen berekening zo’n 8 tot 10 dollarcent per minuut.
Wat Eleven Realtime is
ElevenLabs lanceerde Eleven Realtime op 20 oktober 2026 met twee modellen. Eleven Realtime v1 Mini is de standaard. Hij is gemaakt voor vlotte gesprekken tegen een lage prijs, zoals een assistent, een digitale leraar of een personage in een game. Volgens ElevenLabs volstaat Mini voor de meeste toepassingen. Eleven Realtime v1 Max redeneert eerst en antwoordt dan. Hij is bedoeld voor klantendienst, het kwalificeren van leads en gesprekken waarin de agent een proces volgt en meerdere tools aanroept.
Beide modellen spreken meer dan 90 talen en kunnen elk van de ruim 17.000 stemmen uit de bibliotheek van ElevenLabs gebruiken. De documentatie verwijst voor de talen naar de lijst van Eleven v4, en daar staat het Nederlands in.
Je gebruikt Eleven Realtime op twee manieren. In ElevenAgents, het agentplatform van ElevenLabs, kies je het model in een keuzelijst en zet je de agent op een telefoonlijn, een webwidget, WhatsApp of een contactcenter zoals Zendesk en Genesys. Kennisbank, guardrails, testscenario’s en monitoring zitten erbij. De tweede weg is de Realtime API, die praat zoals de API van OpenAI. De uitrol gebeurt geleidelijk. Zie je bij je agent de instelling voor de spraakmodus niet, dan heeft je werkruimte nog geen toegang.
Eén model? Een afgestelde cascade
ElevenLabs noemt Eleven Realtime “a new class of Speech to Speech models”. De productpagina zegt dat spraakherkenning, beurtwissel, taalmodel en stem samen als één systeem zijn afgesteld. De migratiegids voor OpenAI-gebruikers is duidelijker: Mini en Max zijn een cascade waarin elk onderdeel een apart model is, uitdrukkelijk geen fused model dat spraak rechtstreeks in spraak omzet. Welke modellen erin zitten, houdt ElevenLabs geheim.
Dat is meer dan een technisch detail. ElevenLabs verdedigde in maart 2026 zelf waarom een cascade betrouwbaarder is: tussen de stappen staat leesbare tekst, zodat je guardrails kan afdwingen, fouten kan terugvinden en een nieuwer taalmodel kan inwisselen. In dezelfde tekst gaf het bedrijf toe dat fused modellen intonatie en emotie beter bewaren. Eleven Realtime is dus de cascade van ElevenLabs, maar dan kant-en-klaar afgesteld.
In de documentatie van de Realtime-modellen staat wat ElevenLabs dan voor jou beslist: het taalmodel, hoeveel het mag nadenken, parallelle tool calls, het stemmodel, de expressieve modus en de spraakherkenner. Jij houdt de systeemprompt, het eerste bericht, de stem, de talen, de temperatuur via de API, je tools, je kennisbank en hoe gretig de agent het woord neemt, met timeouts en onderbrekingen.
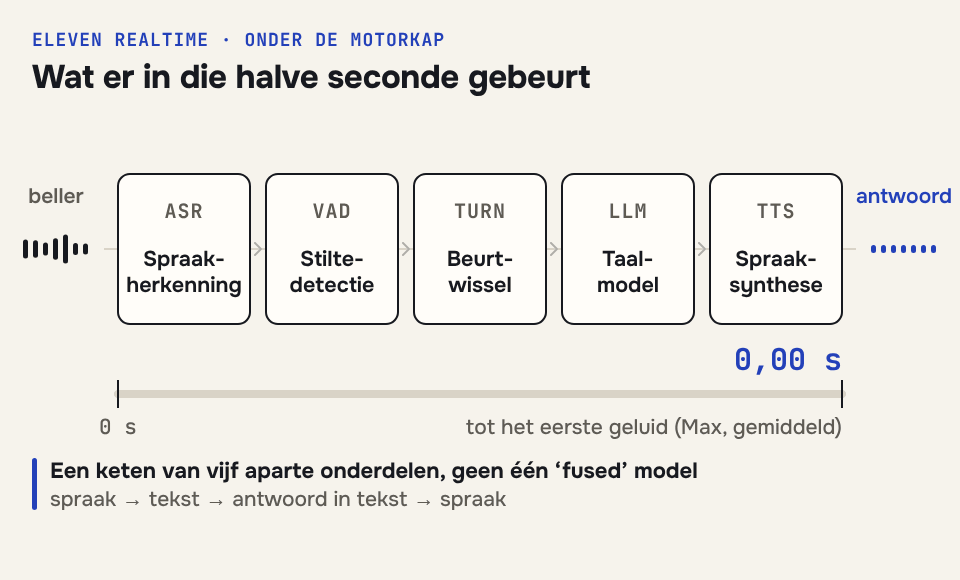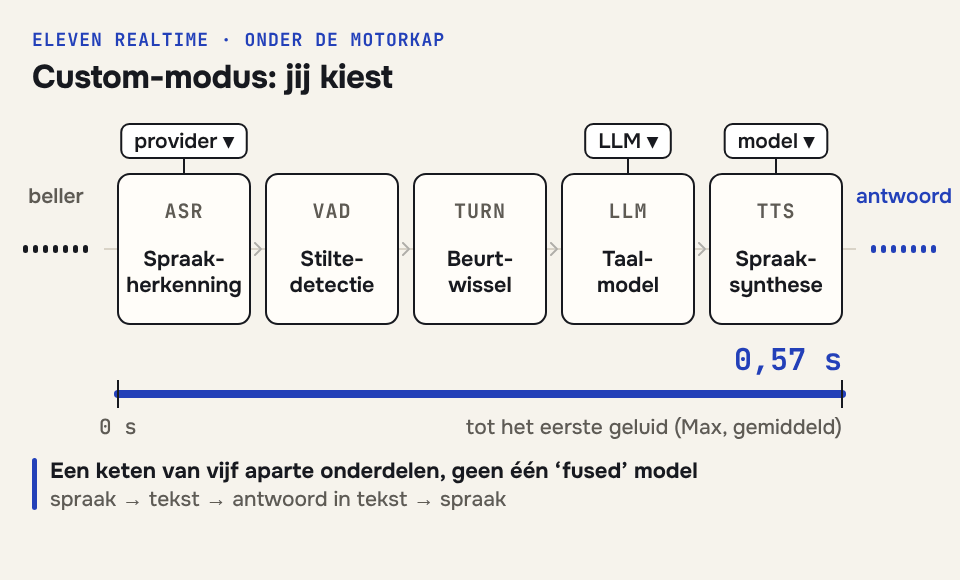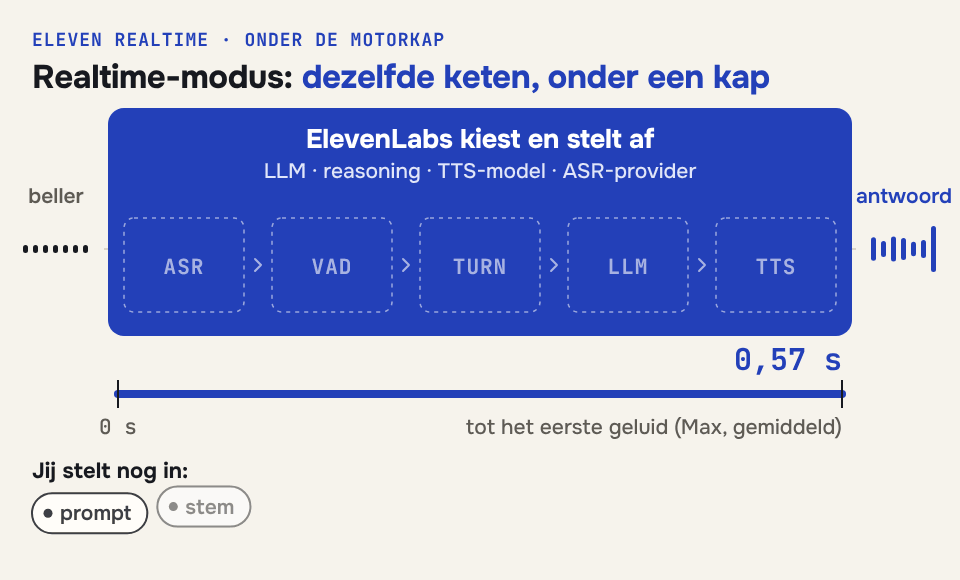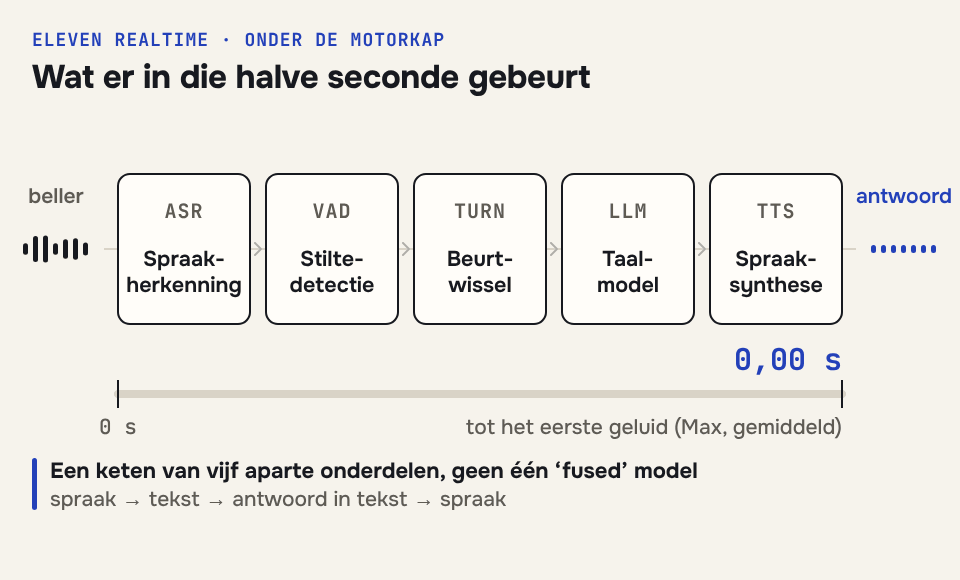
Je wint snelheid en spaart bouwwerk uit, want je moet zelf geen spraakherkenner, taalmodel en stem op elkaar afstemmen. Je verliest keuzevrijheid. Een eigen taalmodel of Amazon Bedrock kan niet in de Realtime-modus, je wisselt geen onderdeel uit, en bij een mislukt gesprek zie je alleen wat ElevenLabs in zijn monitoring toont. The New Stack merkt op dat nog niet duidelijk is hoeveel diagnose-informatie je krijgt.
Snel en slim, maar niet de beste afmaker
De cijfers die ElevenLabs aanhaalt, komen van Artificial Analysis, een onafhankelijk testbureau. Zo staan Mini en Max naast de sterkste concurrenten, op 21 oktober 2026:
| Model | Eerste audio | Gesproken redeneren | Taken afgerond | Beurtwissel | Blinde voorkeur |
|---|---|---|---|---|---|
| Eleven Realtime v1 Max | 0,57 s | 98,8 % | 87,1 % | 94,1 % | 997 |
| Eleven Realtime v1 Mini | 0,62 s | 75,9 % | 60,3 % | 95,8 % | 988 |
| Grok Voice 3.0 | 0,81 s | 98,5 % | 94,8 % | 97,0 % | 1064 |
| Gemini 3.8 Live | 1,18 s | 92 % | 93,2 % | 96,1 % | 1078 |
| GPT-Live-1, Sol low | 1,24 s | 89 % | 90,9 % | 97,3 % | 1047 |
Gesproken redeneren is Big Bench Audio, met 1.000 gesproken vragen. Beurtwissel is Full-Duplex-Bench: pauzes, onderbrekingen en een “mm-hmm” dat geen beurt is. Blinde voorkeur is de Elo-score in de Speech Agent Arena, waar mensen gesprekken vergelijken zonder te weten met welk model ze praten.
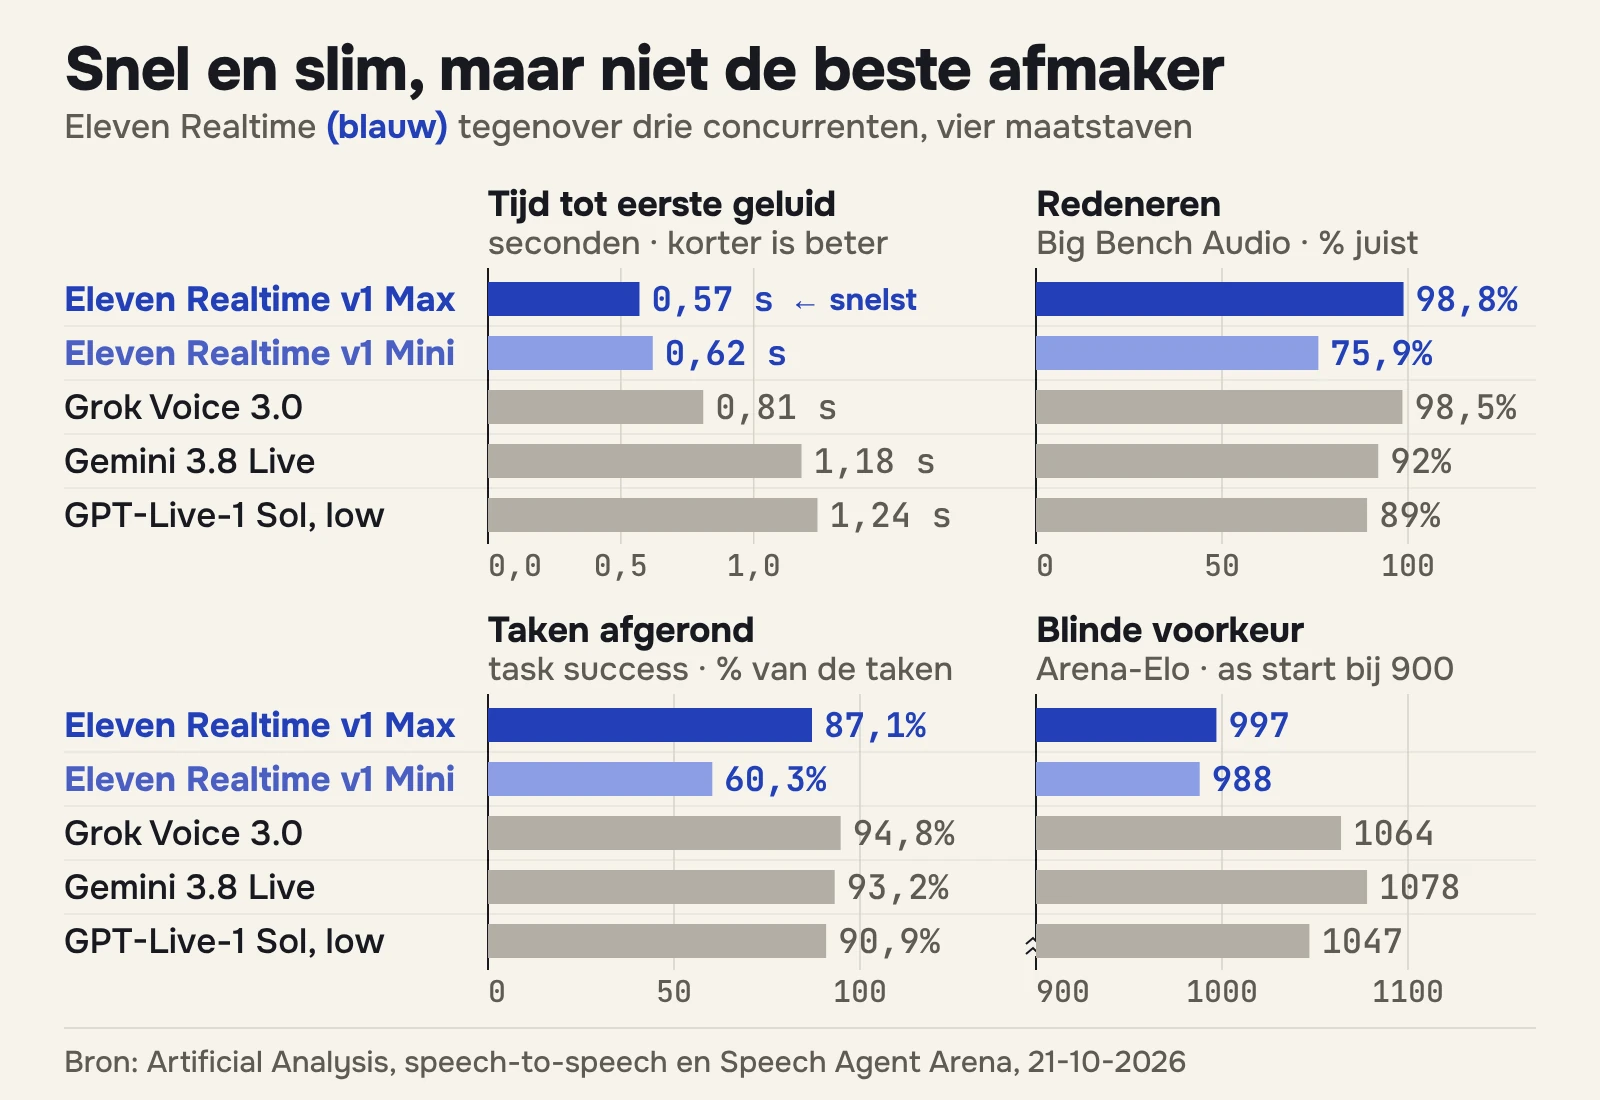
De claim van ElevenLabs dat geen model sneller én accurater is, klopt voor het redeneren. Het enige snellere model, Deepslate Opal met 0,44 seconden, haalt 85 %. Maar een voice agent moet ook iets gedaan krijgen, en daar haalt Max 87,1 % tegen 94,8 % voor Grok Voice 3.0. Mini rondt maar 60,3 % van de taken af en is dus niets voor gesprekken met veel tools. Op beurtwissel doet Mini het wel iets beter dan Max.
In de blinde Arena staat Max op plaats 9, met 997 punten nauwelijks boven de oude standaardcascade van ElevenLabs Agents met 994. Een algemene index-score krijgen Mini en Max nog niet, omdat de agenttest τ-Voice ontbreekt. Op die index leidt Grok Voice 3.0 met 86,9.
Wat Eleven Realtime kost
Op de prijspagina van ElevenLabs staat de prijs al, ook al melden veel berichten dat hij onbekend is. Je betaalt per minuut verbonden audio en per token, met deze bedragen op 21 oktober 2026:
| Realtime v1 Mini | Realtime v1 Max | |
|---|---|---|
| Verbonden audio | $0,08 per minuut | $0,08 per minuut |
| Inputtokens | $0,20 per miljoen | $1,80 per miljoen |
| Outputtokens | $6,00 per miljoen | $9,00 per miljoen |
| Boven je limiet aan gelijktijdige gesprekken | $0,16 per minuut | $0,16 per minuut |
| Richtprijs per minuut, eigen berekening | ongeveer $0,084 | ongeveer $0,102 |
Hoeveel tokens een gespreksminuut verbruikt, zegt ElevenLabs niet. De richtprijs is daarom een eigen berekening. Op het prijsniveau dat bij gewone agents overeenkomt met het Pro-plan van $99 per maand, rekent ElevenLabs op ongeveer 1.179 minuten Mini of 971 minuten Max bij typisch gebruik. Gedeeld door die minuten kom je op 8,4 en 10,2 dollarcent. Max is per minuut dus ongeveer 21 % duurder. Het verschil kan wegvallen als Mini een taak vaker opnieuw moet proberen.
Naast de concurrentie is Eleven Realtime niet goedkoop. In de testmeting van Artificial Analysis kost een uur invoeraudio $4,80, net als bij Grok Voice 3.0. Gemini 3.8 Live doet hetzelfde voor $0,84.
Mini of Max kiezen
Begin met Mini voor eenvoudige gesprekken: een onthaal, een vraag-en-antwoord, een oefenpartner. Kies Max als de instructies lang zijn, als de agent meerdere tools na elkaar aanroept, of als je Zero Retention Mode of HIPAA nodig hebt. Die twee bestaan alleen voor Max, in de Amerikaanse en Europese omgeving. Beide modellen draaien met Europese dataresidentie. In India en Singapore is alleen Mini beschikbaar.
Houd rekening met drie beperkingen. Een Realtime-agent kan alleen doorverbinden naar een andere Realtime-agent, tussen Mini en Max mag dat wel. Een eigen taalmodel kan je niet koppelen. En Max vraagt een tokenlimiet van minstens 1.024 of geen limiet.
Overstappen vanaf OpenAI Realtime
De Realtime API gebruikt dezelfde events en hetzelfde WebSocket-transport als de Realtime API van OpenAI. Je kan de SDK van OpenAI blijven gebruiken en past het endpoint aan naar wss://api.elevenlabs.io/v1/convai/realtime en de modelnaam naar eleven_realtime_v1_mini of eleven_realtime_v1_max. Je backend maakt een kortlevend client secret aan, zodat je API-sleutel nooit in de browser komt.
Helemaal gratis is de overstap niet. Er is alleen WebSocket, dus een app op WebRTC moet van transport wisselen. De SDK regelt audio alleen bij WebRTC, waardoor je zelf PCM16-audio op 24 kHz opneemt en afspeelt. Telefonie, WhatsApp, de kennisbank en monitoring zitten niet in de kale API, alleen in ElevenAgents. Toch is dit het belangrijkste nieuws voor wie bouwt: als je voice agent dezelfde taal spreekt bij meerdere leveranciers, wordt wisselen goedkoper. Dat past in de les uit modellen huur je, je context is van jou.
Wat je zelf test voor je kiest
ElevenLabs publiceert geen cijfers voor het Nederlands, en de benchmarks zeggen niets over gesprekken via een gewone telefoonlijn. Test daarom zelf:
- Nederlands en Vlaams met eigen opnames, ook met tussentaal en namen van straten of producten. Bij Voxtral 3 van Mistral zagen we hoe groot dat verschil kan zijn.
- Een echte telefoonlijn, want gecomprimeerde audio en extra vertraging tellen mee.
- Je eigen tool-flow, een afspraak boeken of een bestelling opzoeken, tientallen keren na elkaar.
- Onderbrekingen: iemand die halverwege de zin begint te praten of alleen “ja” zegt.
- De kost per afgerond gesprek, niet per minuut.
- De logs van een gesprek dat misloopt: zie je genoeg om de oorzaak te vinden?
Zet je de agent in voor klanten in Europa, dan geldt sinds 2 augustus 2026 artikel 50 van de AI Act. Wie met een AI-systeem praat, moet dat weten, tenzij het overduidelijk is. De digitale omnibus stelde die plicht niet uit. Laat het eerste bericht van je agent het dus gewoon zeggen.
Veelgestelde vragen over Eleven Realtime
Kan je Eleven Realtime gratis testen?
Ja. Op het kleinste niveau van de prijstabel, dat overeenkomt met het gratis plan, rekent ElevenLabs op ongeveer 14 minuten Mini of 12 minuten Max. Omdat de uitrol geleidelijk gebeurt, heeft nog niet elke werkruimte toegang.
Werkt Eleven Realtime met de SDK van OpenAI?
Ja. Je gebruikt @openai/agents-realtime via WebSocket en past alleen het endpoint en de modelnaam aan. WebRTC wordt niet ondersteund.
Verstaat Eleven Realtime Vlaams?
Nederlands staat in de taallijst, maar ElevenLabs geeft geen foutpercentages voor Nederlands of Vlaams. Test met opnames van je eigen klanten voor je live gaat.
Is Eleven Realtime echt speech-to-speech?
Voor jou wel: er gaat spraak in en er komt spraak uit. Binnenin is het volgens de documentatie een cascade van afzonderlijke modellen die ElevenLabs voor jou kiest en afstemt.
De duurste minuut is die zonder resultaat
Een kwart seconde sneller antwoorden dan Grok merkt een beller misschien. Een taak die niet afraakt, merkt hij zeker. In de test van Artificial Analysis maakt Grok Voice 3.0 per honderd taken er bijna acht meer af dan Max. Elk gesprek dat strandt, kost je de minuten én een medewerker die het overneemt. Reken dus in afgeronde gesprekken. Dan kan het snelste model het duurste blijken, of net het goedkoopste als het in het Nederlands goed scoort.