Trajectory wil dat je AI-model elke week beter wordt van het werk dat je experts er al mee doen. Herschrijft een advocaat een memo van de AI of corrigeert een analist een waardering, dan wordt dat een trainingssignaal. Het open model achter je toepassing wordt daarop bijgetraind, getest en opnieuw uitgerold. De jonge startup haalde op 2 november 2026 45 miljoen dollar op onder leiding van Sequoia, tegen een waardering van 300 miljoen dollar, en zette tegelijk zijn platform open.
Het idee heet continual learning. Een model bijtrainen op eigen data kon al langer. Nieuw is wie de lat legt, waar het signaal vandaan komt en hoe vaak het kan. Hieronder lees je hoe het platform werkt, welke drie technische ideeën het mogelijk maken, wat de eerste resultaten zeggen en waar je kritisch moet blijven.
Waarom AI-modellen vandaag niet bijleren van hun werk
Een taalmodel is na zijn training bevroren. Je kan het een betere prompt geven of documenten meegeven, maar de gewichten veranderen niet doordat je ermee werkt. Een correctie die een gebruiker vandaag maakt, is morgen vergeten. Medeoprichter Arjun Karanam noemt het in het manifest van Trajectory vreemd dat het slimste wat we ooit bouwden, niet slimmer wordt van gebruik.
CEO Ronak Malde vergelijkt een taalmodel met een heel slimme doctoraatsstudent die altijd opnieuw aan een nieuwe job begint. Slim genoeg, maar wat de economie waardeert, is iemand die dertig jaar in die job zit. Medeoprichter Michael Elabd zei eerder al dat agents vandaag episodisch werken: een taak afwerken, feedback krijgen en dan weer van nul beginnen.
De ervaring die ontbreekt, zit nochtans in elk product. Een gebruiker die een antwoord aanpast, opnieuw vraagt of een voorstel weggooit, vertelt precies wat er misliep. Zulke edits, undo’s en retries zijn volgens Karanam betere signalen dan een duim omhoog of omlaag, die veel ruis bevat. Dat zegt hij in een podcast van Sequoia. Trajectory bouwt de infrastructuur om dat signaal op te vangen en er training van te maken.
Wie zit er achter Trajectory
Trajectory werd ongeveer een jaar geleden opgericht door drie studiegenoten van Stanford. Ronak Malde werkte bij Windsurf en hoorde bij de onderzoekers die Google DeepMind daar overnam. Michael Elabd was onderzoeker bij DeepMind en Arjun Karanam werkte bij Apple aan generatieve foundation models. Het team telt een achttiental mensen, met onderzoekers en ontwerpers van onder meer OpenAI, Meta, Stripe en Netflix.
In mei haalde het bedrijf al 15 miljoen dollar op bij onder meer Conviction en Bessemer, met Jeff Dean en Fei-Fei Li als investeerders. De nieuwe ronde wordt geleid door Sequoia, met Nvidia, Bessemer en Bain Capital Ventures. Als klanten noemt Trajectory Harvey voor juridisch werk, Rogo voor financiële analyse, Decagon voor klantenservice, en verder Clay, Mercor en Nvidia.
Zo werkt het platform, stap voor stap
Trajectory bundelt wat vroeger vier aparte systemen waren: sandboxes waarin een agent werkt, evaluaties, training en uitrol. In de documentatie draait alles rond een handvol begrippen.
- Je koppelt je agent. Je toepassing blijft op je eigen infrastructuur draaien. Je stuurt de modelaanroepen via Trajectory en logt per poging een score. Volgens het bedrijf vraagt dat ongeveer vijf regels code.
- Je legt vast wat goed is. Dat heet een spec: een reeks taken, de harness waarin de agent werkt en een grader die elke poging scoort. Heb je nog geen grader, dan verzamel je eerst traces en bepaal je het leersignaal later.
- Het platform verzamelt signalen. Elke poging levert een trace op, met wat het model deed en welke tools het gebruikte, en telemetrie over hoe de gebruiker reageerde. Die combinatie noemt het bedrijf een trajectory, vandaar de naam.
- Je traint. Met één klik start een training met reinforcement learning op een open basismodel. Je kiest onder meer het tokenbudget, het aantal beurten, de redeneerinspanning en het RL-algoritme.
- Je vergelijkt. Elk tussenresultaat wordt getest op taken die het model tijdens de training niet zag, en naast andere modellen gezet.
- Je rolt uit. Het beste checkpoint wordt het model dat je agent gebruikt, na je eigen evaluaties en goedkeuring. Daarna begint de lus opnieuw.
Wie zo’n lus zelf bouwt met een machine-learningteam, is maanden bezig. Karanam schat het eigen werk van een klant op een kwartier, de trainingstijd niet meegerekend. Dat is de belofte achter de titel van de lanceringspost, Own your value function: jij bepaalt wat goed is, het platform doet de rest. Eén klant trainde zo in twee weken meer dan acht modellen voor lange, complexe agenttaken.
Drie ideeën die Trajectory anders maken
Wat Trajectory vernieuwt, zit in drie problemen die continu bijleren tot nu toe tegenhielden. Het bedrijf publiceerde er de voorbije maanden onderzoeksnotities over, met methode en cijfers. De twee belangrijkste verschenen bij de lancering.
1. De expert schrijft de beloning, zonder duizenden labels
Reinforcement learning heeft een beloningsfunctie nodig die elke poging een score geeft. Voor code kan een test dat. Voor een juridisch memo of een kredietanalyse is de maatstaf het oordeel van een expert, en dat verschilt van kantoor tot kantoor. Per taak een rubriek met criteria schrijven is traag. Trajectory rekent voor dat 10.000 taken van elk een halfuur zo’n 5.000 uur expertwerk kosten. En als het soort taken verschuift, verouderen die criteria.
De oplossing heet Continual Grading. In plaats van per taak een beoordelaar te maken, leert het systeem een metagrader: een programma van prompts en code rond een vast beoordelingsmodel, dat voor elke nieuwe taak zelf een beoordelaar schrijft. Een sterk model stelt kandidaten voor op basis van een kleine set taken die experts al beoordeelden. De kandidaat die het vaakst dezelfde rangorde maakt als de expert, wint. Omdat het resultaat een leesbaar programma is en geen nieuw neuraal netwerk, kan een expert het nalezen en bijsturen.
De cijfers zijn veelbelovend maar nog bescheiden. Op τ³-Bench, een benchmark voor klantenservice en bedrijfsprocessen, was een set van 60 gelabelde taken genoeg om 80% van de paren antwoorden in dezelfde volgorde te zetten als de expert. Een model dat met die metagrader trainde, ging van 80,0 naar 84,9% op de echte beoordeling. Met de originele beoordelaars van de benchmark haalde het 87,8%. Een algemene beoordelaar van één zin leverde in 40.000 pogingen nagenoeg geen verbetering op.
2. Leren uit één poging, zoals in het echt
De populairste RL-methode voor taalmodellen, GRPO, laat het model dezelfde taak een aantal keer uitvoeren, bijvoorbeeld acht keer. Het gemiddelde van die scores is de maatstaf: een poging die beter doet dan het gemiddelde, wordt versterkt. Dat werkt in een testomgeving die je telkens kan resetten. In productie kan dat niet. Een klantgesprek, een API die intussen veranderde of het dossier van een echte cliënt speel je niet acht keer opnieuw af.
Trajectory bouwt daarvoor op FlashREINFORCE, een recente methode die uit één poging per taak leert door te vergelijken met het gemiddelde van de hele batch. Elke taak krijgt dan dezelfde maatstaf, hoe makkelijk of moeilijk ze ook is. Group Size 1, kortweg GS1, verfijnt dat: als maatstaf neemt het een gewogen gemiddelde van de scores op andere taken in dezelfde batch. Taken wegen zwaarder als het huidige model er naar verwachting ongeveer even goed op scoort, en dat leidt het af uit wat je vooraf al weet, zoals de prompt. Zo is er geen apart critic-model nodig, zoals bij de oudere methode PPO.
Op AutomationBench deed GS1 het even goed als GRPO, met acht keer zoveel verschillende taken per trainingsstap. FlashREINFORCE, met één gemiddelde voor de hele batch, zakte daar bij een hogere leersnelheid in elkaar, van 21,7 naar 7,2%, terwijl GS1 stabiel bleef. Op LABBench2 steeg de score van GS1 op achtergehouden taken van 63 naar 68% en bleef daar. Het bedrijf zegt er zelf bij dat de winst afhangt van hoe goed je vooraf kan inschatten hoe moeilijk een taak is.
3. Goedkoop genoeg om vaak te doen
Continu bijleren heeft alleen zin als een trainingsronde betaalbaar blijft. Trajectory zet daarom in op kleinere open modellen. Het onderzoeksteam bouwde samen met UC Berkeley en Anyscale ook een systeem dat meerdere LoRA-trainingen tegelijk op dezelfde GPU’s laat lopen. Bij LoRA train je een kleine adapter in plaats van alle gewichten. In een test met acht experimenten was de hele reeks 2,8 keer sneller klaar dan wanneer ze na elkaar liepen.
Daarnaast stuurt het bedrijf op intelligence density: hoeveel een model presteert per gegenereerd token. Na een eerste trainingsronde had een klein Nemotron-model zo’n 90.000 tokens per juridische taak nodig voor tien geslaagde taken. Een tweede ronde bracht dat terug naar 37.000 tokens voor dezelfde tien, zonder verlies in score. Met zulke kleine, zuinige modellen wordt het volgens Trajectory haalbaar om per klant elke nacht bij te trainen, in plaats van één keer per kwartaal voor iedereen.
Wat het oplevert, in cijfers
De meeste resultaten komen van Harvey LAB, een open benchmark van het juridische AI-bedrijf Harvey met bij de lancering in mei ruim 1.200 taken in 24 rechtsdomeinen. Volgens Trajectory zijn het er intussen 2.010. Een agent moet bijvoorbeeld een dataroom met contracten doornemen en een memo schrijven over een overname. Een taak telt pas als geslaagd als alle criteria van de rubriek kloppen, en dat zijn er soms meer dan vijftig. Daarom liggen de percentages laag.
| Model op Harvey LAB | Voor training | Na training op Trajectory |
|---|---|---|
| Nemotron 3.5 Lightning, open, 30 miljard parameters | 0% | 8,3% |
| Nemotron 3 Ultra, open, 550 miljard parameters | minder dan 1% | 5,8% |
| Nemotron 3 Super, open, 120 miljard parameters | minder dan 1% | 3,3% |
| Claude Opus 4.6, gesloten, ter vergelijking | 6,6% | niet trainbaar |
| Claude Sonnet 4.6, gesloten, ter vergelijking | 4,2% | niet trainbaar |
Voor de basisscore van Ultra meldde Trajectory in juni 0% en in augustus 0,8%. Het kleinste model, Nemotron 3.5 Lightning, ging van 0 naar 8,3% en klopte daarmee Claude Opus 4.6 op dezelfde taken. Negen van de 24 rechtsdomeinen gingen erop vooruit, geen enkel achteruit. Bij Nemotron 3 Ultra steeg het aandeel geslaagde criteria van 52 naar 83%, vlak onder Sonnet 4.6 en Opus 4.6 met elk 85%. Trajectory trainde dat model binnen 24 uur na de release door Nvidia, met hetzelfde recept als voor Super.
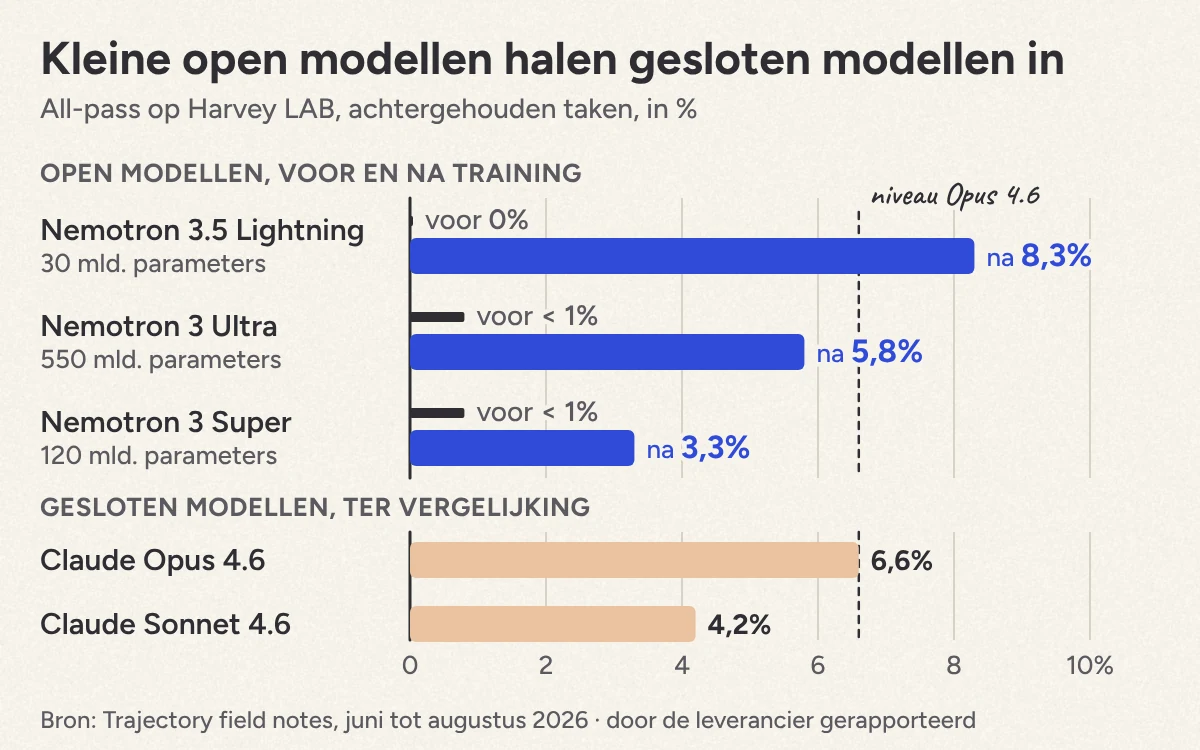
In de lanceringspost gaat het bedrijf nog een stap verder: de 8,3% van Lightning zou gelijk zijn aan de score van Claude Opus 5.5, tegen een honderd keer lagere kost en 3,8 keer sneller. Die vergelijking staat niet in de onderliggende onderzoeksnota, en we vonden er geen onafhankelijke bevestiging van. Alle cijfers komen van Trajectory, op één benchmark, met maar een handvol taken per rechtsdomein. Het toont dat de methode op deze benchmark werkt, niet dat elk bedrijf dezelfde sprong maakt.
Wat het kost en welke modellen je kan trainen
Trajectory traint alleen open modellen. Op de prijspagina staan begin november elf trainbare modellen, van Nemotron 3.5 Lightning tot GLM 5.3. Je betaalt per miljoen tokens, met aparte tarieven voor invoer, gegenereerde tokens (sampling) en training. Een uitgerold model betaal je aan de tarieven voor invoer en sampling. Een greep uit de lijst:
| Model | Training per miljoen tokens | Sampling per miljoen tokens |
|---|---|---|
| Nemotron 3.5 Lightning | $0,88 | $0,54 |
| Qwen 3.6 35B | $2,05 | $1,29 |
| Nemotron 3 Super | $2,55 | $1,58 |
| Nemotron 3 Ultra | $10,96 | $6,85 |
| GLM 5.3 | $14,00 | $11,66 |
Gesloten modellen zoals GPT-6 Astra en Claude Opus 5.5 kan je op het platform gebruiken om mee te vergelijken of als beoordelaar, niet om te trainen. Daarbovenop betaal je rekenkracht voor de sandboxes en opslag voor je traces.
Hoe Trajectory zich verhoudt tot Tinker en Applied Compute
Trajectory is niet de enige die bedrijven hun eigen model wil laten trainen. Tinker van Thinking Machines Lab, het bedrijf van ex-OpenAI-CTO Mira Murati, is een API om open modellen te trainen met LoRA en RL. Daar schrijf je de trainingslus en de beloning zelf, dus het is gemaakt voor onderzoekers en ML-teams. Tinker is tegelijk concurrent en bouwsteen: volgens de documentatie van Trajectory draaien uitgerolde modellen op trainingsstatus in Tinker, en Thinking Machines noemt Trajectory als gebruiker. Applied Compute bouwt trainings- en inferentie-infrastructuur voor bedrijven en werd volgens TechCrunch onlangs op 3,25 miljard dollar gewaardeerd. Prime Intellect biedt een platform om agents te bouwen en te trainen.
Het verschil zit in wie aan het stuur zit. Trajectory mikt niet op het ML-team maar op de advocaat, de analist of de supportverantwoordelijke die weet wat een goed antwoord is. Het platform neemt de omgevingen, de training en de uitrol over. Of dat in de praktijk zo eenvoudig is als beloofd, moet de self-serve versie nog bewijzen. Wie wil zien hoeveel post-training kan uitmaken, vindt een voorbeeld bij GLM-5.3, dat op hetzelfde basismodel tot de helft beter scoorde op code.
Waar je kritisch moet blijven
- Veel is nog beta. Continual Grading en GS1 zijn een research preview, en het opvangen van productietraces en telemetrie staat in de documentatie als private beta. Wat iedereen nu kan, is trainen op een spec met eigen taken en een beoordelaar. De knop op de site verwijst ook nog naar een wachtlijst.
- Je data gaat naar een Amerikaans platform. Prompts en antwoorden uit je toepassing lopen via Trajectory. Het privacybeleid van de website vermeldt doorgifte naar de VS en andere landen, maar niet de AVG. Voor data die Trajectory voor klanten verwerkt, verwijst het uitdrukkelijk naar het klantcontract. Karanam zegt dat Trajectory voor klanten met strikte data-afspraken kan werken met synthetische data die de verdeling van hun data nabootst, in plaats van rechtstreeks op die data te trainen. Leg vast wat voor jou geldt, zeker als er persoonsgegevens of vertrouwelijke dossiers in je traces zitten. Wie model en data in Europa wil houden, leest best ook onze analyse van Mistral Large 4 als soevereine optie.
- Wie bepaalt wat goed is? Als vijf advocaten een memo elk anders verbeteren, leert het model een gemiddelde dat niemand koos. Experts die AI-output corrigeren, doen bovendien werk dat in geen enkele planning staat. Spreek af wie de lat legt en wie de rubrieken nakijkt.
- Wat neem je mee als je vertrekt? Bijgetrainde gewichten van een open model klinken als eigendom, maar zonder je specs, beoordelaars en traces kan je weinig verder. Vraag vooraf of je die kan exporteren.
- De mens in de lus moet echt kijken. Elabd ziet het menselijke oordeel als veiliger dan systemen die zichzelf verbeteren zonder toezicht. Dat werkt alleen als iemand de updates nakijkt voor ze live gaan. Het platform voorziet daarvoor evaluaties en een goedkeuringsstap voor elke uitrol.
Veelgestelde vragen over Trajectory
Wat is continual learning?
Een AI-model dat na de lancering blijft bijleren uit echt gebruik, in plaats van bevroren te blijven tot de volgende versie. Bij Trajectory worden correcties, herhaalde vragen en het oordeel van experts een beloning waarop het model regelmatig wordt bijgetraind.
Is dit hetzelfde als fine-tuning?
Het is een vorm van post-training, maar met reinforcement learning in plaats van alleen voorbeelden na te bootsen, en als doorlopend proces: verzamelen, beoordelen, trainen, testen en uitrollen.
Kan ik Trajectory gebruiken om ChatGPT of Claude bij te trainen?
Nee. Je traint open modellen zoals Nemotron, Qwen en GLM. Gesloten modellen van OpenAI en Anthropic kan je op het platform wel inzetten om mee te vergelijken of als beoordelaar.
Kan ik het vanuit België gebruiken?
Het platform is self-serve, met een wachtlijst. Er is geen regiobeperking vermeld, maar ook geen Europese hosting, en leren uit productieverkeer is nog private beta. Check dus eerst waar je data verwerkt wordt en wat het contract zegt over training op je gegevens.
Het echte product is de lat die je legt
Trajectory verkoopt geen slimmer model, maar een manier om een gewoon open model jouw maatstaf te leren. Daarmee verschuift de vraag. Welk model het beste is, wordt minder belangrijk dan of je kan opschrijven wat goed werk is in jouw bedrijf. Wie heldere rubrieken heeft, goede voorbeelden bijhoudt en experts tijd geeft om te corrigeren, haalt het meeste uit continual learning. Daar kan je vandaag al mee beginnen, ook als je Trajectory nooit gebruikt.