Simon Willison gaf een taalmodel op zijn laptop 17.253 kommagetallen, zonder uitleg over wat ze betekenden. Na 52 minuten nadenken kwam het antwoord: dit netwerk speelt Breakout, met 88 procent zekerheid. Het klopte. Dat is weight-space programming in zijn eenvoudigste vorm: een AI-model dat de ruwe gewichten van een ander neuraal netwerk leest, en soms ook herschrijft, zonder training.
De term komt uit een onderzoek van MIT dat deze week veel stof deed opwaaien. De korte versie: grote taalmodellen kunnen kleine netwerken verrassend goed lezen en zelfs van nul schrijven. De opvallendste claim, een klein Qwen-model dat zes keer beter werd in wiskunde, blijkt vooral een reparatie van een lusprobleem, gedaan met code en testruns. Hieronder lees je wat er echt gebeurde, waar de kritiek op slaat en hoe je de test zelf herhaalt.
Wat is weight-space programming?
Een neuraal netwerk is een lange lijst getallen, de gewichten. Normaal pas je die alleen aan met training: je toont voorbeelden, berekent de fout en laat een optimizer de getallen stap voor stap bijstellen. Weight-space programming slaat dat over. Een taalmodel krijgt de gewichten als tekst, leest ze en past ze rechtstreeks aan op basis van een opdracht in gewone taal.
De term komt van Rikiya Takehi, Jayden Teoh, Alex Zhang en Omar Khattab van MIT CSAIL, in hun blogpost Sparks of Weight-Space Programming van 2 november 2026. Zhang en Khattab schreven eerder ook mee aan Recursive Language Models. Voor hun experimenten gebruikten ze GPT-6 Astra van OpenAI. Ze noemen de resultaten zelf “sparks”: vroege tekenen, geen afgewerkte techniek. Een peer-reviewed paper is er nog niet, wel volledige logs op GitHub.
Hoe leest een taalmodel welk spel een netwerk speelt?
In het eerste experiment trainden de onderzoekers vier kleine netwerken op vereenvoudigde versies van Breakout, Pong, Pac-Man en Freeway. Elk spel speelt zich af op een raster van 10 op 10 vakjes, en elk vakje heeft vijf kanalen: de speler, bewegende objecten, beloningen, obstakels en het vorige beeld. Dat geeft 500 invoerwaarden, gevolgd door twee lagen van 32 neuronen en vijf mogelijke acties. Alles samen zijn dat 17.253 gewichten.
GPT-6 Astra kreeg die getallen als tekst, zonder de naam van het spel en zonder tools of code. Bij alle vier de netwerken noemde het model het juiste spel.
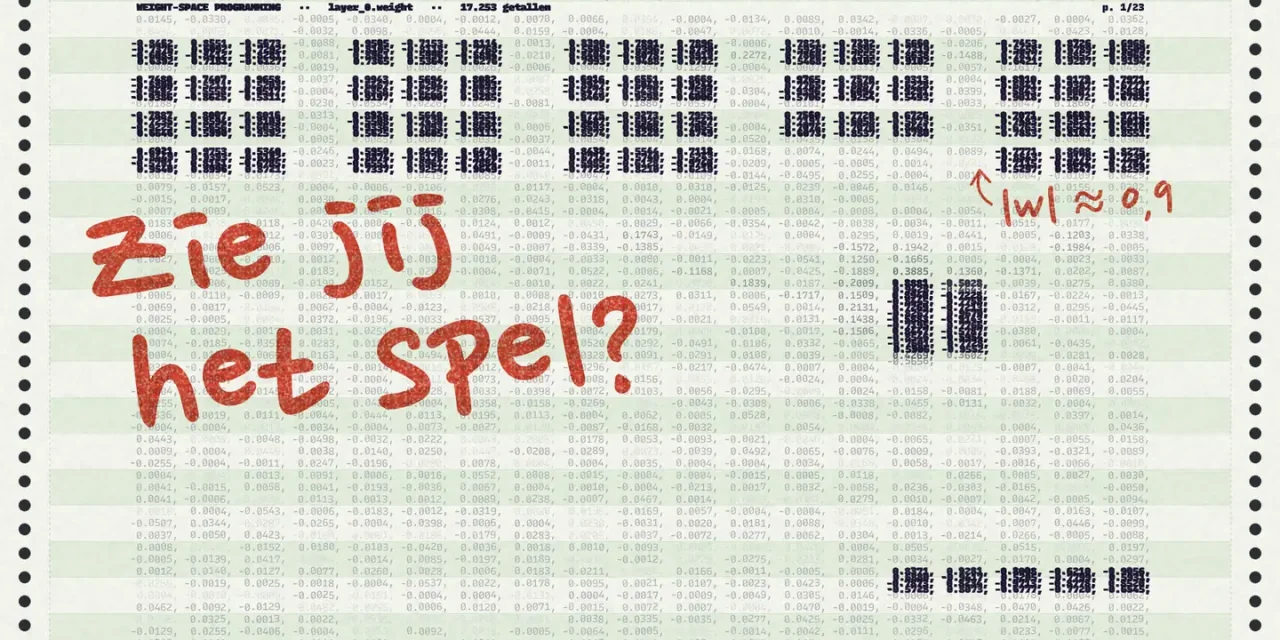
Hoe kan dat? Software-ingenieur Sean Goedecke legt het uit. De prompt vertelt welke invoerwaarde bij welk vakje en welk kanaal hoort. Wie dan per vakje kijkt hoe groot de gewichten zijn, krijgt een warmtekaart van het speelveld. Bij het Breakout-netwerk lichten de onderste speelrij (waar de paddle schuift) en de bovenste rijen (waar de stenen liggen) op. Wij rekenden dat na met de gepubliceerde gewichten: het patroon zit er echt in, zoals de animatie hierboven toont.
Dat maakt de prestatie niet minder knap, wel begrijpelijker. Een ervaren ML-onderzoeker met pen, papier en veel geduld komt tot hetzelfde besluit. Het model doet het in zijn redenering, over ruim 110.000 tekens aan getallen.
Een laptopmodel kan het ook
Simon Willison wilde weten of je daarvoor een frontiermodel nodig hebt. In zijn test van 3 november gebruikte hij exact dezelfde prompts uit de logs, met zijn command-line tool LLM. Kimi K3.1 Pro herkende Breakout in 9 minuten en 41 seconden. Daarna probeerde hij Qwen 3.8 27B, een open model van Alibaba dat lokaal draait in een gekwantiseerde versie van ongeveer 17 GB.
| Netwerk | Antwoord van Qwen 3.8 27B | Zekerheid | Denktijd |
|---|---|---|---|
| Breakout | Breakout of een Arkanoid-achtig spel | 88% | 52 min 25 s |
| Pong | Pong-achtig spel met paddle en bal | 75% | 1 u 4 min 54 s |
| Pac-Man | Pac-Man-achtige wereld met een doolhof van 8 op 8 | 72% | 46 min 12 s |
| Freeway | liep nog bij publicatie | – | – |
Drie op drie dus, voor een model dat op een goed uitgeruste laptop past. Willison vindt de redeneringen leuk om door te bladeren, maar bijna onleesbaar. Dat het lukt met een model dat je zelf draait, zegt veel: de leestaak is geen geheime vaardigheid van één frontierlab, maar iets wat een sterk redenerend model met genoeg tijd kan uitpuzzelen. Hoeveel geheugen je voor zo’n model nodig hebt, lees je in onze test van de MacBook Pro M6 voor lokale AI.
Welke hulp kreeg het model in elk experiment?
Het onderzoek bevat acht experimenten, en daar zit het hele debat. Lees je alleen de samenvatting, dan lijkt het alsof GPT-6 Astra overal hetzelfde deed: naar getallen kijken en begrijpen. In werkelijkheid kreeg het model per experiment heel verschillende hulp.
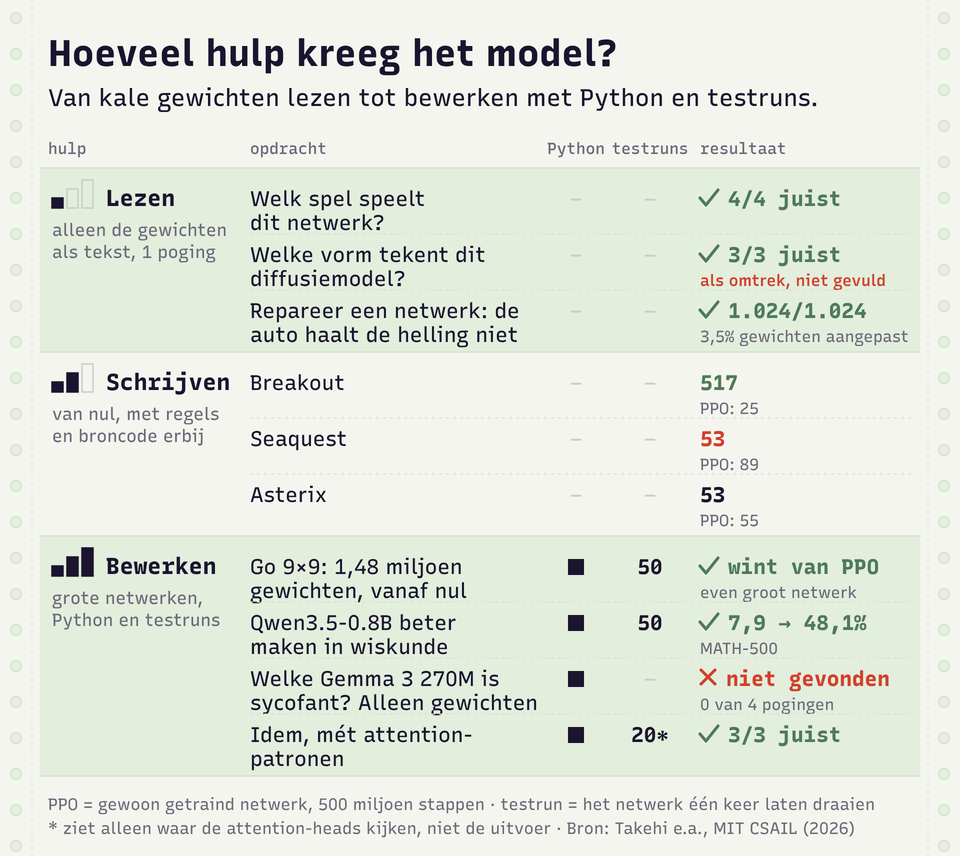
- Lezen, zonder tools. Welk spel een netwerk speelt (4 op 4), welke vorm een klein diffusiemodel tekent (3 op 3, al tekende Astra omtrekken waar het model gevulde vormen maakt), en een netwerk repareren dat een autootje niet over een helling kreeg. Astra paste 3,5 procent van de 171.664 gewichten aan, in één poging, en daarna lukte het in alle 1.024 testritten.
- Schrijven, zonder tools of testruns. Astra schreef netwerken voor drie vereenvoudigde Atari-spellen (de MinAtar-versies) van nul, startend van gewichten die allemaal nul waren. In Breakout haalde het 517 punten, tegen 25 voor een netwerk dat 500 miljoen stappen met de gangbare methode PPO getraind was. In Seaquest (53 tegen 89) en Asterix (53 tegen 55) verloor het nipt of duidelijk.
- Bewerken, met Python en testruns. Een Go-netwerk van 1,48 miljoen gewichten, het Qwen-model en het opsporen van een sycofantisch Gemma-model. Hier mocht Astra code draaien en het netwerk tot 50 keer laten rekenen. Het sycofantische model vond het uit de gewichten alleen niet, in geen van de vier pogingen. Pas met de attention-patronen lukte het.
Het schrijfexperiment is misschien het verrassendste. Een netwerk dat een spel speelt, rechtstreeks in getallen uittikken, zonder het één keer te laten spelen, is iets wat een mens niet zomaar doet.
Waarom de Qwen-score van 7,9 naar 48,1 procent sprong
De claim die het meest gedeeld werd: Astra maakte Qwen3.5-0.8B veel beter in wiskunde door 0,016 procent van de gewichten aan te passen. De score op MATH-500 steeg van 7,9 naar 48,1 procent, op GSM8K van 13,8 naar 67,1 procent, en IFEval verdrievoudigde bijna.
Het verhaal achter die cijfers is eenvoudiger. Het kleine Qwen-model loopt in denkmodus vaak vast in een lus. Qwen waarschuwt daar zelf voor op de modelpagina, en het model staat standaard in de modus zonder denken. In de test raakte 93 procent van de antwoorden de limiet van 32.768 tokens, en een afgebroken antwoord telt als fout. Astra schreef met Python teksten die wel en niet in een lus gingen, vond één richting in de MLP-lagen 15 en 19 die het lusgedrag droeg, en trok die af van 64 kolommen per laag. Dat zijn 131.072 gewichten.
Na de ingreep raakte nog 33,1 procent van de antwoorden de limiet. Meer antwoorden die afraken, betekent meer juiste antwoorden. De onderzoekers geven dat zelf eerlijk toe: bij Gemma 3 270M, dat geen lusprobleem heeft, steeg de score van 6,8 naar hooguit 7,7 procent. Hun conclusie is dat zo’n ingreep een obstakel kan wegnemen, maar geen vaardigheid toevoegt die het model niet had.
De techniek zelf is bekend. Een gedragsrichting zoeken en wegfilteren heet directional ablation, bekend sinds onderzoek uit 2024 dat toonde hoe één richting de weigeringen van een chatbot bepaalt. Tools zoals Heretic gebruiken het om de censuur uit open modellen te halen. Het bewerkte Qwen-model staat op Hugging Face onder Apache 2.0, en een onafhankelijke herhaling op de volledige MATH-500 kwam uit op 51,0 procent.
Waarom critici van een goocheltruc spreken
Matthew Honnibal, de maker van spaCy, noemt de voorstelling misleidend. Zijn vergelijking: een goochelaar doet dezelfde truc vaak op verschillende manieren, zodat het publiek denkt dat er één verklaring is. Het onderzoek zet drie verschillende werkwijzen onder één noemer, en een lezer gaat ervan uit dat de Qwen-winst ook “gewoon door naar de gewichten te kijken” kwam. Dat klopt niet: elk experiment met een echt taalmodel gebruikte Python, en het Qwen-resultaat ook testruns. Honnibal ontkent niet dat het resultaat interessant is. Een jaar of twee geleden konden modellen zo’n ML-taak niet zelfstandig uitvoeren.
Goedecke gaat verder: niets hiervan is bovenmenselijk. Een bekwame onderzoeker zou bij het Qwen-model exact hetzelfde doen. In fora als Tildes en r/LocalLLaMA komen nog twee bedenkingen terug. De leestaak werkt omdat de prompt een kaart van de invoer meegeeft, en wat op speelgoednetwerken lukt, hoeft niet op te schalen naar modellen met miljarden gewichten. Ook het idee dat dit recursive self-improvement is, houdt weinig stand: hier repareert een groot model een klein model, het verbetert zichzelf niet. Meer over dat begrip lees je in onze uitleg over recursive self-improvement.
Wat je er vandaag mee kan
Voor de meeste bedrijven verandert er morgen niets. Wie een model wil aanpassen, gebruikt nog altijd fine-tuning, en dat blijft de betrouwbare route. Toch zijn er drie dingen die je nu al kan doen.
- De test zelf herhalen. Installeer LLM en een lokale modelserver zoals LM Studio, laad een sterk redenerend model en geef de prompt mee met de optie
-f, die een prompt van een URL kan halen. Willison moest het contextvenster ver boven de standaard 8.192 tokens zetten, want de prompt is ruim 110.000 tekens lang, en hij verhoogde de time-out. Reken op drie kwartier tot een uur per vraag met een model van 27B. - Kleine modellen nakijken. Het onderzoek toont dat een taalmodel een klein netwerk kan doorlichten op wat het geleerd heeft. Voor kleine classificatie- of controlemodellen in je eigen bedrijf is dat een goedkope tweede blik, zolang je het resultaat zelf controleert.
- Een specifiek gebrek wegnemen. Loopt een klein open model vast in lussen of in één ongewenst gedrag, dan is het zoeken en wegfilteren van een richting goedkoper dan hertrainen. Een frontiermodel als assistent maakt dat toegankelijker, maar het blijft vakwerk dat je met testen afsluit.
De vraag is wat het model te zien kreeg
Dat een taalmodel betekenis haalt uit 17.253 kale getallen, is opvallend, en dat het met een laptopmodel ook lukt, nog meer. Toch zit het interessantste stuk van dit verhaal in de kleine lettertjes: bij elk resultaat hangt de waarde af van wat het model kreeg, een kaart van de invoer, een Python-omgeving, vijftig testruns. Willison zelf trekt dezelfde grens. Hij vindt het onderzoek boeiend, maar is niet klaar om broncode af te schrijven of te geloven dat de toekomst bestaat uit onleesbare machines die hun eigen gewichten bewerken. Wie de volgende claim over weight-space programming leest, stelt dus best eerst één vraag: met welke hulp?
Veelgestelde vragen over weight-space programming
Is weight-space programming hetzelfde als fine-tuning?
Nee. Fine-tuning past gewichten aan met training: voorbeelden, een foutmaat en een optimizer. Bij weight-space programming leest een taalmodel de gewichten en past het ze rechtstreeks aan, zonder gradiënten. In de experimenten werkte dat voor kleine netwerken en voor één gerichte reparatie, niet als vervanging van training.
Kan ChatGPT of Claude zijn eigen gewichten lezen?
Nee. Een chatbot heeft geen toegang tot zijn eigen gewichten. In het onderzoek kreeg GPT-6 Astra de gewichten van een ander, veel kleiner netwerk als tekst in de prompt. Een groot taalmodel heeft miljarden gewichten, veel te veel voor één prompt.
Kan ik het zelf proberen?
Ja. De prompts staan in de openbare logs op GitHub. Met de LLM-tool en een lokaal model zoals Qwen 3.8 27B in LM Studio kan je de leestest herhalen, met een groot contextvenster en wat geduld. Het bewerkte Qwen3.5-0.8B-model kan je downloaden van Hugging Face.
Kan AI zich hiermee zelf verbeteren?
Niet volgens deze resultaten. Een groot model repareerde een klein model, en de grootste winst kwam van het wegnemen van een lusprobleem. De onderzoekers noemen toepassingen zoals zelfverbetering, auditing en het samenvoegen van modellen zelf voorstellen, geen geteste resultaten.