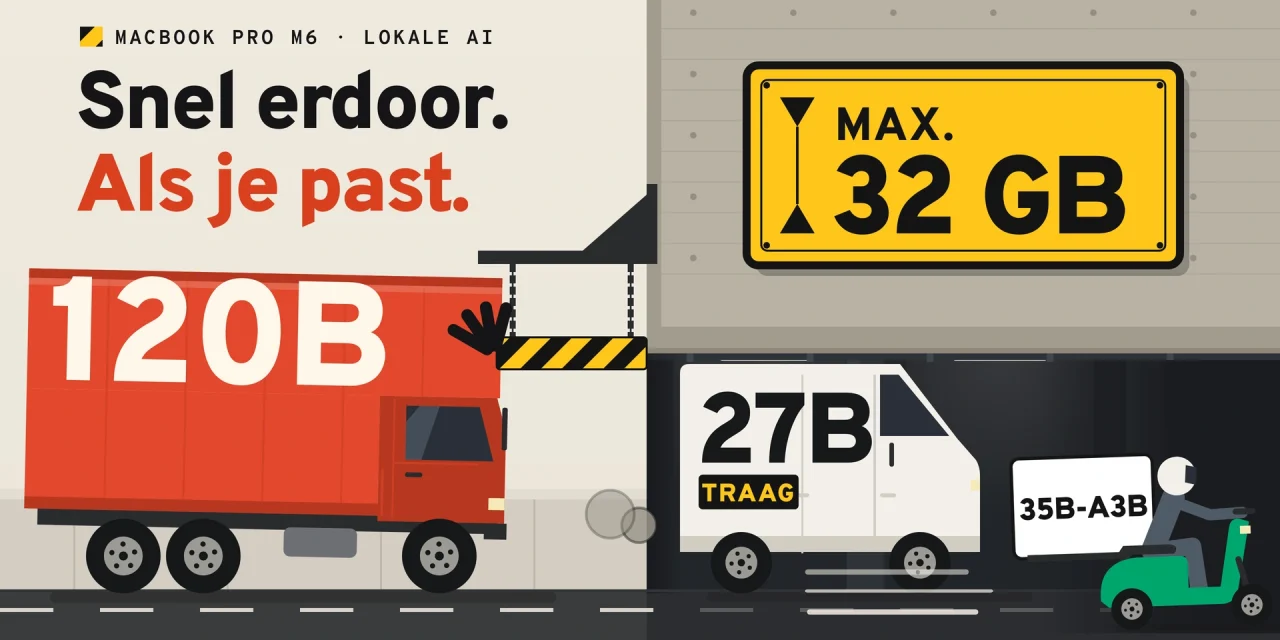
Ja, de nieuwe 14-inch MacBook Pro met M6 draait AI-modellen vlot op je eigen laptop, tot zo’n 35 miljard parameters. Hij leest je prompt drie tot vier keer sneller dan een M4 en schrijft een antwoord aan ongeveer 8 tot 70 tokens (woordstukjes) per seconde, afhankelijk van het model. Maar het geheugen stopt bij 32 GB. Wil je grotere modellen draaien, dan kom je bij de nieuwe MacBook Pro met M5 Pro of M5 Max uit, en die kost een flink stuk meer.
Hieronder lees je wat Apple deze week precies aankondigde, waarom geheugen belangrijker is dan de chip, welke modellen in 16, 24 en 32 GB passen en hoe snel ze echt draaien. De cijfers komen uit metingen op de Mac mini M6, die dezelfde chip heeft en al sinds september te koop is.
Wat Apple op 27 en 28 oktober aankondigde
Apple stelde op 27 oktober de 14-inch MacBook Pro met M6 voor. Het is de instapper van de Pro-reeks en vervangt het model met M5. De chip heeft 12 CPU-kernen en 12 GPU-kernen, twee meer dan de M5, en wordt gebakken op 2 nanometer. In elke GPU-kern zit een Neural Accelerator, een rekeneenheid voor AI, en er is een dubbele Neural Engine van 16 kernen.
Een dag later volgde een volledig nieuwe MacBook Pro met OLED-touchscreen in 14 en 16 inch. Die gebruikt geen M6 maar de M5 Pro en M5 Max, met tot 128 GB geheugen. Volgens MacRumors verdwijnen de oude modellen met M5 Pro en M5 Max uit de winkel. Een M6 Pro of M6 Max is er nog niet.
| MacBook Pro 14″ M6 | MacBook Pro M5 Pro (OLED) | MacBook Pro M5 Max (OLED) | |
|---|---|---|---|
| Geheugen | 16, 24 of 32 GB | tot 64 GB | tot 128 GB |
| Geheugenbandbreedte | 153 GB/s (16 GB) of 170 GB/s | 307 GB/s | tot 614 GB/s |
| Grootste model dat comfortabel past (4-bit) | ongeveer 30 à 35B | 50 à 70B (70B is krap) | ongeveer 120B |
| Thunderbolt | 4 | 5 | 5 |
| Prijs | vanaf € 2.329 (Nederland) | vanaf $ 2.899 (14″) | vanaf $ 4.499 (14″) |
De M6-laptop is vanaf 28 oktober te bestellen en ligt op 6 november in de winkel. iCulture noteert in Nederland € 2.329 voor 16 GB geheugen en 1 TB opslag, € 220 extra voor 24 GB en € 440 extra voor 32 GB. In Frankrijk start hij bij € 2.299. Een Belgische prijs vonden we nog niet, maar die ligt meestal op het Nederlandse niveau. In Apples persbericht staan voor de OLED-modellen alleen Amerikaanse prijzen.
Waarom het geheugen beslist, niet de chip
Een taalmodel lokaal draaien gebeurt in twee fases, en die vragen iets anders van je computer.
Eerst leest het model je prompt. Dat is rekenwerk, en daar blinkt de M6 uit. De Neural Accelerators in de GPU zijn gemaakt voor de matrixberekeningen die een taalmodel doet. Apple belooft een eerste woord tot 1,3 keer sneller dan op de M5 en tot 13 keer sneller dan op een M1. Bij een lange prompt, zoals een document van twintig pagina’s of een codebase, merk je dat meteen.
Daarna schrijft het model zijn antwoord, woord per woord. Voor elk nieuw woord (een token) moet de chip alle actieve gewichten van het model één keer uit het geheugen lezen. Hoe snel dat gaat, hangt af van de geheugenbandbreedte. Een vuistregel: deel de bandbreedte door de grootte van het model en je krijgt het maximale aantal tokens per seconde. Een model van 17 GB op een M6 met 170 GB/s haalt dus hooguit een tiental tokens per seconde.
En het model moet volledig in het geheugen passen. macOS geeft de GPU standaard ongeveer drie kwart van het werkgeheugen. De rest is voor macOS, je browser en je andere apps. Op 32 GB blijft er zo 21 à 24 GB over voor model en context. Je kan die grens optrekken met het commando sysctl iogpu.wired_limit_mb, maar Apple ondersteunt dat niet en je laptop wordt er trager van zodra hij moet swappen.
Daar zit de kern. De rekenkracht van de M6 ging flink vooruit, de bandbreedte nauwelijks: van 153 naar 170 GB/s. Volgens Apples specificaties krijgt het basismodel met 16 GB zelfs geen 170 GB/s, maar blijft het op 153 GB/s. Ter vergelijking: de M1 Max haalde in 2021 al 400 GB/s.
Hoe snel draait de M6 echt?
Onafhankelijke tests van de laptop zelf zijn er nog niet. Maar de Mac mini M6 heeft dezelfde chip en is sinds 22 september te koop. Daarop is al flink gemeten.
YouTuber Alex Ziskind zette de Mac mini M6 naast een Mac mini M4 met het model Qwen3.5-9B in 4-bit. De M6 las de prompt aan 742 tokens per seconde, tegenover 210 op de M4: 3,5 keer zo snel. Het eerste woord verscheen na 0,7 seconden in plaats van 2,5. Bij het schrijven van het antwoord was het verschil kleiner: 26,9 tokens per seconde tegenover 18, zo meldt Wccftech. Een beeld maken met Flux duurde 36 seconden in plaats van 94. De Mac mini M6 verbruikte zo’n 38 watt, tegenover 44 voor de M4.
Een uitgebreidere test staat op GitHub: zestien modellen op een Mac mini M6 met 32 GB, in LM Studio, gemeten op 3 en 4 oktober. Het patroon is duidelijk.
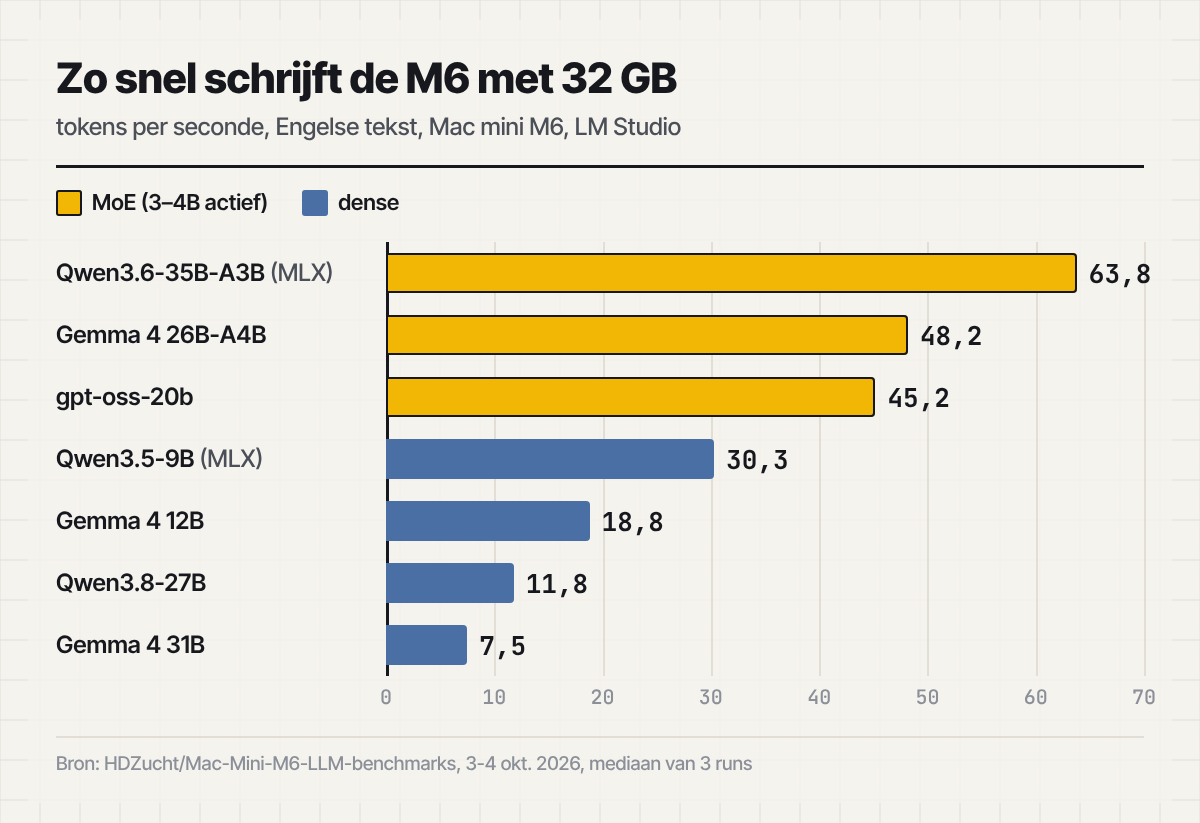
- MoE-modellen vliegen. Een mixture-of-experts-model gebruikt per token maar een klein deel van zijn parameters. Qwen3.6-35B-A3B, met 35 miljard parameters waarvan 3 miljard actief, haalde in MLX-formaat 63 tot 69 tokens per seconde. gpt-oss-20b en Gemma 4 26B-A4B zaten rond 45 tot 53.
- Grote dense modellen kruipen. Qwen3.8-27B haalde 11 tot 12 tokens per seconde bij gewone tekst, Gemma 4 31B nog geen 8. Dat is leesbaar, maar je wacht wel op elk antwoord.
- Speculatieve decoding helpt bij voorspelbare tekst. Met een klein hulpmodel dat woorden voorspelt, steeg Qwen3.8-27B naar 45 tot 68 tokens per seconde bij code en JSON. Bij gewone tekst was de winst bescheidener: van ongeveer 11 naar 15 à 20 tokens per seconde.
Ook de gemeten bandbreedte valt lager uit dan Apple belooft. Ziskind mat met de STREAM-test 143 tot 145 GB/s op een M6 met 32 GB, meldt Starry Hope. Dat verklaart waarom dense 27B-modellen in deze tests rond 9 à 12 tokens per seconde blijven steken.
Een kanttekening. De Mac mini heeft een grote ventilator en ligt niet op je schoot. Of de MacBook Pro hetzelfde tempo volhoudt bij een lange taak, weten we pas na de eerste reviews. Bij de 14-inch met M5 Max zag Notebookcheck de CPU-prestaties met 24 procent zakken na een halfuur volle belasting. De M6 verbruikt veel minder, dus daar verwachten we minder problemen.
Welke modellen passen in 16, 24 en 32 GB?
Reken voor een model in 4-bit op ongeveer 0,6 GB per miljard parameters, plus ruimte voor de context. Hoe langer je gesprek of document, hoe meer geheugen die context vraagt.
| Geheugen | Ruimte voor de GPU | Wat comfortabel draait | Wat niet past |
|---|---|---|---|
| 16 GB (153 GB/s) | ongeveer 12 GB | Qwen3.5-9B, Gemma 4 12B, kleine agentmodellen | alles vanaf 20B (gpt-oss-20b past amper) |
| 24 GB (170 GB/s) | ongeveer 18 GB | gpt-oss-20b, Gemma 4 26B-A4B, 9B-modellen in 8-bit | Qwen3.6-35B-A3B, Qwen3.8-27B met lange context |
| 32 GB (170 GB/s) | ongeveer 24 GB | Qwen3.6-35B-A3B, Qwen3.8-27B, Gemma 4 31B, alle vorige | 70B-modellen, gpt-oss-120b |
Voor lokale AI is 32 GB dus de enige configuratie die echt zin heeft. Met 16 GB draai je alleen kleine modellen, en die hebben ook nog het tragere geheugen. Een 32 GB-model kost in Nederland € 2.769 met 1 TB opslag.
Let op als je ook andere zware programma’s open hebt. Model, context en apps delen hetzelfde geheugen: wie naast een taalmodel ook een beeldmodel of een 3D-programma draait, zit snel vol.
M6, M5 Pro of M5 Max?
Een M5 Pro heeft bijna dubbel zoveel bandbreedte als een M6, de M5 Max bijna vier keer zoveel. Dezelfde modellen schrijven daar dus twee tot vier keer sneller, en je kan veel grotere modellen laden.
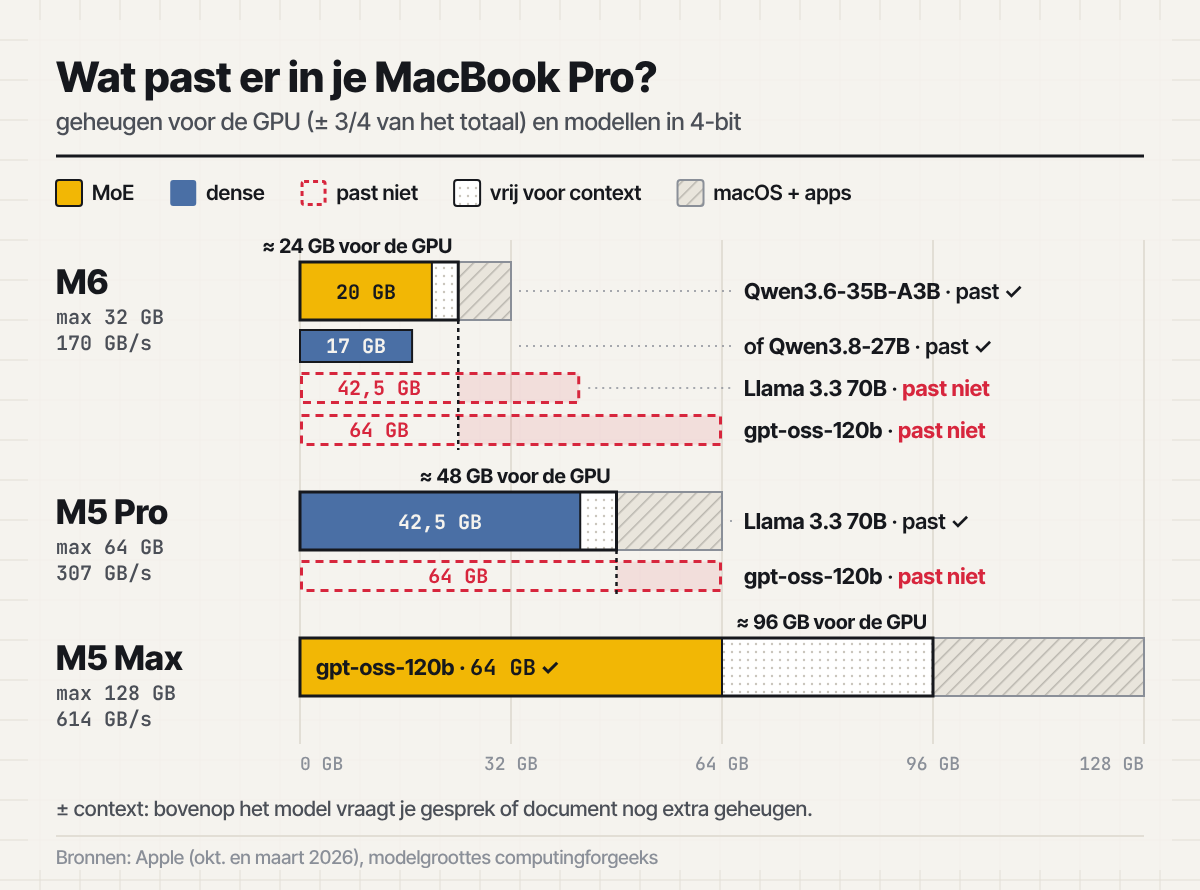
- Kies de M6 met 32 GB als je lokale modellen gebruikt naast je gewone werk: samenvatten, vertalen, code aanvullen, documenten doorzoeken die niet naar de cloud mogen. Een MoE-model van 30 à 35 miljard parameters doet dat vlot.
- Kies een M5 Pro met 64 GB als je een 70B-model wil laden, of een middelgroot model met een lange context naast Docker, een browser en je IDE.
- Kies een M5 Max met 128 GB als je modellen rond 120 miljard parameters wil draaien, zoals gpt-oss-120b. Volgens Apple draai je op een M5 Max zelfs taalmodellen met honderden miljarden parameters. Neem dan bij voorkeur de 16-inch: in de vorige generatie hield die zijn chip beter koel dan de 14-inch.
Wie meerdere Macs aan elkaar wil koppelen om een heel groot model te verdelen, heeft voor de snelle RDMA-verbinding die Apple gebruikt Thunderbolt 5 nodig. Apple toonde zo hoe vier Mac Studio’s samen het open model Muse Spark Open draaien. De MacBook Pro met M6 heeft alleen Thunderbolt 4.
Zoek je een Windows-laptop, dan biedt de nieuwe Nvidia RTX Spark N1X tot 128 GB geheugen met ongeveer 300 GB/s, vergelijkbaar met een M5 Pro, maar met een stevig prijskaartje.
Zo begin je met lokale AI op een M6
- Probeer eerst het model dat al op je Mac staat. macOS 27 heeft een ingebouwd taalmodel van Apple van ongeveer 3 miljard parameters. Je spreekt het aan met het commando
fmin de Terminal. Het is volgens Apple bedoeld voor samenvatten, informatie uit tekst halen en classificeren, niet voor redeneren of code. - Installeer LM Studio en kies modellen in MLX-formaat. MLX is Apples eigen framework voor machine learning en haalt op Apple Silicon vaak meer snelheid dan het GGUF-formaat van llama.cpp. Ollama werkt ook: sinds versie 0.40 van eind september draait het ondersteunde modellen zoals Qwen en Gemma standaard op zijn snellere MLX-motor. Bij de eerste versie in maart was daarvoor nog een Mac met meer dan 32 GB nodig.
- Kies een MoE-model. Op de M6 haal je met Qwen3.6-35B-A3B, gpt-oss-20b of Gemma 4 26B-A4B de beste verhouding tussen kwaliteit en snelheid.
- Houd de context in de gaten. Een model laden met een context van 128.000 tokens kan meer geheugen vragen dan het model zelf. Begin met 16.000 à 32.000 tokens.
- Sluit wat je niet nodig hebt. Elke gigabyte die Chrome of Slack inneemt, gaat af van je model.
Kijk voor je iets downloadt naar de geheugeneis. Het codeermodel Flint van Recursive weegt in 4-bit 23 GB, en Recursive mikt op Macs met minstens 48 GB. Op een M6 valt het dus af. Wil je lokale en cloudmodellen combineren, kijk dan naar Perplexity Hybrid Compute, dat taken verdeelt tussen je Mac en de cloud.
Veelgestelde vragen
Kan ik het geheugen van de MacBook Pro M6 later uitbreiden?
Nee. Het geheugen zit in de chipbehuizing. Wat je bij aankoop kiest, houd je voor het leven van de laptop. Twijfel je, neem dan 32 GB.
Is 16 GB genoeg om lokaal AI te draaien?
Voor kleine modellen tot ongeveer 12 miljard parameters wel. Maar de 16 GB-versie heeft ook trager geheugen (153 in plaats van 170 GB/s), en met een browser en een paar apps open blijft er weinig over.
Is de M6 sneller voor AI dan een M4 Pro of M3 Max?
Bij het lezen van prompts wel, dankzij de Neural Accelerators in de GPU. Bij het schrijven van antwoorden niet: een M4 Pro haalt 273 GB/s en een M3 Max tot 400 GB/s, ruim meer dan de 170 GB/s van de M6. Ben je vooral bezig met lange antwoorden van grote modellen, dan is een oudere Pro- of Max-chip met veel geheugen vaak de betere koop.
Kan ik een model als gpt-oss-120b op de M6 draaien?
Nee. Het model is in 4-bit ruim 60 GB groot en past niet in 32 GB. Daarvoor heb je een M5 Max met 128 GB nodig, of een Mac Studio.
Eerst het model kiezen, dan de Mac
De M6 maakt lokale AI sneller op het moment dat het je het meest opvalt: je stelt een vraag over een lang document en het antwoord begint meteen. Maar hoe groot je model mag zijn, beslis je op de dag dat je de laptop koopt. Bepaal dus eerst welk model je wil draaien. Past het in 24 GB, dan is de M6 met 32 GB een snelle en zuinige laptop voor lokale AI. Past het niet, dan bespaar je niets door de goedkoopste Pro te kopen. Hoe groot de beste open modellen ondertussen worden, zie je aan Muse Spark Open van Meta, dat zelfs in 4-bit nog zo’n 500 GB geheugen vraagt.