Nvidia heeft met Granary v2 een open dataset en data-curatiesysteem vrijgegeven van 463.062 uur spraak over 48 talen. De pijplijn leert spraak-AI iets waar klassieke modellen al jaren mee worstelen: dezelfde opname op verschillende manieren uitschrijven zonder dat je het model opnieuw moet trainen.
Wie een spraakmodel zoals Whisper of een commerciële transcriptietool gebruikt, kent het probleem. De ene keer wil je een letterlijk politieverslag met elke hapering, aarzeling en herhaling. De andere keer wil je een zakelijke vergadernotule waarin bedragen als getallen staan en alle stopwoorden zijn geschrapt. Tot nu toe moest een ontwikkelaar kiezen voor welk formaat hij trainde, of achteraf een groot taalmodel over de ruwe tekst laten gaan om de fouten op te schonen.
Granary v2 lost dat aan de basis op. Het systeem is gebouwd met Nvidia NeMo Curator en koppelt aan elke seconde audio verschillende tekstdoelen.
Drie versies van dezelfde zin
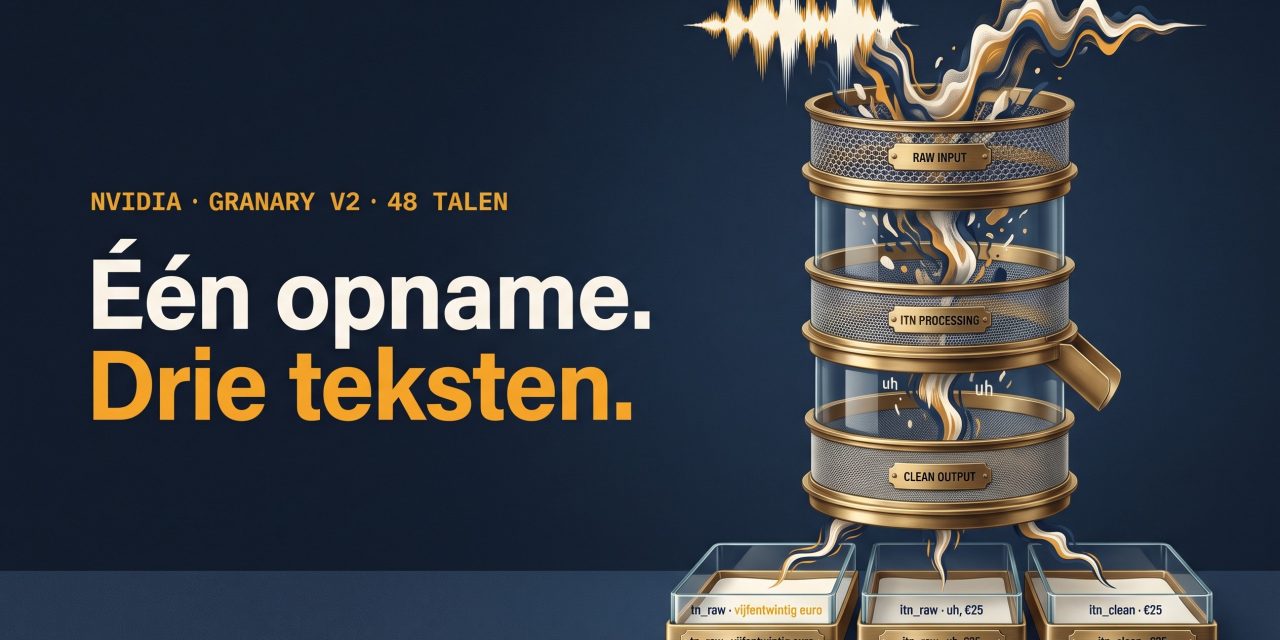
De kern van Granary v2 bestaat uit drie parallelle pijplijnen:
- Metadata-pijplijn: splitst lange opnames in korte segmenten, scheidt sprekers en detecteert de taal.
- ASR-labeling: controleert de uitspraak met taalspecifieke modellen en filtert slechte audio weg.
- Tekst-generatie: maakt automatisch drie uitlijningen per opname.
Die derde stap levert drie vaste stijlen op:
- tn_raw: de ruwe gesproken vorm waarin getallen voluit geschreven staan (“vijfentwintig euro”).
- itn_raw: inverse text normalization mét behoud van tussenwerpsels (“ik betaalde, uh, €25”).
- itn_clean: de opgeschoonde zakelijke versie (“ik betaalde €25”).
Door een model op deze drievoudige data te trainen, begrijpt het een directe tekstinstructie. Wie vraagt om een letterlijke transcriptie krijgt de eerste vorm. Wie vraagt om schone notulen krijgt de derde vorm.
De motor achter Nemotron 3.5 Transcribe
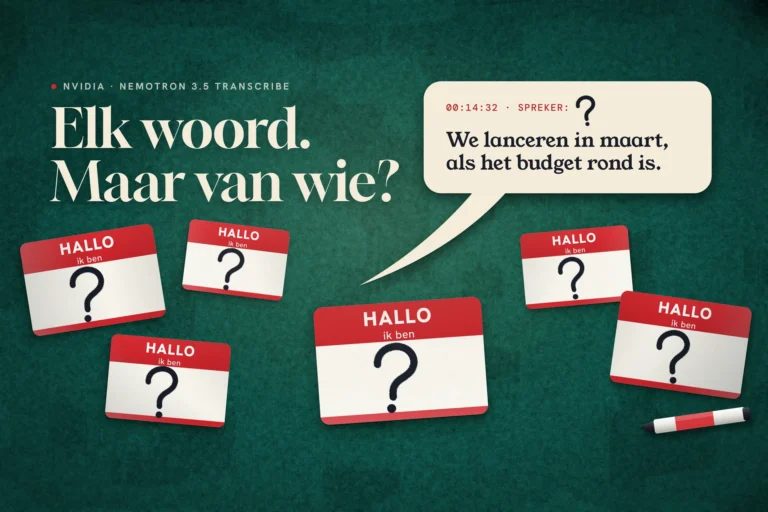
Granary v2 is niet zomaar een academische oefening. Het is het trainingsfundament achter het nieuwe Nemotron 3.5 Transcribe model van Nvidia. Dat open model van 34 miljard parameters (waarvan er per stap slechts 4,3 miljard actief zijn) haalt momenteel de hoogste open-weight score op de Hugging Face ASR Leaderboard met een Word Error Rate van 5,33%.
Uit benchmarks van Nvidia blijkt dat kwaliteitsfiltering zwaarder weegt dan pure uren. Door streng te filteren met NeMo Curator daalde het foutpercentage over negen benchmarks van 4,91% naar 4,67%, terwijl er minder trainingsstappen nodig waren.
Meer Europese talen, maar nog werk aan de winkel
Tegenover de eerste versie van Granary, die in 2025 verscheen met 25 Europese talen, breidt v2 uit naar 48 talen. Daarmee dekt de dataset alle 24 officiële EU-talen en regionale talen zoals Baskisch, Catalaans en Galicisch. Ook Nederlands is ruim vertegenwoordigd, zowel voor standaardspraak als voor vertalingen naar het Engels.
Toch blijven er grenzen. Granary v2 en Nemotron 3.5 zijn gebouwd voor opnames van afgewerkte audiobestanden tot één uur. Voor live streaming of real-time ondertiteling van een fysieke conferentie is de architectuur niet ontworpen. Ook is audio-Q&A (waarin je vragen stelt over een gesprek zonder eerst een transcript te lezen) momenteel alleen betrouwbaar getraind in het Engels.
Wat Belgische ontwikkelaars hieraan hebben
Nvidia stelt zowel de gegevensmanifesten als de volledige NeMo Curator-recepten beschikbaar onder een open licentie. De audiobestanden zelf download je rechtstreeks van de originele bronnen.
Voor bedrijven en ontwikkelaars die werken aan eigen spraaktools in gezondheidszorg, klantendiensten of juridische verslaggeving biedt Granary v2 een kant-en-klaar stappenplan. In plaats van tienduizenden euro’s uit te geven aan handmatige annotaties, kunnen teams hun eigen audio door de open pijplijn halen om modellen aan te passen aan vaktermen en lokale dialecten.