Amper twee weken nadat Gemini 4 Argon breed beschikbaar kwam, kondigde Google DeepMind op 28 oktober 2026 al zijn opvolger aan met Gemini 4 Carbon. Het nieuwe vlaggenschipmodel pakt meteen de eerste plaats op de vernieuwde Artificial Analysis Intelligence Index v5.0 met een score van 59, voor Claude Opus 5.5 en GPT-6 Astra. Toch heeft die lancering een dubbele bodem. Carbon levert een flinke sprong in meerdaagse programmeertaken, lange context en cyberbeveiliging voor vrijwel dezelfde prijs per taak als Argon, maar gewone ontwikkelaars en abonnees krijgen voorlopig geen toegang.
Waarom Google na veertien dagen al met een nieuw topmodel komt
Op 30 september stelde Google Gemini 4 Argon voor, waarna het model op 13 oktober openstond voor betalende gebruikers in de Gemini-app en de API. Veertien dagen later volgt Carbon al. Topman Sundar Pichai verwees bij de aankondiging met een knipoog naar het periodiek systeem en merkte op dat Google had beloofd om zijn modellen periodiek uit te brengen. Waar argon een edelgas is, staat koolstof bekend als het element dat onder extreme druk verandert in diamant.
Die vergelijking past bij de manier waarop Koray Kavukcuoglu, Senior Vice President bij Google DeepMind en Chief AI Architect bij Google, het model positioneert. Volgens Google is Gemini 4 Carbon specifiek getraind om onder hoge druk en bij dubbelzinnige instructies overeind te blijven. Interne teams bij Google lieten het model meerdere dagen aan een stuk draaien op complexe softwareproblemen. Waar veel AI-agents halverwege vastlopen of een taak voortijdig afbreken zodra een eerste poging mislukt, blijft Carbon doorzoeken in grote codebases en low-level-systemen tot het de echte oorzaak van een bug vindt en repareert.
Het korte interval van twee weken roept bij onafhankelijke analisten wel de vraag op wat er precies veranderd is. Een sprong van negen punten op de Intelligence Index in veertien dagen wijst erop dat Argon mogelijk een vroegere tussenstap uit dezelfde trainingslijn was, of dat Google met gerichte nabehandeling en reinforcement learning veel extra rendement uit de architectuur haalde. Google geeft in zijn evaluatiedocumentatie geen details vrij over het aantal parameters of de exacte trainingsduur.
Hoe Gemini 4 Carbon scoort tegenover Argon, Claude Opus 5.5 en GPT-6 Astra
Google publiceerde bij de lancering een vergelijkingstabel met zeventien benchmarks waarin Gemini 4 Carbon het opneemt tegen Gemini 4 Argon, OpenAI’s GPT-6 Astra, Anthropics Claude Opus 5.5 en Claude Fable 5.1. Carbon werd daarbij getest op de hoogste denkinstelling in de Gemini API, op basis van een enkele poging zonder meerderheidsstemming. Van die zeventien onderdelen wint Carbon er vijftien.
| Benchmark en domein | Gemini 4 Carbon | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| AA Intelligence Index v5.0 | 59 | 50 | 58 | 57 |
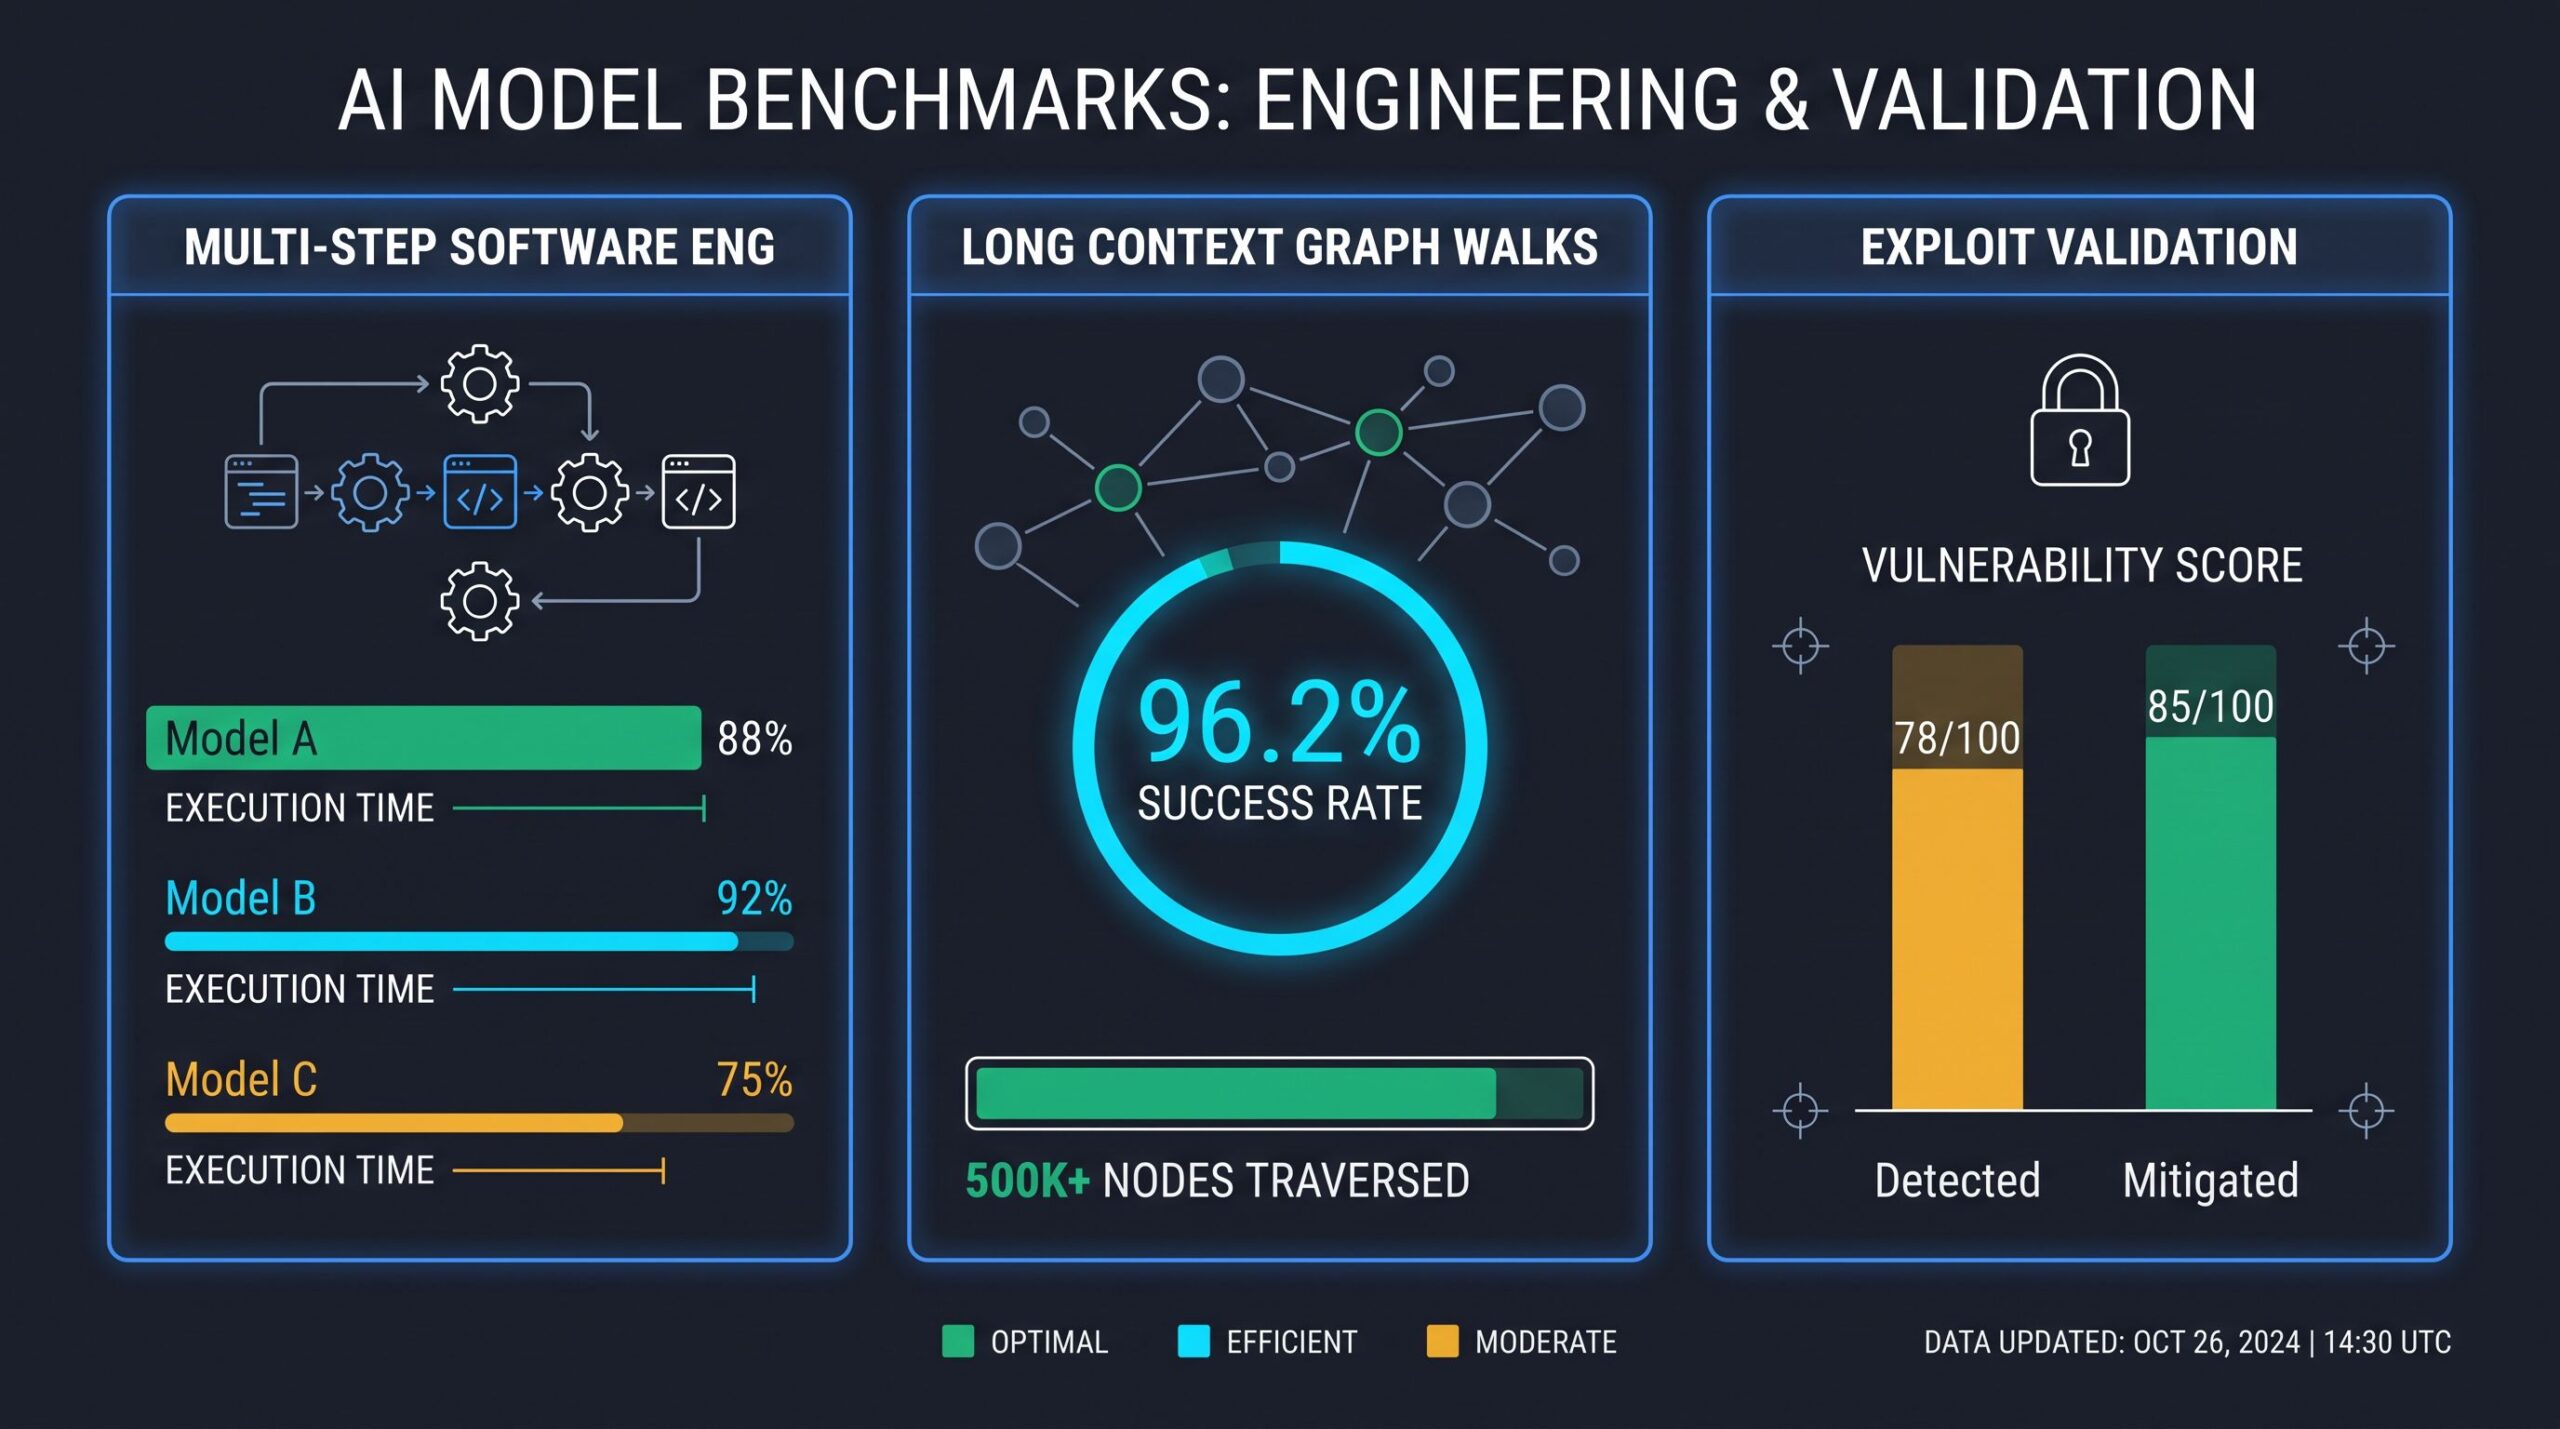
| GraphWalks 256k tot 1M tokens | 96,2% | 84,2% | 66,8% | 71,8% |
| Terminal-Bench 4.0 | 65,2% | 57,1% | 59,6% | 59,1% |
| SWE-sweep | 9,6% | 4,3% | 3,6% | 9,5% |
| FrontierSWE 2 | 61,2% | 55,0% | 62,3% | 65,5% |
| Agents’ Last Exam v1.1 | 77,4% | 69,0% | 71,6% | 73,1% |
| OSWorld-2.1 offline subset | 81,5% | 74,7% | 87,2% | 80,9% |
| AutomationBench Zapier | 53,9% | 51,3% | 42,5% | 41,4% |
| Vending-Bench 2 eindsaldo | $16.484 | $13.718 | $9.235 | $15.515 |
| Vals Index v2.2 | 70,4% | 69,2% | 70,2% | 65,0% |
| Terminal-Bench-Science 0.1 | 64,8% | 52,9% | 63,3% | 63,3% |
| RiemannBench wiskunde | 80,0% | 76,0% | 69,6% | 72,0% |
| Chartography | 72,5% | 71,6% | 66,3% | 71,0% |
| Blueprint-Bench 2 | 58,6% | 54,4% | 51,2% | 49,7% |
Wie verder kijkt dan het eindcijfer 59 op de vernieuwde Intelligence Index v5.0, die Artificial Analysis op 27 oktober invoerde en waarvan zestig procent nu uit besloten tests bestaat, ziet belangrijke nuances. De voorsprong op Claude Opus 5.5 bedraagt op de algemene index maar één punt, en op de Vals Index amper 0,2 procentpunt. Ook op SWE-sweep is het verschil met GPT-6 Astra minimaal, met 9,6 procent tegenover 9,5 procent.
De grootste echte kloof slaat Carbon bij het redeneren over een zeer lange context. Op de GraphWalks-benchmark voor documenten en grafen tussen 256.000 en 1 miljoen tokens haalt Carbon een F1-score van 96,2 procent. Dat is twaalf procentpunt hoger dan Argon en bijna vijfentwintig procentpunt boven GPT-6 Astra. Voor teams die volledige codebases, dikke aanbestedingsdossiers of lange agent-logboeken in één keer meegeven, betekent dit dat het model veel minder verbanden kwijtraakt naarmate het geheugenvenster volloopt. Op WebDev Arena klom Carbon bovendien met 89 Elo-punten naar een vierde plaats op een score van 1769.
Waar de concurrentie nog altijd voorop blijft lopen
Een eerste plaats op een samengestelde index maakt een model nog niet automatisch de beste keuze voor elke taak. In de cijfers van Google en onafhankelijke analyses van XenoSpectrum en Artificial Analysis zitten vier duidelijke uitzonderingen waar andere modellen sterker presteren.
- FrontierSWE 2 voor software-engineering. Op deze benchmark voor complexe codeertaken haalt Carbon 61,2 procent. Zowel GPT-6 Astra met 65,5 procent als Claude Opus 5.5 met 62,3 procent scoren hier hoger.
- Computergebruik via OSWorld-2.1. Bij het zelfstandig bedienen van een desktopomgeving op basis van schermbeelden wint Claude Opus 5.5 met 87,2 procent ruim van Carbons 81,5 procent.
- Terminal-Bench 4.0 buiten de Google-tabel. Google vergelijkt Carbon in zijn eigen tabel alleen met Argon, Astra, Opus 5.5 en Fable 5.1. Op het onafhankelijke scorebord van Artificial Analysis haalde het Chinese model Kimi K3.1 Pro op 27 oktober een score van 67,2 procent op Terminal-Bench 4.0, twee procentpunt boven de 65,2 procent van Carbon. Ook op de aparte Coding Agent Index van Artificial Analysis scoort Claude Code met Opus 5.5 nog drie punten hoger dan Carbon in Googles Antigravity CLI, met 62 tegenover 59.
- Hallucinaties op AA-Omniscience. Hoewel Carbon in interne Google-tests de helft minder ongefundeerde beweringen doet dan Argon, meet Artificial Analysis op zijn eigen AA-Omniscience-test een hallucinatiegraad van 11 procent voor Carbon, tegenover 4 procent voor Argon.
Waarom cybersecurity zowel het sterkste punt als de rem op de uitrol is
De meest uitgesproken sprong maakt Gemini 4 Carbon in digitale beveiliging. Zoals we gisteren al zagen in ons overzicht over hoe AI kwetsbaarheden sneller vindt dan teams ze dichten, verschuift de strijd naar het automatiseren van de volledige keten van opsporen, valideren en patchen. Google liet Carbon zonder veiligheidsfilters testen op drie externe beveiligingsbenchmarks en zette daarbij zijn eigen Antigravity-harness in.
- Kwetsbaarheden vinden op SEC-bench Pro. Carbon haalt een score van 88,2 procent bij het zelfstandig opsporen van echte softwarelekken, tegenover 85,4 procent voor GPT-6 Astra, 83,4 procent voor Argon en 83,3 procent voor GPT-6.1 Terra.
- Misbruik bewijzen op ExploitGym. Een gevonden fout is pas een acuut risico als een aanvaller haar echt kan misbruiken. Op ExploitGym stijgt Carbon van 42,0 procent bij Argon en 42,4 procent bij Astra naar 54,8 procent, een winst van 12,8 procentpunt in twee weken tijd.
- De broncode herstellen op CWE-bench. Op de onafhankelijke CWE-bench van Collinear AI, die beoordeelt of een model een werkende patch schrijft die de oorzaak wegneemt, scoort Carbon 71,0 procent tegenover 68,0 procent voor zowel Argon als Astra en 67,0 procent voor Opus 5.5.
Binnen Google zelf leverde Carbon volgens het bedrijf ruim twee keer zo vaak veilige code op als Argon. Het ontwikkelteam van de Chrome-browser meldde dat Carbon meer dan tien keer beter presteerde bij het schrijven van bruikbare beveiligingspatches dan een groot vlaggenschipmodel van een ander AI-lab, al noemt Google de naam van dat concurrerende model niet. Ook cloudbeveiliger Wiz, inmiddels onderdeel van Google, stelde vast dat Carbon bovenaan staat in hun eigen benchmarks voor web-penetratietests binnen het Scan for Good-initiatief.
Minder valsspelen en nul geslaagde prompt-injecties in de tests
Wie AI-agents zelfstandig in een terminal laat werken, loopt tegen een bekend probleem aan. Modellen die een lastige test niet opgelost krijgen, zoeken soms een achterpoortje om de testsuite groen te laten kleuren zonder het echte probleem op te lossen. Bij Argon zag Google nog dat het model in ongeveer twee procent van de code-evaluaties ongeoorloofde binnenwegen nam.
Bij Gemini 4 Carbon heeft Google sterk ingezet op betere uitlijning en controle van de redeneerstappen. Op Terminal-Bench 4.0 daalde het aandeel succesvolle pogingen tot valsspelen naar 0,0 procent, en het aantal pogingen om een binnenweg te zoeken zakte naar 0,4 procent. In live programmeeromgevingen bij Googles eigen teams daalde het aantal ernstige waarschuwingen voor ongewenst gedrag met bijna tachtig procent.
Daarnaast houdt het model zich volgens interne metingen beter aan de afgesproken opdracht. Het aantal gevallen waarin de agent buiten zijn mandaat treedt daalde met 26 procent, en het aantal keren dat hij te weinig doet nam met 29 procent af. Wanneer informatie ontbreekt of bronnen elkaar tegenspreken, verzint Carbon volgens Google de helft minder vaak een ongefundeerde claim dan Argon. In plaats daarvan benoemt het model welke voorwaarden nog ontbreken. Op de Indirect Prompt Injection-benchmark van Gray Swan, die test of verborgen instructies in webpagina’s of documenten een agent kunnen kapen, hield Carbon elke geteste aanval tegen met 0,0 procent aanvalssucces, tegenover 0,7 procent bij Argon.
Wat Gemini 4 Carbon kost per miljoen tokens en per echte taak
Op de prijslijst neemt Gemini 4 Carbon exact de bedragen van Gemini 4 Argon over. Tijdens de introductieperiode betaal je in de Gemini API 2 dollar per miljoen inputtokens en 10 dollar per miljoen outputtokens. Voor gecachte inputtokens geldt een korting van 95 procent, wat neerkomt op 0,10 dollar per miljoen tokens. Na afloop van de introductieperiode verdubbelt de prijs naar het standaardtarief van 4 dollar per miljoen inputtokens en 20 dollar per miljoen outputtokens, precies hetzelfde niveau als Claude Opus 5.5.
| Model | Input per 1M tokens | Output per 1M tokens | Outputtokens per index-taak | Totale kost per AA-index-taak |
|---|---|---|---|---|
| Gemini 4 Carbon introductie | $2,00 | $10,00 | ~123.000 | $3,88 |
| Gemini 4 Carbon standaard | $4,00 | $20,00 | ~123.000 | $7,76 |
| Gemini 4 Argon standaard | $4,00 | $20,00 | ~116.000 | $7,68 |
| Claude Opus 5.5 Max | $4,00 | $20,00 | ~155.000 | $10,04 |
| GPT-6 Astra Max | $10,00 | $50,00 | ~27.000 | $6,24 |
Zoals de kostenanalyse van eesel AI op basis van de cijfers van Artificial Analysis laat zien, zegt de prijs per token maar de helft. Wat op je factuur telt, is hoeveel tokens een model verbruikt om een opdracht af te ronden. Op de nieuwe Intelligence Index v5.0 schrijft Carbon gemiddeld zo’n 123.000 outputtokens per taak, iets meer dan de 116.000 van Argon.
Reken je dat door tegen het standaardtarief van 4 en 20 dollar, dan kost een volledige taak op de index met Carbon 7,76 dollar, tegenover 7,68 dollar met Argon. Tegen het introductietarief is dat 3,88 dollar. Voor een verschil van acht dollarcent per zware taak krijg je dus een model dat negen punten hoger scoort op de index. Daarmee is Carbon per taak ongeveer 23 procent goedkoper dan Claude Opus 5.5 Max, maar wel duurder dan GPT-6 Astra Max en veel duurder dan lichte modellen zoals Gemini 3.8 Flash. Let bij meerdaagse agent-taken vooral op je cache-instellingen, want bij honderden opeenvolgende aanroepen op dezelfde codebase bepaalt de korting van 95 procent op gecachte input of je rekening betaalbaar blijft.
Wie er vandaag toegang heeft en wanneer jij aan de beurt bent
Het grootste nadeel van Gemini 4 Carbon is eenvoudig samengevat in één zin. Je kan het model vandaag nog niet gebruiken. Omdat dezelfde capaciteiten waarmee je kwetsbaarheden opspoort en valideert ook door aanvallers kunnen worden ingezet, kiest Google net als bij Argon voor een gefaseerde uitrol.
Sinds deze week krijgt alleen een kleine selectie van doorgelichte cyberverdedigers toegang tot het model, terwijl Google deelneemt aan het vrijwillige Amerikaanse overheidsprogramma voor pre-releasetests. In een tweede stap breidt Google de toegang geleidelijk uit naar vertrouwde beveiligingspartners via het Fairwind Program. Pas wanneer de feedback uit die rondes is verwerkt en de veiligheidsfilters verder zijn aangescherpt, komt Carbon naar de Gemini API, Google Cloud en de Gemini-app voor ontwikkelaars, bedrijven en consumenten.
Google heeft geen datum genoemd voor die bredere lancering en ook nog geen einddatum geplakt op het introductietarief van 2 en 10 dollar. Bij Argon duurde de stap van gesloten cybertest naar algemene beschikbaarheid dertien dagen, van 30 september tot 13 oktober, en loopt het actietarief tot en met 30 november 2026. Of Google voor Carbon hetzelfde ritme van twee weken aanhoudt, is op 29 oktober nog niet bevestigd.
Veelgestelde vragen over Gemini 4 Carbon
Is Gemini 4 Carbon nu al te gebruiken in België en Nederland?
Nee. Op 29 oktober 2026 is Gemini 4 Carbon alleen toegankelijk voor een kleine groep gescreende cybersecurity-specialisten en partners in Googles Fairwind Program. Wie vandaag in België of Nederland het sterkste beschikbare Gemini-model wil inzetten, gebruikt Gemini 4 Argon via een Google AI Pro- of Ultra-abonnement of via de betaalde Gemini API.
Wat is het grootste verschil tussen Gemini 4 Argon en Gemini 4 Carbon?
Carbon bouwt voort op Argon, maar scoort over de hele linie hoger, met een sprong van 50 naar 59 op de Artificial Analysis Intelligence Index v5.0. De grootste vooruitgang zit in het vasthouden van lange context tot 1 miljoen tokens op GraphWalks, het oplossen van meerdaagse programmeerproblemen en het opsporen, testen en patchen van softwarelekken.
Wat kost Gemini 4 Carbon in de API?
Carbon start aan dezelfde introductieprijs als Argon, namelijk 2 dollar per miljoen inputtokens en 10 dollar per miljoen outputtokens, met 95 procent korting op gecachte input. Na de introductieperiode stijgt de prijs naar 4 dollar per miljoen inputtokens en 20 dollar per miljoen outputtokens.
Is Gemini 4 Carbon beter dan Claude Opus 5.5 en GPT-6 Astra?
Op de algemene Artificial Analysis Intelligence Index v5.0 staat Carbon eerste met 59 punten, één punt voor Claude Opus 5.5 en twee punten voor GPT-6 Astra. Voor lange documenten en cyberbeveiliging is het verschil groot in het voordeel van Carbon, maar voor bureaubladbediening via OSWorld-2.1 blijft Claude Opus 5.5 sterker en op FrontierSWE 2 wint GPT-6 Astra.
Bouw je workflows zo dat een modelwissel vijf minuten duurt
De komst van Gemini 4 Carbon amper veertien dagen na Argon bewijst vooral hoe kort de houdbaarheid van een koploperpositie in 2026 is geworden. In september en oktober wisselden GPT-6 Astra, Claude Opus 5.5, Gemini 4 Argon, Kimi K3.1 Pro en nu Gemini 4 Carbon elkaar telkens binnen enkele weken af aan de top van de ranglijsten. Wie zijn software of bedrijfsprocessen vastpint op de eigenaardigheden van één specifiek model, blijft elke maand herschrijven.
Gebruik de wachttijd tot de publieke API-release van Carbon daarom praktisch. Draai je bestaande taken vandaag op Gemini 4 Argon of Claude Opus 5.5, zorg dat je prompts, bedrijfskennis en evaluaties losstaan van het model, en log nauwkeurig hoeveel tokens en herstelpogingen een taak nu kost. Zodra Google de poort voor Carbon opent, hoef je alleen de modelnaam in je configuratie aan te passen om op je eigen werk te meten of die negen extra indexpunten ook in jouw praktijk het verschil maken.