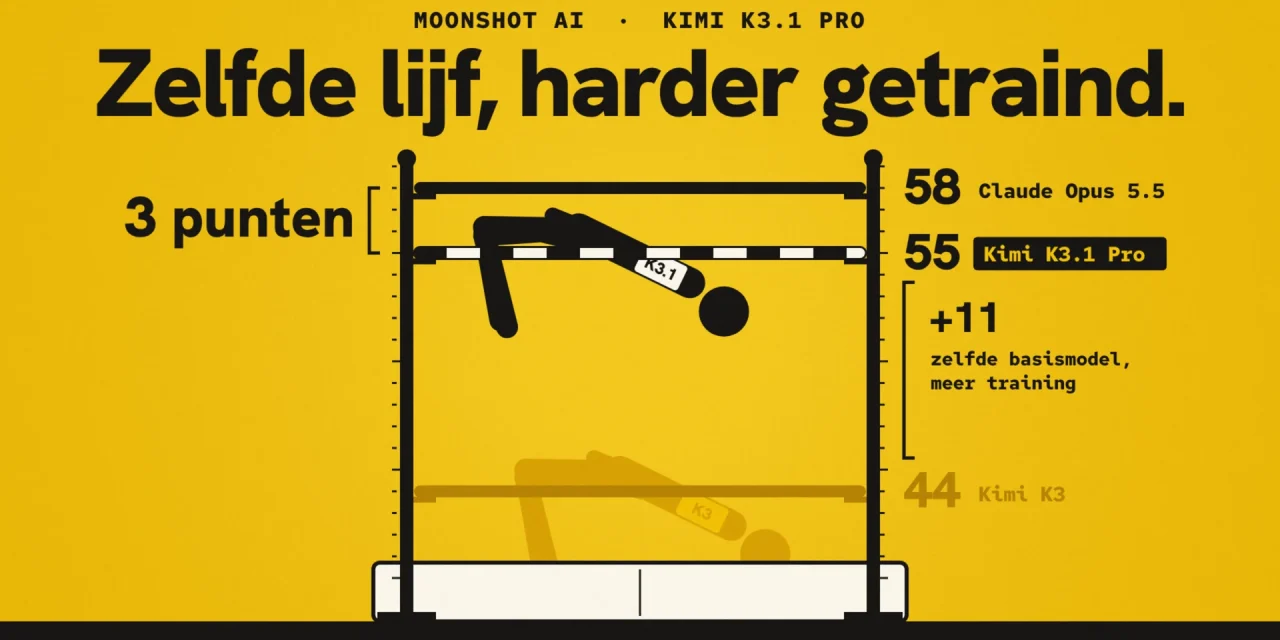
Kimi K3.1 Pro van het Chinese Moonshot AI scoort 55 op de onafhankelijke Intelligence Index van Artificial Analysis. Dat is drie punten minder dan Claude Opus 5.5, en het model kost via de API de helft. De gewichten komen volgens Moonshot tegen 4 november vrij, waarmee het het sterkste open model ooit wordt. Er is wel een addertje: Kimi K3.1 Pro praat veel, zodat de prijs per taak nauwelijks daalt. Hieronder lees je wat het model echt kan, wat het kost en hoe je het vanuit België uitprobeert.
Wat is Kimi K3.1 Pro?
Kimi K3.1 Pro is het eerste model van de K3.1-reeks, gelanceerd op 23 oktober 2026. Het is geen nieuw basismodel. Moonshot nam Kimi K3 van juli, met dezelfde 2,8 biljoen parameters waarvan er 104 miljard per token rekenen, en trainde het veel langer bij. Volgens de tech blog van Moonshot gebeurde dat met “substantially larger post-training compute”, met reinforcement learning op honderden soorten taken tegelijk.
De rest bleef gelijk: een contextvenster van 1 miljoen tokens, invoer als tekst en beeld, en een model dat altijd eerst nadenkt. Naast Kimi K3.1 Pro lanceerde Moonshot een Highspeed-versie die volgens het bedrijf twee tot drie keer sneller antwoordt, met dezelfde intelligentie.
Moonshot zet vier toepassingen in de verf:
- Volledige softwareprojecten, ook games in Unity, Unreal Engine en Godot.
- 3D-modellen uit tekst, een schets of een foto, via Blender- en CAD-scripts. Met 3D Make op kimi.com bekijk en bewerk je het resultaat en download je het klaar voor een 3D-printer.
- Financieel werk van begin tot eind, zoals financiële modellen en bedrijfsanalyses.
- Minder hallucinaties. Op de eigen stresstest van Moonshot daalde het aandeel foute beweringen van 23,4% bij K3 naar 8,3%.
Hoe goed is Kimi K3.1 Pro echt?
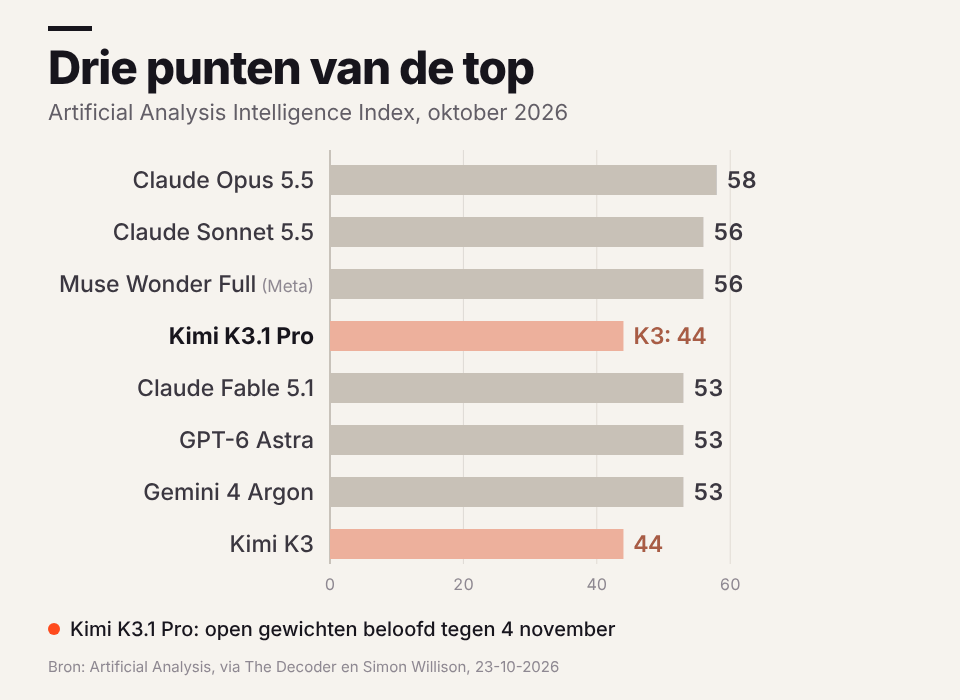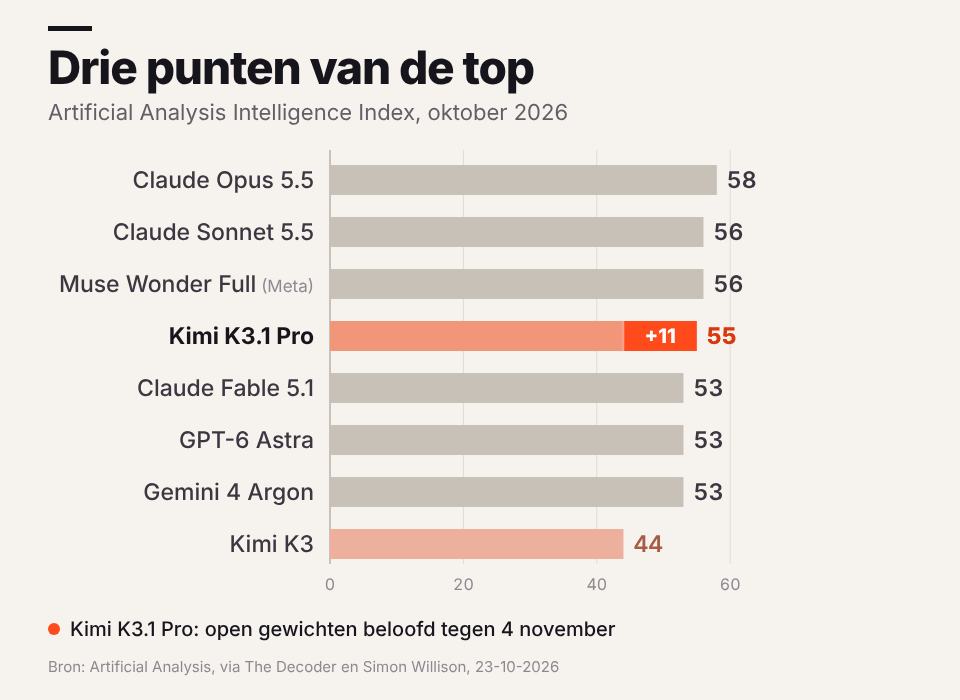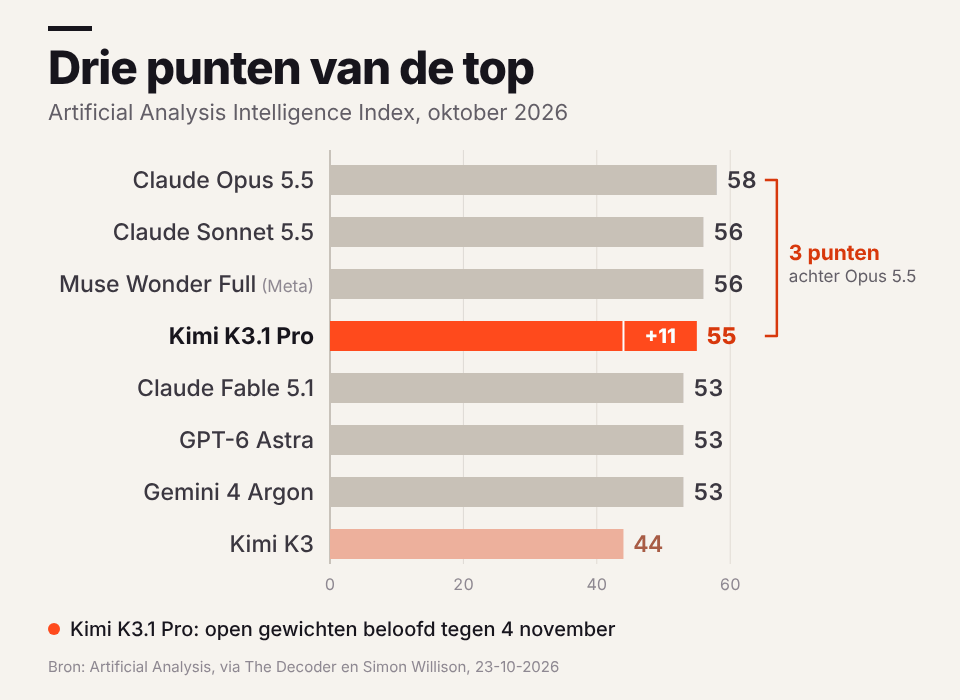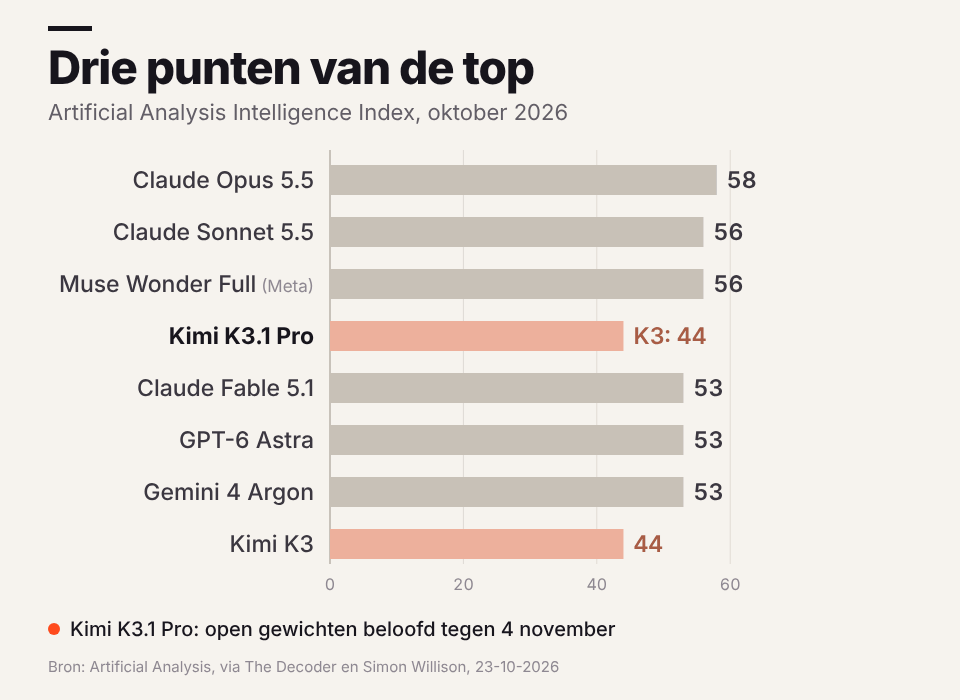
De betrouwbaarste meting komt van Artificial Analysis, via The Decoder. Die geeft Kimi K3.1 Pro 55 punten op de Intelligence Index, 11 meer dan K3. Alleen Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) en Muse Wonder Full van Meta (56) scoren hoger. Claude Fable 5.1, GPT-6 Astra en Gemini 4 Argon staan met 53 punten lager, merkt Simon Willison op. Komen de gewichten zoals beloofd, dan krimpt de afstand tussen het beste open en het beste gesloten model van 12 naar 3 punten.
Ook op GDPval-AA, een test met echt kantoorwerk, komt het model dicht bij de top: 1.846 Elo, tegen 1.866 voor Opus 5.5.
De cijfers die Moonshot zelf publiceert, zijn nog straffer. Ze zijn gemeten met de hoogste denkstand en grotendeels in de Claude Code-omgeving van Anthropic, en niemand heeft ze al overgedaan. Lees ze dus als richting, niet als uitslag.
| Benchmark (eigen cijfers Moonshot) | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 (werken in een terminal) | 65,7% | 66,4% | 58,2% |
| BrowseComp (opzoekwerk op het web) | 92,1% | 90,8% | 91,5% |
| OfficeQA Pro v2 (vragen over kantoordocumenten) | 64,4% | 62,2% | niet vermeld |
| BenchCAD met tools (3D en CAD) | 92,7% | 96,2% | 95,9% |
| GPQA-Diamond (wetenschapsvragen) | 94,2% | niet vermeld | 96,1% |
De eerste onafhankelijke praktijktests bevestigen het beeld van een sterk, maar geen beter model dan de top. Op de privétest voor data-analyse van Plotly haalde het 42 op 43 vragen, gedeeld derde op 34 modellen en het beste resultaat dat Plotly van een Chinees lab zag. In een kleine codeertest van Kingy AI leverde het 4 van de 8 werkende patches, evenveel als Claude Sonnet 5.5 en één minder dan GPT-6.1 Sol. Kimi K3 haalde er toen geen enkele.
Wat kost Kimi K3.1 Pro?
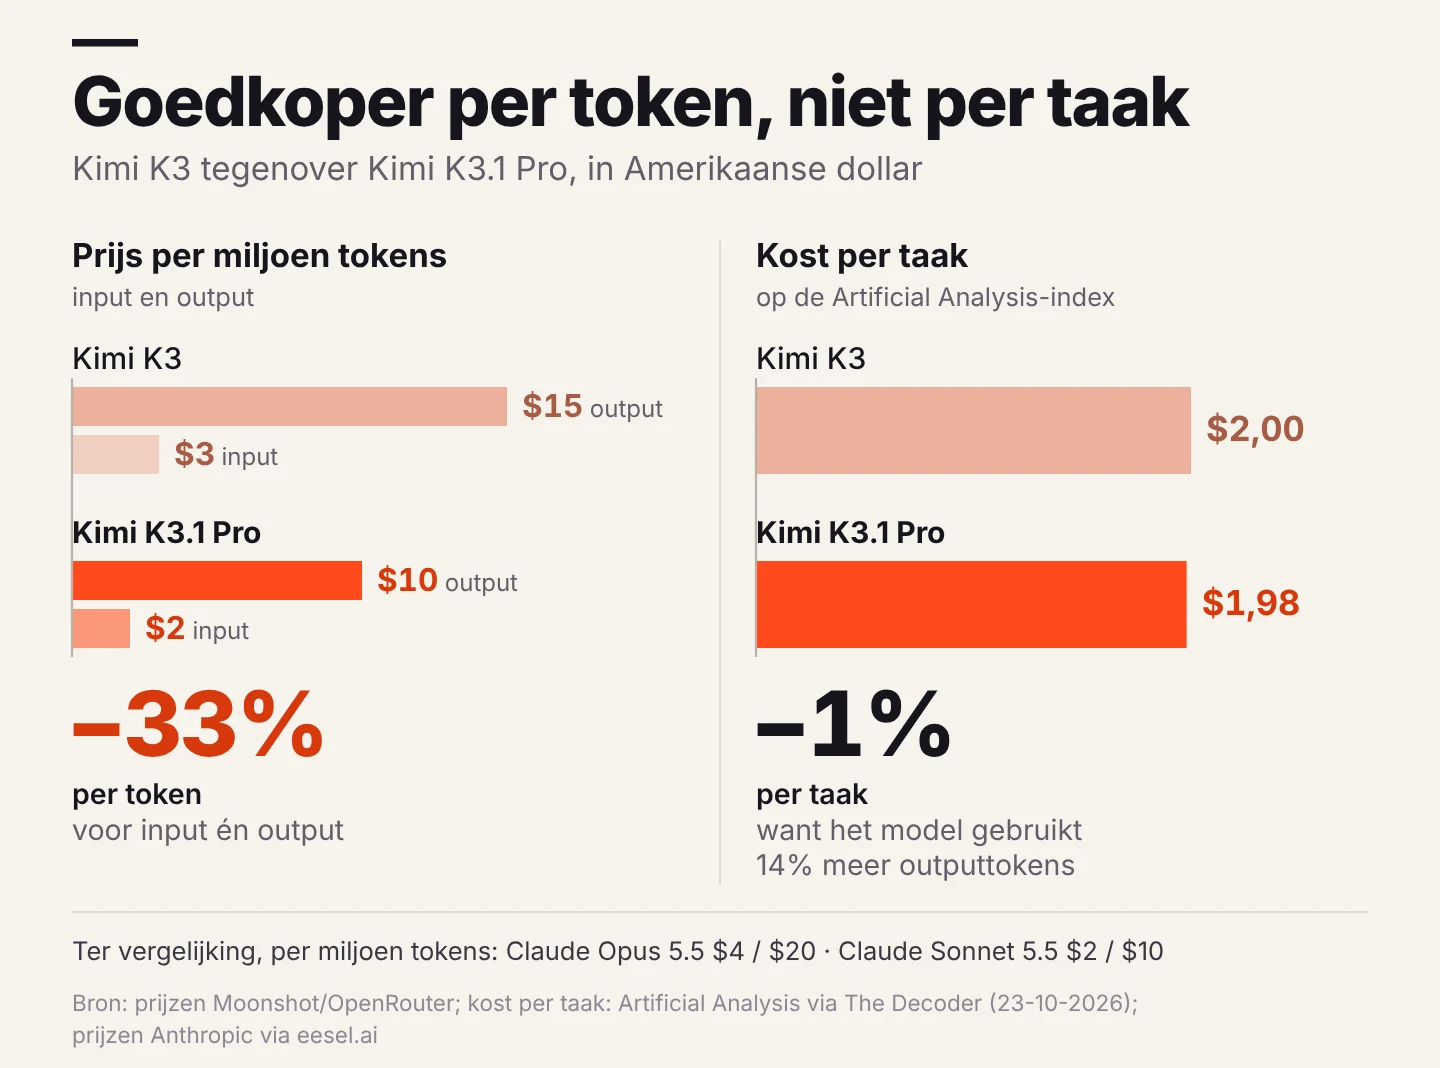
Via de API betaal je $2 per miljoen inputtokens en $10 per miljoen outputtokens, een derde minder dan K3 ($3 en $15). Gecachete input kost $0,20. Daarmee zit het op de prijs van Claude Sonnet 5.5 en GPT-6.1 Sol, en op de helft van Claude Opus 5.5 ($4 en $20). De Highspeed-versie kost het dubbele, behalve voor gecachete input. Die prijzen staan ook zo op OpenRouter.
Per taak ligt het anders. Kimi K3.1 Pro schrijft 14% meer outputtokens dan zijn voorganger. Artificial Analysis rekent daardoor $1,98 per taak op de index, tegen $2,00 voor K3. Om de hele index te doorlopen, gebruikte het model 150 miljoen outputtokens, tegen een mediaan van 87 miljoen voor alle geteste modellen, schrijft Handy AI. Bij Plotly kostte de volledige test $13,47, terwijl GPT-6.1 Sol alle vragen juist had voor $2,61.
Reken dus met je eigen taken, niet met de prijslijst. Wie het denkwerk wil inkorten, zet de parameter reasoning_effort op low. Uitzetten kan niet, en de temperatuur ligt vast op 1,0, staat in de API-documentatie.
Waar schiet Kimi K3.1 Pro tekort?
- Snelheid. Op OpenRouter haalt de standaardversie 44 tokens per seconde, Highspeed 76. Plotly mat een mediaan van 2,5 minuten per vraag, het op één na traagste model in zijn test.
- Wetenschappelijk werk in de terminal. Op Terminal-Bench Science haalt het 38,1%, tegen 68,1% voor GPT-6 Astra en 63,3% voor Opus 5.5.
- Feitelijke juistheid. De daling van de hallucinaties is groot, maar GPT-6 Astra doet het op dezelfde test nog beter (5,5%). Moonshot noemt die test zelf een stresstest en geen maat voor het gewone foutpercentage.
- Abonnementen. Een gebruiker op Hacker News zat met het abonnement van $99 per maand na 47 minuten al aan zijn limiet voor vijf uur, meldt Handy AI. Eén ervaring, maar wel een waarschuwing voor wie lange codeersessies plant.
- Afwerking. De API-documentatie ging online met invulvelden als “[xx.x%]” in plaats van cijfers.
Waarom Moonshot het model bewust minder liet hacken
Het opvallendste deel van de lancering gaat over cyberveiligheid. Moonshot merkte dat het model beter werd in het vinden en misbruiken van softwarelekken naarmate de training vorderde. Voor de open versie haalde het daarom alle cyberdata uit de laatste trainingsfases. Moonshot wil “not release open weights that would extend the absolute frontier of cyber capability”, schrijft het bedrijf.
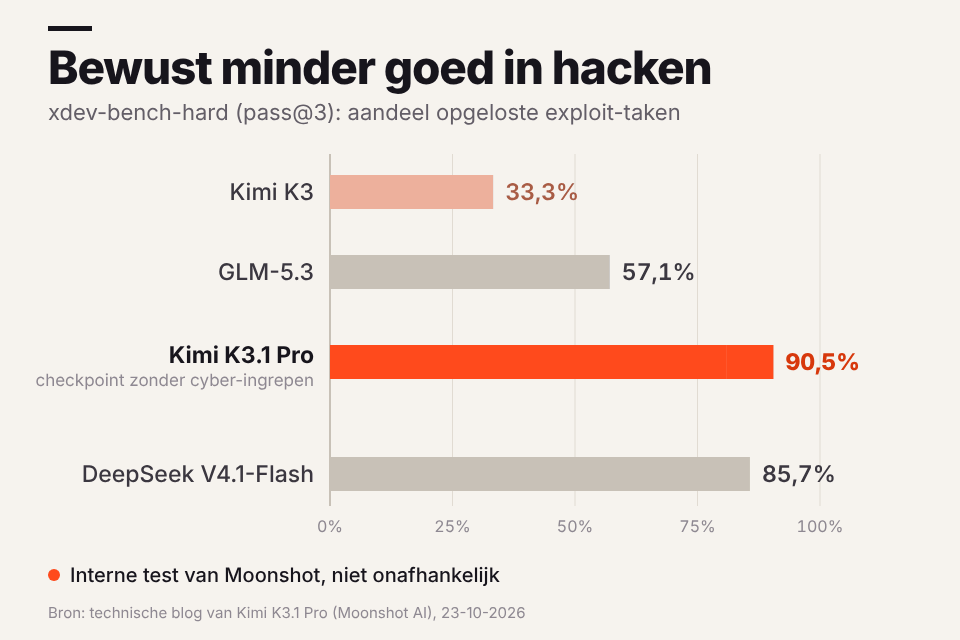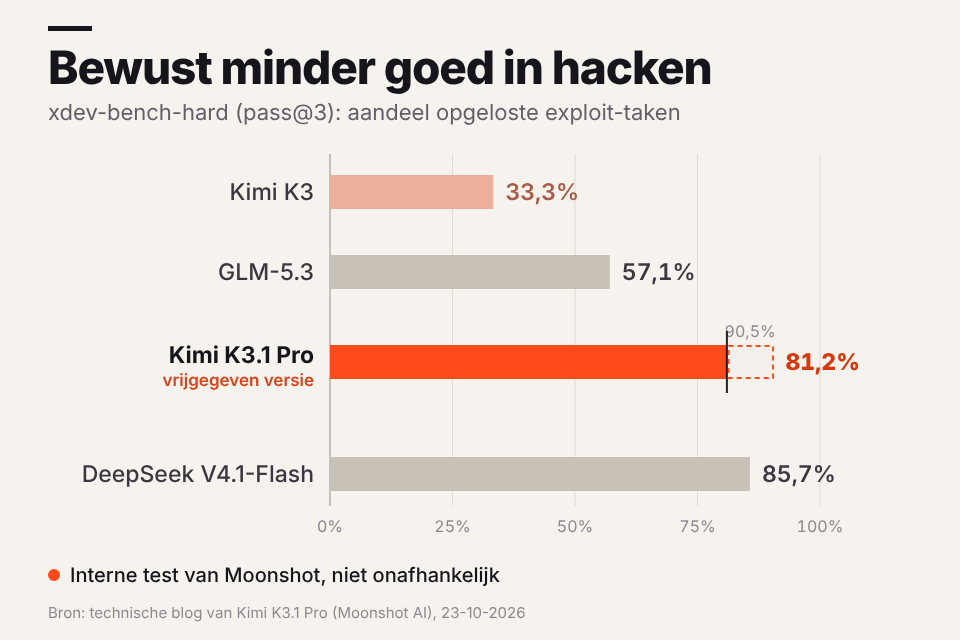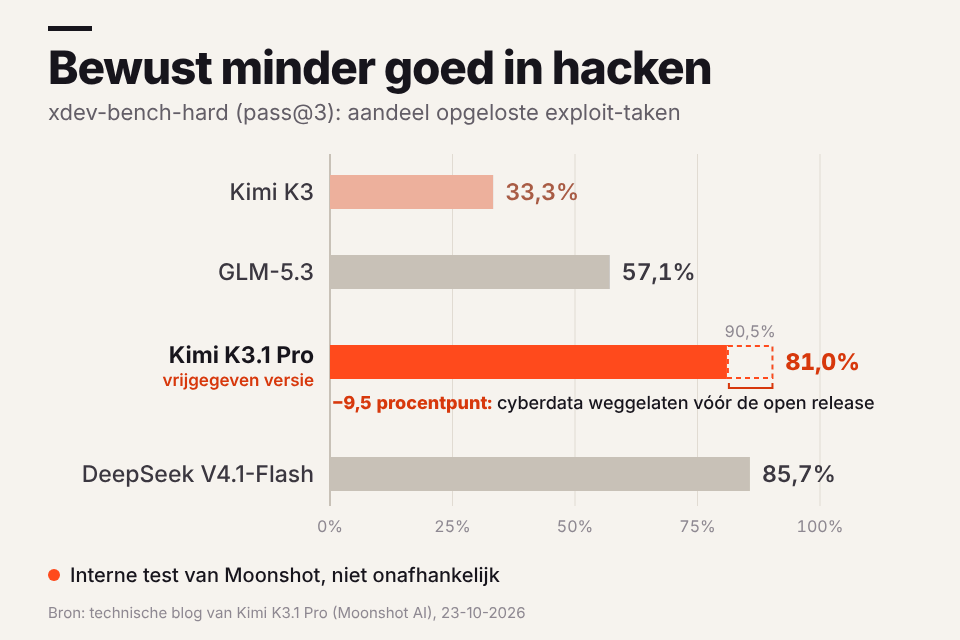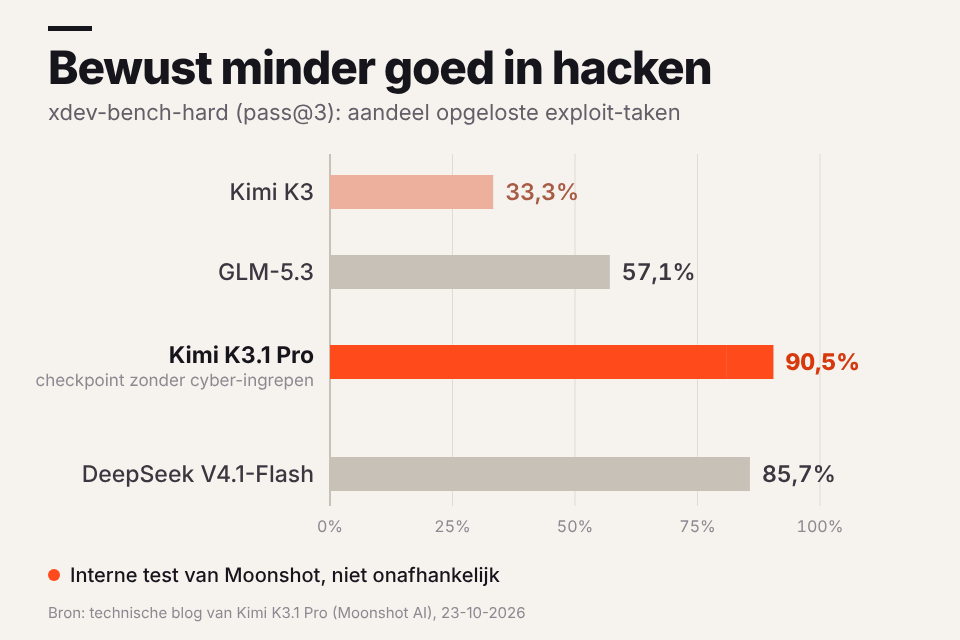
Op de interne test xdev-bench-hard loste een versie zonder die ingreep 90,5% van de taken op, het vrijgegeven model 81,0%. Dat is nog altijd veel meer dan K3 (33,3%), maar minder dan DeepSeek V4.1-Flash (85,7%). Zo’n open en concrete toelichting is zeldzaam, ook bij Amerikaanse labs. Of de ingreep standhoudt als anderen het open model zelf bijtrainen, kan nog niemand zeggen.
Zo probeer je Kimi K3.1 Pro vanuit België
- In de chat: op kimi.com en in de Kimi-app voor iOS en Android. Daar zit ook 3D Make.
- Voor programmeurs: in Kimi Code kies je het model met het commando
/model, en in de desktop-app Kimi Work vanaf versie 3.1.0. - Via de API: op platform.kimi.com met de model-ID’s
kimi-k3.1-proenkimi-k3.1-pro-highspeed, of via OpenRouter. - Zelf draaien: pas na de release van de gewichten, en dan alleen op een GPU-server. De gewichten van K3 zijn zo’n 1,56 TB groot, goed voor een server met acht GPU’s van de nieuwste generatie, zoals we uitlegden in Kimi K3 in de praktijk.
Let op met gevoelige gegevens. Volgens de internationale privacyverklaring staat je data op servers in Singapore, buiten de EU. OpenRouter biedt het model niet aan via zijn Europese routering. Moonshot biedt API-klanten wel zero data retention aan, maar Wavect raadt Europese bedrijven aan om de verwerkersovereenkomst en de afspraken over training eerst zwart op wit te krijgen. Test dus met publieke of verzonnen data tot dat geregeld is. De licentie van K3.1 Pro is nog niet bekend. Die van K3 laat commercieel gebruik toe, met extra voorwaarden voor grote aanbieders.
Veelgestelde vragen over Kimi K3.1 Pro
Is Kimi K3.1 Pro open source?
Nog niet. Je gebruikt het nu alleen via Kimi en de API. Moonshot belooft de volledige gewichten tegen 4 november 2026. Onder welke licentie is nog niet bekend.
Is Kimi K3.1 Pro beter dan Claude Opus 5.5?
Nee. Op de onafhankelijke index van Artificial Analysis scoort het 55 tegen 58. Op enkele eigen benchmarks van Moonshot ligt het voor, op andere achter.
Wat kost Kimi K3.1 Pro?
$2 per miljoen inputtokens en $10 per miljoen outputtokens. Omdat het model veel schrijft, daalt de kost per taak amper tegenover K3.
Mag ik Kimi K3.1 Pro gebruiken met bedrijfsdata?
Wees voorzichtig. De API-data staat in Singapore. Werk met publieke of fictieve data tot je contract, verwerkersovereenkomst en afspraken over training rond zijn, of wacht tot je het model zelf kan hosten.
Drie punten is geen achterstand meer, het is een keuze
Kimi K3.1 Pro toont vooral hoeveel er nog uit een bestaand model te halen valt met meer training. Voor wie de API gebruikt, is het een sterk alternatief voor Sonnet-werk, op voorwaarde dat je de kost per taak zelf meet en snelheid geen eis is. De echte test komt op 4 november. Dan kan iedereen het model zelf draaien en nameten, en zien we of de drie punten ook buiten de benchmarks van Moonshot standhouden. Wil je weten waar Moonshot staat tussen de andere Chinese spelers, lees dan ons overzicht van de 40 meest innovatieve AI-labs in China.