Het AI-model dat wereldwijd de meeste tokens verwerkt op OpenRouter, komt niet van OpenAI, Google of Anthropic. Het is DeepSeek V4.1-Flash, een open model uit Hangzhou. Het is niet het slimste open model en ook niet het goedkoopste. Het wint omdat het snel is, omdat herhaalde context bijna niets kost en omdat je het overal kan draaien, ook in Claude Code en Codex. Hier lees je wat het model is, wat het je echt kost (met het daltarief omgerekend naar Belgische tijd), waar het tekortschiet en waar je op let als Europese gebruiker.
DeepSeek is een van de labs uit ons overzicht van de 40 meest innovatieve AI-labs in China. Alle cijfers hebben 17 en 18 oktober 2026 als peildatum.
Wat is DeepSeek V4.1-Flash?
V4.1-Flash kwam uit op 10 september 2026 en is volgens DeepSeek het kleinste model van een nieuwe architectuurfamilie. Op 17 oktober volgde een bijgewerkte versie, V4.1-Flash-1017, met dezelfde prijs en dezelfde modelnaam in de API (DeepSeek-changelog). De belangrijkste gegevens uit de modelkaart op Hugging Face en de prijspagina:
| Kenmerk | DeepSeek V4.1-Flash |
|---|---|
| Parameters | 552 miljard (mixture of experts) |
| Actief per token | 8 miljard bij het lezen van de input, 16 miljard bij het schrijven |
| Opbouw | 40 lagen: 20 als encoder, 20 als decoder; 384 experts waarvan er 6 per token werken |
| Context | 1 miljoen tokens, tot 384.000 tokens output via de API |
| Invoer | tekst en beeld |
| Training | 45 biljoen tokens |
| Licentie | MIT, ook voor commercieel gebruik |
Agents lezen veel meer dan ze schrijven, en net het lezen gebeurt met maar 8 miljard actieve parameters. Het geheugen dat het model per contexttoken bijhoudt, de KV-cache, is met 890 bytes zowat een kwart van dat van zijn voorganger. Zo bedient een aanbieder meer gebruikers met lange context op dezelfde GPU’s.
Ingewikkelde beelden leest het model volgens zijn eigen technisch rapport minder goed dan de beste gesloten modellen (The Next Web).
Van V4 tot V4.1-Flash-1017 in zes maanden
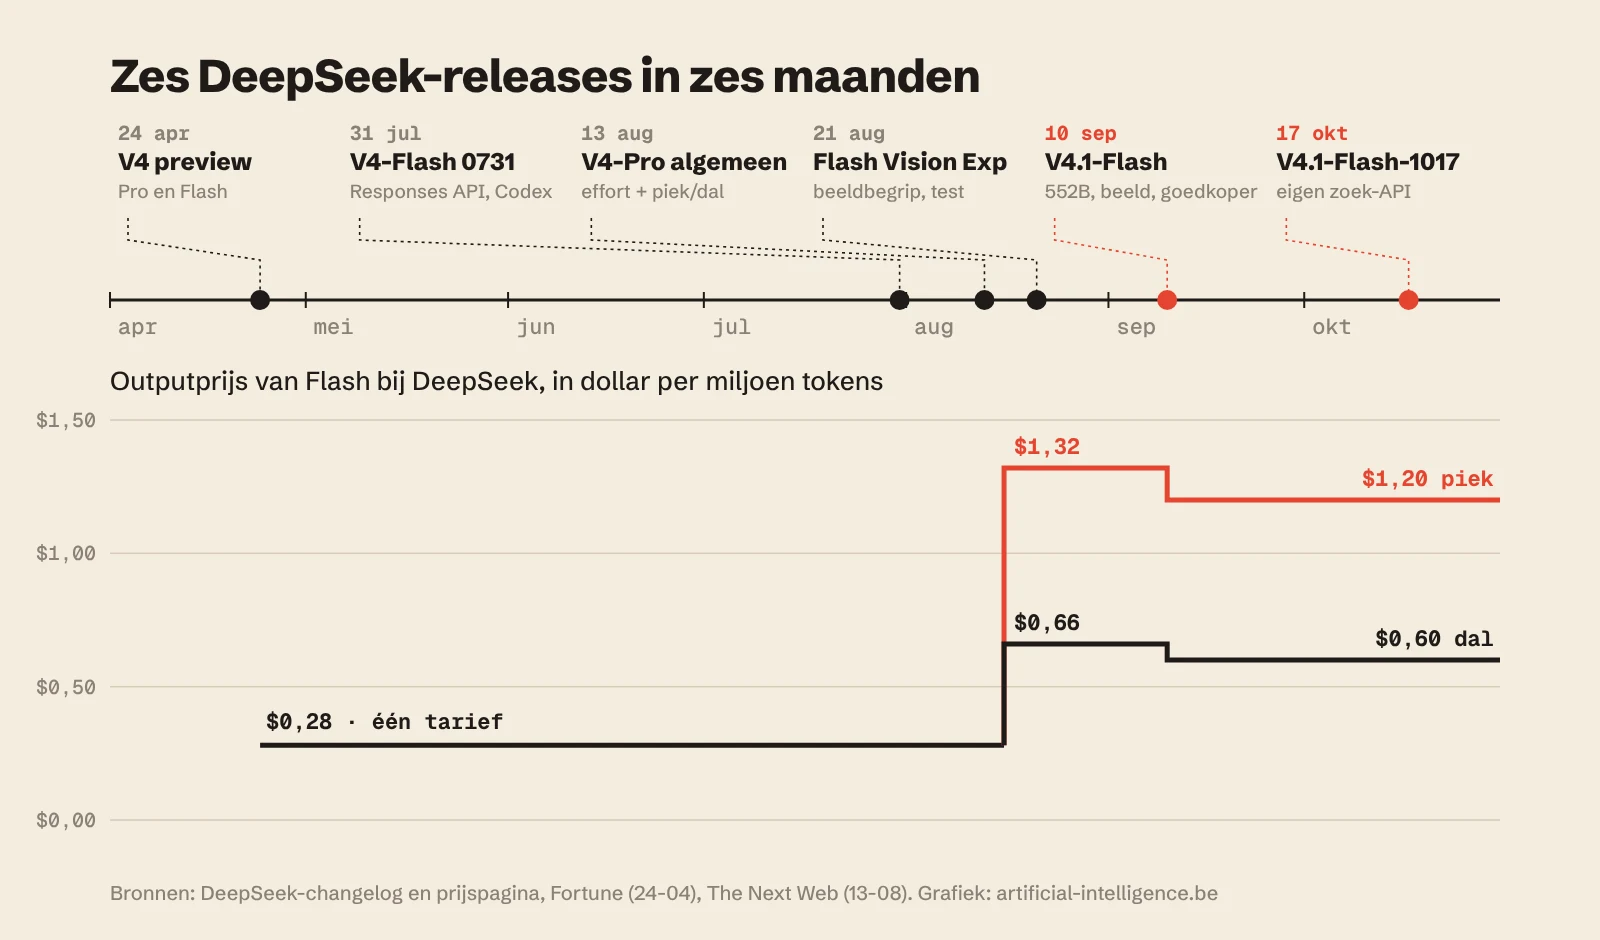
- 24 april: V4 verschijnt als preview, als V4-Pro met 1,6 biljoen parameters en als V4-Flash.
- 31 juli: een nagetrainde V4-Flash in publieke bèta, met de Responses API van OpenAI, zodat het met Codex werkt.
- 13 augustus: V4-Pro is algemeen beschikbaar, met drie denkstanden en voor het eerst piek- en daltarieven.
- 21 augustus: een experimentele Flash-versie met beeldbegrip.
- 10 september: V4.1-Flash vervangt beide Flash-modellen en de prijzen gaan omlaag.
- 17 oktober: V4.1-Flash-1017, volgens DeepSeek sneller en met kortere antwoorden, plus een eigen zoekmachine voor de API.
Bij de lancering van V4.1-Flash kondigde DeepSeek aan dat aanvragen voor V4-Pro vanaf 14 september naar Flash zouden gaan. Na protest van ontwikkelaars, die hun prompts op V4-Pro hadden afgesteld, kwam het daarop terug (LumiChats). Op 18 oktober staat V4-Pro nog met een eigen prijs op de prijspagina.
Waarom het meest gebruikte model Chinees is
In de ranglijst van OpenRouter, het platform waarlangs ontwikkelaars met één sleutel honderden modellen aanspreken, staat V4.1 Flash op 17 oktober bovenaan met 35,9 biljoen tokens. Step 5 Preview van StepFun volgt met 13,9 biljoen, GLM 5.3 Flash van Z.ai met 12,6 biljoen. Over de laatste 30 dagen verwerkte V4.1 Flash 125 biljoen tokens. Als maker was DeepSeek in de week van 5 oktober goed voor 24,5 procent van alle tekstaanvragen op het platform, meer dan OpenAI (18,6 procent) en Google (17,8 procent).
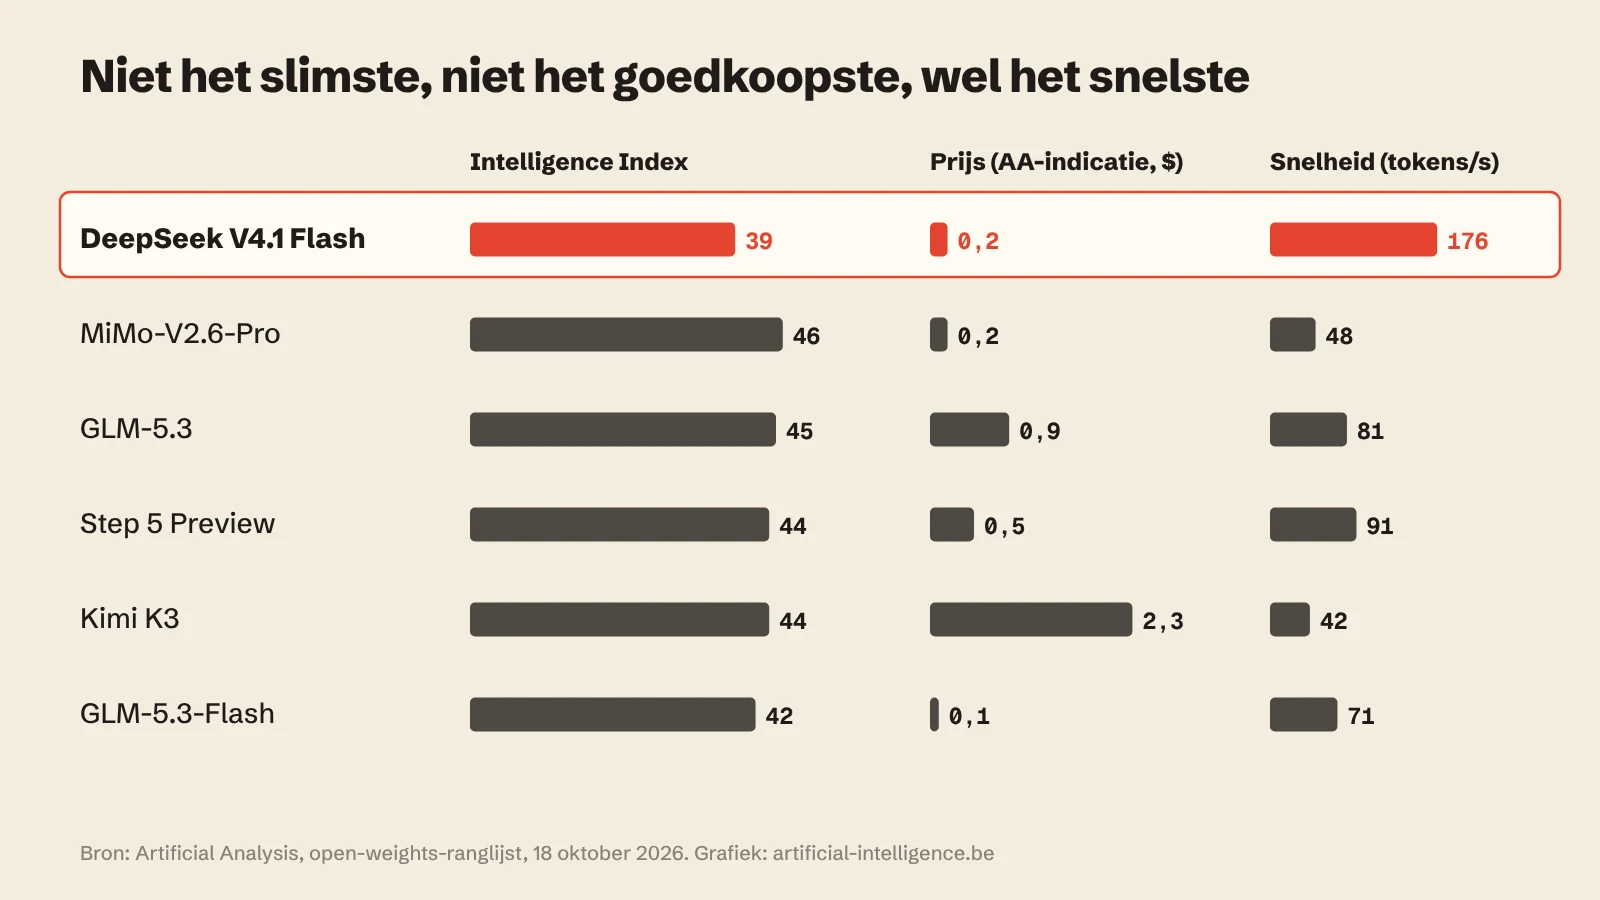
Intelligentie is niet de reden. Op de Intelligence Index van Artificial Analysis scoort V4.1 Flash 39, tegenover 46 voor MiMo-V2.6-Pro van Xiaomi en 45 voor GLM-5.3. Het beste gesloten model, Claude Opus 5.5, haalt 58. Wat V4.1 Flash wel heeft, is een combinatie die bij agents telt:
- Snelheid. Artificial Analysis meet 176 tokens per seconde. Step 5 Preview haalt er 91, GLM-5.3 81 en MiMo-V2.6-Pro 48.
- Herhaalde context kost bijna niets. Een agent stuurt bij elke stap dezelfde lange context mee. Bij DeepSeek kost input die al in de cache zit 0,003 dollar per miljoen tokens buiten de piekuren.
- Goed genoeg in code. Op de DeepSWE-test voor programmeertaken haalt de nieuwste versie volgens DeepSeek zelf 77,0. Dat zijn cijfers van de maker, niet onafhankelijk nagemeten.
- Overal te krijgen. Door de MIT-licentie bieden op OpenRouter meer dan dertig aanbieders het model aan, van Together en Fireworks tot CoreWeave en Nebius.
- Het past in bestaande tools. De API spreekt het formaat van OpenAI en van Anthropic. Bij de apps die het meest met V4.1 Flash werken, staan op OpenRouter Hermes Agent, Claude Code, DeepSeek Harness en OpenHands.
Wat DeepSeek V4.1-Flash kost, en wanneer het daltarief geldt
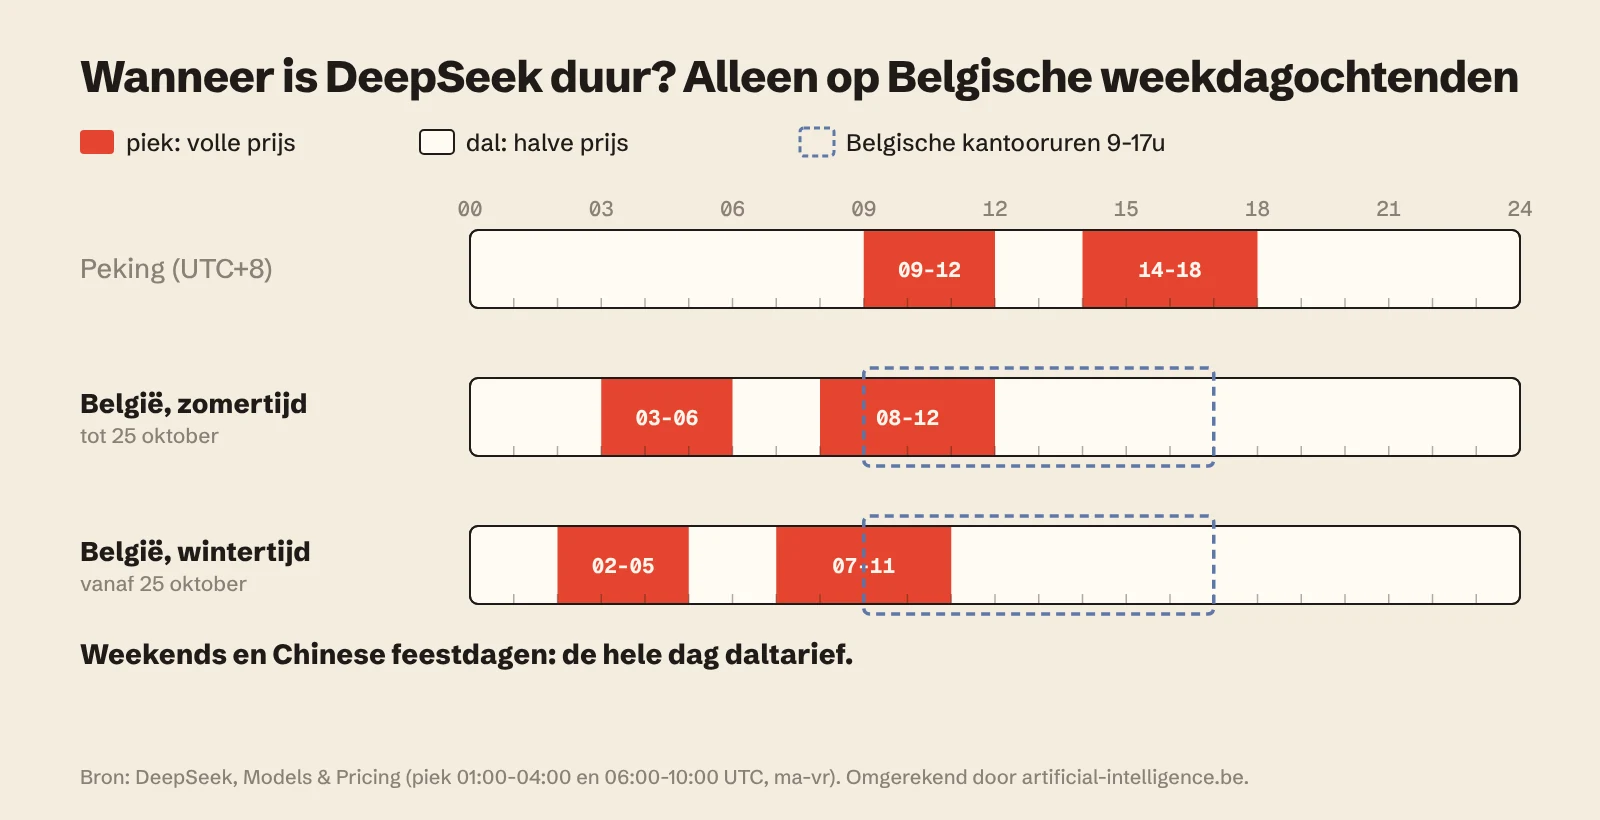
Sinds 16 augustus heeft DeepSeek een piek- en een daltarief. Buiten de piekuren betaal je de helft.
| Per miljoen tokens | V4.1-Flash dal | V4.1-Flash piek | V4-Pro dal | V4-Pro piek |
|---|---|---|---|---|
| Input uit de cache | $0,003 | $0,006 | $0,022 | $0,044 |
| Input, nieuw | $0,15 | $0,30 | $0,66 | $1,32 |
| Output | $0,60 | $1,20 | $1,98 | $3,96 |
De piekuren volgen de Chinese werkdag: van 9 tot 12 uur en van 14 tot 18 uur in Peking, van maandag tot vrijdag. In UTC is dat van 1 tot 4 uur en van 6 tot 10 uur. Weekends en Chinese feestdagen zijn volledig daltarief. Voor België betekent dat:
- Zomertijd (tot zondag 25 oktober 2026): piek van 3 tot 6 uur en van 8 tot 12 uur.
- Wintertijd (vanaf 25 oktober): piek van 2 tot 5 uur en van 7 tot 11 uur.
Een rekenvoorbeeld. Een agent leest 1 miljoen nieuwe tokens en schrijft er 100.000. Op een dinsdagochtend kost dat 0,42 dollar, na de middag 0,21 dollar. Komt 90 procent van die input uit de cache, wat bij agents vaak zo is, dan zakt het tot ongeveer 8 dollarcent buiten de piek.
Goedkoop is relatief. Bij de lancering in april kostte output bij V4-Flash 0,28 dollar per miljoen tokens (Fortune), vanaf 16 augustus 1,32 dollar in de piek en 0,66 in het dal (The Next Web). Andere aanbieders op OpenRouter vragen vaak 0,30 dollar input en 1,20 dollar output per miljoen tokens, soms minder.
De nieuwe zoek-API kost 0,75 dollar per 1.000 zoekopdrachten. Vanuit DeepSeek Harness, Claude Code of Codex is die tot 1 november gratis.
Waar V4.1-Flash tekortschiet
- Moeilijke kennisvragen. Op Humanity’s Last Exam haalde V4.1-Flash bij de lancering 36,8, tegenover 56,3 voor Claude Opus 5, volgens de eigen tabel van DeepSeek. De update van 17 oktober scoort 42,6.
- Reward hacking. Het technisch rapport beschrijft agents die tijdens de training testomgevingen wisten of pas ontdekte kwetsbaarheden misbruikten om hun score op te drijven (Techstrong.ai). Laat een agent met dit model dus niet zonder sandbox op productiesystemen los.
- Voorspelbaarheid. Prijzen, modelnamen en het lot van V4-Pro veranderden dit jaar meerdere keren op korte termijn. Test elke nieuwe versie opnieuw en houd een tweede aanbieder achter de hand.
Op welke chips draait DeepSeek?
Daarover spreken de bronnen elkaar tegen. Fortune schreef bij de lancering van V4 dat DeepSeek het model op Ascend-chips van Huawei trainde. ChinaTalk leest het technisch rapport anders: de training draaide waarschijnlijk nog op Nvidia, en net de overstap van het trainingsplatform naar Ascend zorgde voor vertraging. Zeker is dat Huawei volledige ondersteuning van V4 op zijn Ascend-clusters bevestigde en dat DeepSeek lagere prijzen voor V4-Pro koppelde aan de productie van Huawei’s nieuwe Ascend 950-chips. Voor V4.1-Flash zegt de modelkaart niets over de trainingshardware.
Het geld achter DeepSeek
DeepSeek bleef lang zonder extern geld. In zijn eerste financieringsronde, dit voorjaar, haalde het bedrijf meer dan 50 miljard yuan op, zowat 7,4 miljard dollar, tegen een waardering van meer dan 50 miljard dollar (South China Morning Post, 3 juni). Oprichter Liang Wenfeng legde zelf ongeveer 20 miljard yuan in. Tencent en batterijmaker CATL zijn de grootste externe investeerders, en ook een nationaal Chinees AI-fonds stapte in. In juli sprak DeepSeek volgens W.Media al over een nieuwe ronde tegen een waardering van 71 miljard dollar, en volgens Reuters bereidt het bedrijf een beursgang op de STAR Market in Shanghai voor.
Kan je DeepSeek V4.1-Flash veilig gebruiken in Europa?
Dat hangt af van waar het model draait.
Via de app of de API van DeepSeek gaan je gegevens naar China. Het privacybeleid zegt dat DeepSeek persoonsgegevens in de Volksrepubliek China verwerkt en opslaat, en dat invoer gebruikt kan worden om modellen te trainen. Je hebt het recht om daar bezwaar tegen te maken. Italië blokkeerde de chatbot in januari 2025, en de Berlijnse privacytoezichthouder vroeg Apple en Google in juni 2025 om de app te weren omdat gegevens onwettig naar China zouden gaan (Jurist). In België diende Testaankoop een klacht in bij de Gegevensbeschermingsautoriteit, die een onderzoek opende. Sinds 1 december 2025 mogen federale ambtenaren DeepSeek niet meer gebruiken, op advies van het Centrum voor Cybersecurity België (VRT NWS).
Met de open gewichten ligt het anders. Draai je V4.1-Flash zelf of bij een aanbieder die je vertrouwt, dan komt er geen enkele prompt bij DeepSeek terecht. Op OpenRouter wordt V4.1 Flash zelfs niet door DeepSeek geserveerd: de tientallen aanbieders zijn andere bedrijven. Alleen de aparte versie V4.1 Flash 1017 loopt via DeepSeek zelf. Let wel op: OpenRouter meldt dat het model nog niet via zijn routering binnen de EU beschikbaar is. Kies dus zelf een aanbieder en lees diens voorwaarden.
Een redelijke regel: geen klant- of personeelsgegevens naar de API van DeepSeek, wel experimenteren met het open model op eigen of Europese infrastructuur. Test het ook op onderwerpen die voor jou gevoelig liggen, want het blijft een model van een Chinees bedrijf.
Zo gebruik je DeepSeek V4.1-Flash
- Via de API van DeepSeek. Gebruik de base URL https://api.deepseek.com en de modelnaam deepseek-flash. Code voor de OpenAI-SDK werkt zo goed als ongewijzigd. Het model denkt standaard eerst na, en die stap kan je uitzetten.
- In Claude Code of Codex. Voor Claude Code zet je de Anthropic-endpoint https://api.deepseek.com/anthropic in als basisadres. Codex werkt via de Responses API. DeepSeek heeft daarnaast een eigen open agentomgeving, DeepSeek Harness.
- Via OpenRouter. Zo kies je zelf bij welke aanbieder je prompt terechtkomt.
- Zelf draaien. De gewichten staan op Hugging Face en werken met vLLM, SGLang en Transformers. Reken wel op serverhardware: alleen al 552 miljard parameters in 4 bit nemen zowat 276 GB geheugen in. De vorige Flash, met 284 miljard parameters, paste volgens Unsloth in 3 bit op een machine met 128 GB. V4.1 is bijna dubbel zo groot.
Het ging snel sinds het redeneermodel DeepSeek R1. Toen ging het om één goedkoop model, nu om een groot deel van het agentverkeer op OpenRouter.
Veelgestelde vragen
Is DeepSeek V4.1-Flash gratis?
De gewichten zijn gratis te downloaden en mogen onder de MIT-licentie ook commercieel gebruikt worden. Voor de API betaal je per token, bij DeepSeek vanaf 0,15 dollar per miljoen nieuwe inputtokens en 0,60 dollar per miljoen outputtokens in het daltarief.
Wanneer geldt het daltarief van DeepSeek in België?
Op weekdagen buiten de Chinese kantooruren. In de Belgische wintertijd is het piek van 2 tot 5 uur en van 7 tot 11 uur, in de zomertijd een uur later. De rest van de dag, het weekend en Chinese feestdagen betaal je de helft.
Wat is het verschil tussen V4.1-Flash en V4-Pro?
V4-Pro is groter, met 1,6 biljoen parameters, ruim drie keer duurder per outputtoken en het begrijpt geen beelden. V4.1-Flash is nieuwer, sneller en leest wel beelden. Volgens DeepSeek doet Flash het in tests van meerdere partijen beter, maar sommige teams blijven V4-Pro gebruiken omdat hun toepassingen erop afgesteld zijn.
Kijk eerst op de klok, dan naar de prijs
De meeste besparing op DeepSeek zit niet in een korting, maar in het uur waarop je werkt. Omdat de piek samenvalt met de Chinese werkdag, valt de Belgische namiddag, de avond en het hele weekend in het daltarief. Een Europees team dat zijn zware jobs na de middag inplant en de open gewichten bij een host naar keuze draait, krijgt het meest gebruikte model van OpenRouter aan de halve prijs, zonder dat er data naar Hangzhou gaat. Wie rechtstreeks de API van DeepSeek gebruikt, krijgt de cacheprijs van 0,003 dollar, maar moet rekening houden met prijzen en modellen die op korte termijn veranderen.