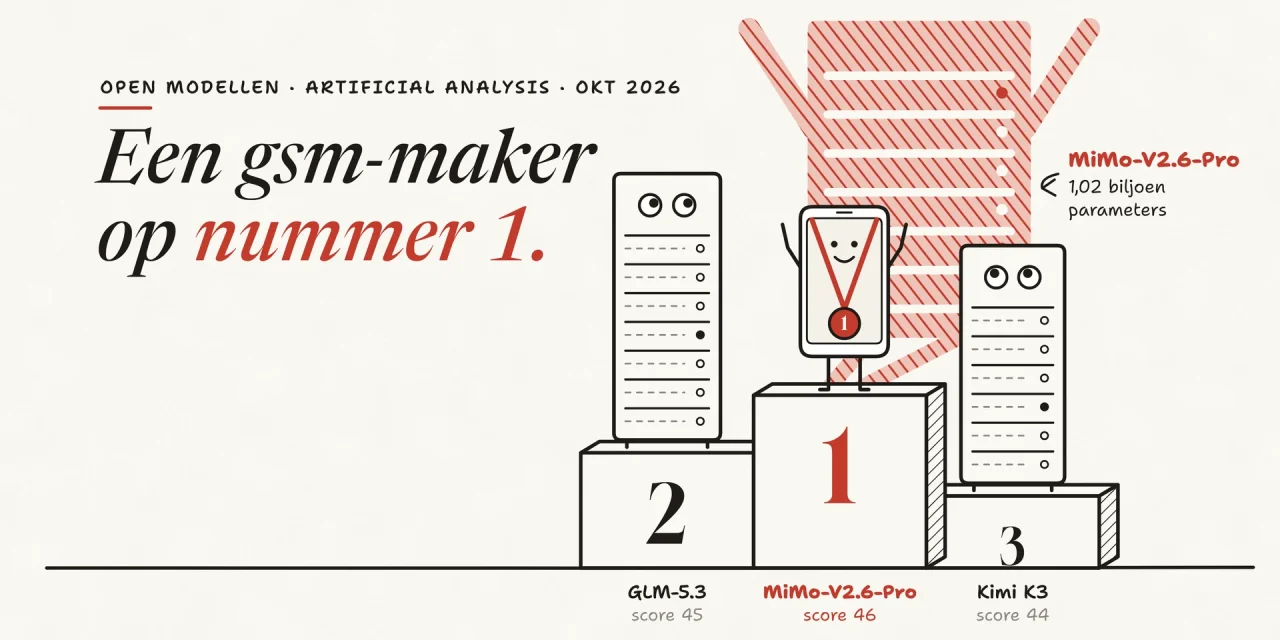
Het sterkste AI-model dat je vandaag vrij kan downloaden, komt van een bedrijf dat vooral gsm’s, robotstofzuigers en elektrische auto’s verkoopt. MiMo-V2.6-Pro van Xiaomi staat sinds 21 september 2026 onder een MIT-licentie op Hugging Face en scoort 46 op de Intelligence Index van Artificial Analysis, het hoogste van alle open modellen. Het kleinere MiMo-V2.6-Flash is deze week het vierde meest gebruikte model op OpenRouter. Hieronder lees je hoe het team van Luo Fuli dat in één jaar klaarspeelde, waarom Xiaomi er miljarden in steekt, hoe je het model zelf gebruikt en waar de kritiek zit.
Wat Xiaomi precies uitbracht
De V2.6-reeks bestaat uit vier modellen. Ze delen dezelfde basis: een sparse mixture-of-experts die per token maar een klein deel van zijn parameters gebruikt, met een contextvenster van 1 miljoen tokens en invoer in tekst, beeld, video en audio. Volgens de modelkaart heeft Pro 384 experts, waarvan er per token 8 meedraaien.
| Model | Parameters (totaal / actief) | Waarvoor | API-prijs per miljoen tokens (in / uit) |
|---|---|---|---|
| MiMo-V2.6-Pro | 1,02 biljoen / 42 miljard | vlaggenschip voor code, agents en lange taken | $0,435 / $0,87 |
| MiMo-V2.6-Pro-UltraSpeed | zelfde model | tot 20 keer snellere uitvoer | $4,35 / $8,70 |
| MiMo-V2.6-Flash | 309 miljard / 15 miljard | goedkoop werkpaard voor veel en snelle oproepen | $0,14 / $0,28 |
| MiMo-V2.6-Distill-Qwen-9B | 9 miljard | klein model om zelf verder te trainen | alleen gewichten |
De prijzen komen uit de aankondiging van Xiaomi. Xiaomi gaf er ook het volledige recept bij: een technisch rapport, meer dan 7.000 trainingsomgevingen voor reinforcement learning, het RL-framework en de kosten van de run. Dat laatste doen weinig labs.
Drie generaties in één jaar
MiMo begon in april 2025 met MiMo-7B, een klein redeneermodel voor wiskunde en code. In november volgde MiMo-Embodied, dat rijden en robotica combineert, en in december MiMo-V2-Flash. Het echte tempo kwam in 2026.
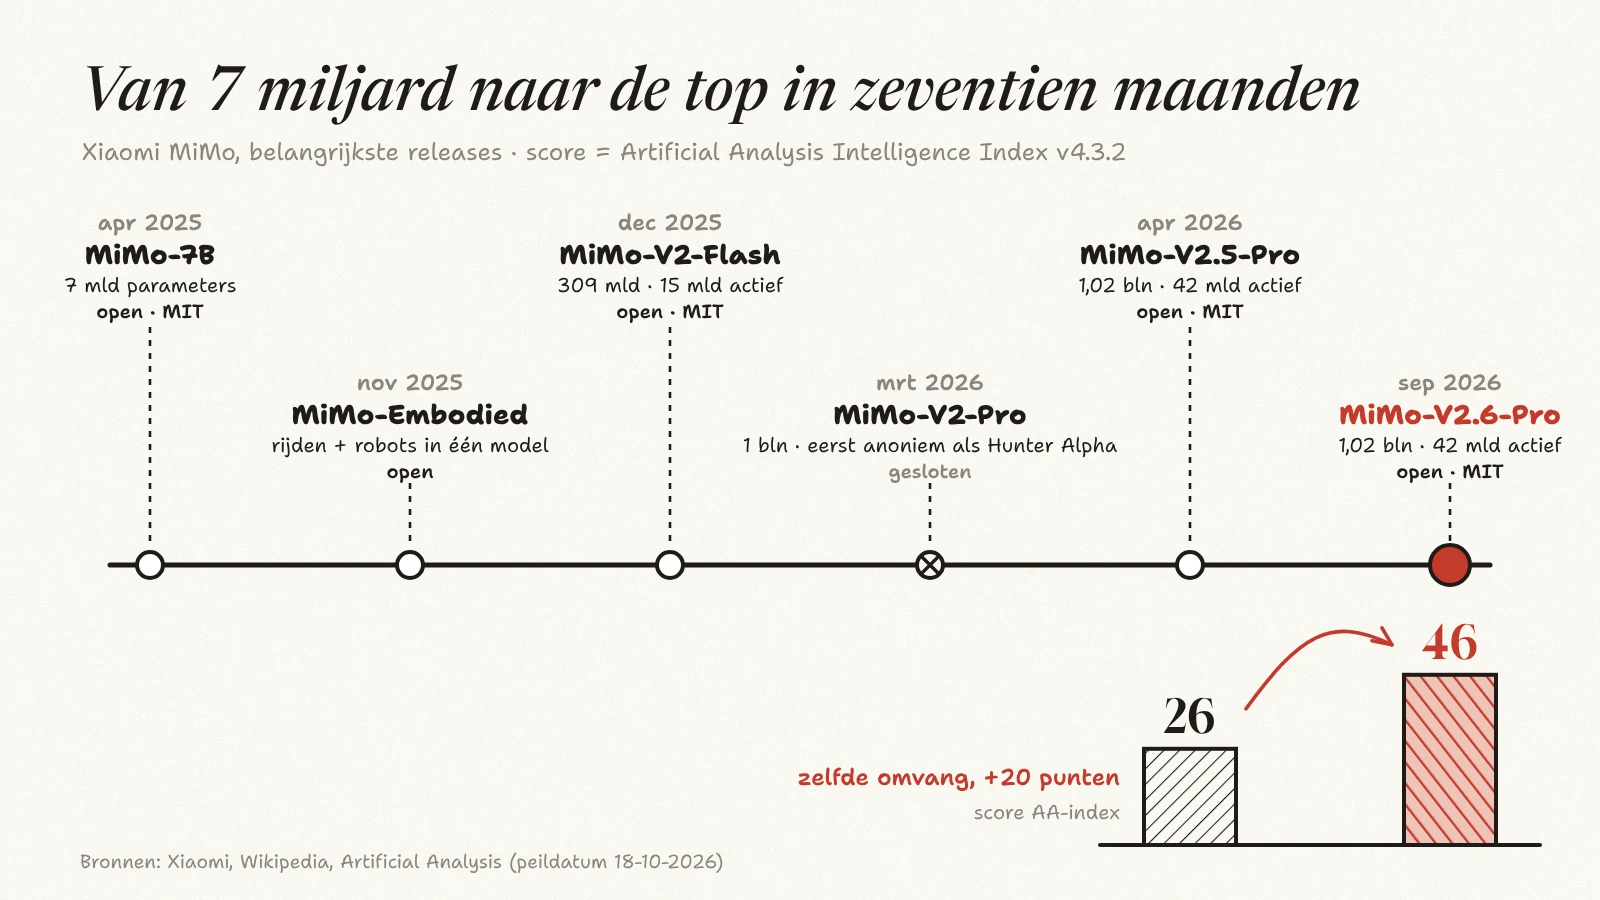
- Maart: MiMo-V2-Pro. Op 11 maart dook op OpenRouter een anoniem, gratis model op, Hunter Alpha, met 1 biljoen parameters. Ontwikkelaars dachten dat DeepSeek stiekem V4 testte. Op 18 maart bleek het een testversie van MiMo-V2-Pro, meldde Reuters. V2-Pro zelf bleef gesloten. Lees ook ons stuk over MiMo-V2-Pro.
- April: MiMo-V2.5. De Pro-versie met 1,02 biljoen parameters kwam wel open, onder MIT, met op de eerste dag ondersteuning voor chips van onder meer AWS, AMD, Baidu Kunlun en T-Head (Xiaomi). Op de huidige Intelligence Index scoort V2.5-Pro 26.
- September: MiMo-V2.6. Dezelfde omvang als V2.5-Pro, maar de score springt van 26 naar 46.
De sprong zit dus niet in een groter model, maar in de training na de pretraining: extra mid-training, een korte fase supervised fine-tuning en een veel grotere RL-run.
Luo Fuli en het team erachter
Het MiMo-team wordt geleid door Luo Fuli. Ze studeerde informatica in Beijing en computationele linguïstiek aan de Universiteit van Peking, werkte aan meertalige modellen bij Alibaba DAMO Academy en daarna bij DeepSeek, waar ze aan DeepSeek-V2 meewerkte. Volgens 36Kr bevestigde ze op 12 november 2025 dat ze bij Xiaomi begon. Op 22 september 2026, de dag van de officiële aankondiging van V2.6, kreeg ze op haar 31ste de hoogste functieschaal binnen Xiaomi.
Groot is het team niet. Volgens Luo werkten enkele dozijnen mensen aan de RL-run van V2.6, en is rekenkracht “brutally scarce”, citeert VentureBeat. Xiaomi hield tijdens de run zelfs een openbaar logboek bij.
Het verschil zit in reinforcement learning
Bij reinforcement learning (RL) probeert een model een taak, krijgt het een beloning als het lukt en past het zich daarop aan. Volgens het technische rapport en de berichtgeving van TechNode:
- Pro en Flash deden elk 30 grote RL-stappen in minder dan zes dagen, goed voor zo’n 750.000 trajecten per model.
- Elke stap telde 1.568 opdrachten met elk 16 pogingen, samen 2,7 tot 3,7 miljard trainingstokens: het gaat om lange agenttaken.
- De run kostte ongeveer $2,62 miljoen voor Pro en $0,85 miljoen voor Flash, op “duizenden GPU’s”.
- 68% van de taken ging over code, de rest over visueel ontwerp, tools, cybersecurity en het volgen van context.
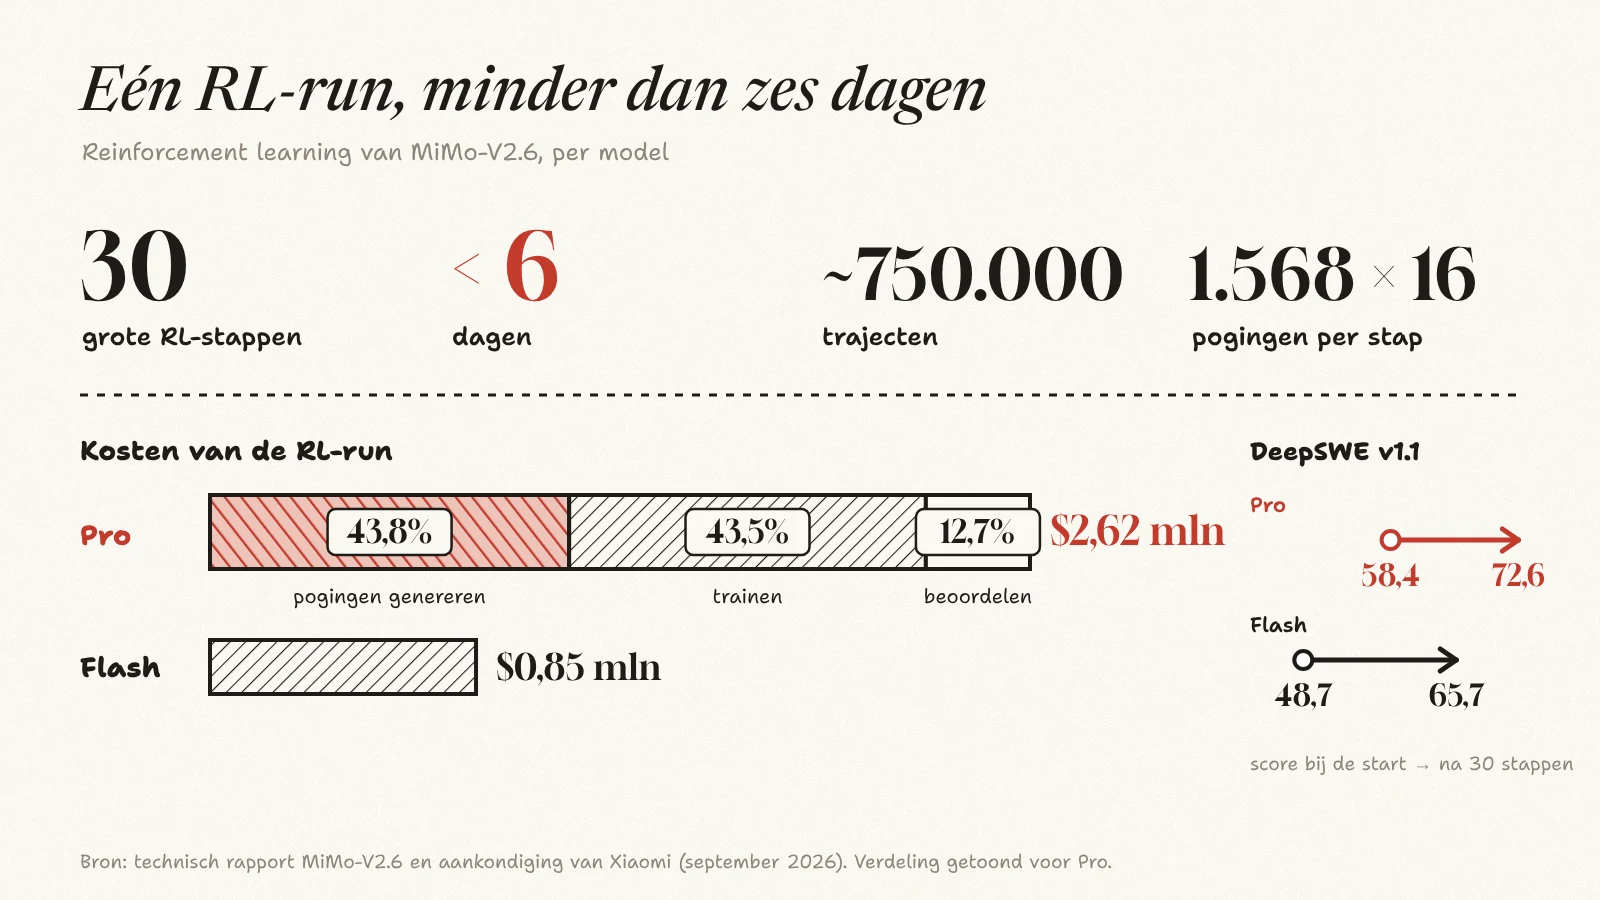
Drie keuzes maken het verschil. Xiaomi trainde alle domeinen in één gemengde run, wat het team “You Only RL Once” noemt. Een beoordelende agent vergelijkt de 16 pogingen van een groep en beloont geslaagde oplossingen die korter en netter zijn, in plaats van alleen te kijken of de tests slagen. En de router, die bepaalt welke experts een token krijgen, werd tijdens de RL bevroren, omdat sommige experts anders overbelast raakten.
Op de codebenchmark DeepSWE steeg Pro tijdens de run van 58,4 naar 72,6, Flash van 48,7 naar 65,7. Pogingen om de beloning te misbruiken, zoals een oplossing uit een latere softwareversie halen, bleven onder 2% en kregen nul punten.
Waarom een gsm- en autobouwer een eigen model wil
Xiaomi verkoopt gsm’s, tablets, huishoudtoestellen en elektrische auto’s, allemaal verbonden via het eigen besturingssysteem HyperOS. Het bedrijf noemt die strategie “Human x Car x Home”. Een eigen model is in die keten het brein dat je niet bij een ander wil huren.
- Geld. Op 19 maart 2026 zei Lei Jun dat Xiaomi de komende drie jaar meer dan 60 miljard yuan, ongeveer 8,7 miljard dollar, in AI steekt. Over vijf jaar gaat er 200 miljard yuan naar onderzoek in chips, AI en besturingssystemen (Yicai).
- Toestellen. Xiaomi testte in maart MiClaw, een AI-agent in het besturingssysteem van de gsm die op MiMo draait. Sinds juli levert het MiMo-team ook het basismodel voor de assistent Xiao Ai (36Kr).
- Chips. Met de XRING O1 bouwt Xiaomi sinds 2025 zijn eigen gsm-chip. Lei Jun wil eigen chip, eigen besturingssysteem en eigen model samenbrengen in één toestel.
- Auto’s en robots. MiMo-Embodied combineert rijden en robotica al in één model. De V2.6-demo’s tonen een gesimuleerde robotarm die het model via camerabeelden aanstuurt.
Open publiceren past in die logica. Hoe meer ontwikkelaars MiMo in hun tools gebruiken, hoe meer feedback Xiaomi krijgt, zonder zelf een ecosysteem van nul te bouwen. Meer over dat bredere veld lees je in ons overzicht van de 40 meest innovatieve AI-labs in China.
Hoe goed is MiMo-V2.6-Pro echt?
Bij de open modellen staat Pro eerste bij Artificial Analysis, met GLM-5.3 van Z.ai op 45 en Step 5 Preview en Kimi K3 op 44. Het gesloten Grok 4.7 haalt ook 46. Het beste gesloten model, Claude Opus 5.5, scoort 58. MiMo is dus niet het beste model ter wereld, wel het beste dat je zelf kan draaien. Het nieuwe Muse Spark Open van Meta blijft op 39 steken.
De agentbenchmarks van Xiaomi zelf tonen een genuanceerder beeld. Op Terminal Bench 2.1 haalt Pro 89,9 tegenover 89,1 voor Claude Opus 5, maar op de zwaardere Terminal Bench 4.0 is het 34,9 tegen 49,0 en op ProgramBench 26,5 tegen 37,0. Op de onafhankelijke Vals Index zijn Flash en Pro met ruim 59% de beste open modellen, tegenover 69,7% voor Claude Opus 5.5, schrijft The Batch.
Waar MiMo wint, is de prijs. Artificial Analysis rekent voor Pro ongeveer $0,13 per taak van de index, tegenover rond $2 voor GLM-5.3 en Kimi K3. Flash scoort zelf 38 en is nog goedkoper. Tim Dettmers, onderzoeker aan Carnegie Mellon, vond dat Flash “feels like the best model in the 300B to 550B class”.
De licentie en wat je ermee mag
De gewichten van Pro, Flash en de 9B-versie vallen onder de MIT-licentie: gratis gebruiken, aanpassen, verder trainen en commercieel inzetten mag zonder toestemming van Xiaomi. De trainingsdata zijn niet open.
Welke hardware je nodig hebt om het zelf te draaien
Open betekent niet licht, ook al zijn de officiële bestanden al gecomprimeerd tot grotendeels 4-bit.
| Model | Bestandsgrootte | Wat je ongeveer nodig hebt |
|---|---|---|
| Pro (officieel) | 534 GiB | het vLLM-recept gebruikt 8 GPU’s, het SGLang-recept 2 servers met samen 16 GPU’s |
| Flash (officieel) | 165,5 GiB | 4 GPU’s in het vLLM-recept, of een Mac met 256 GB geheugen |
| Flash (GGUF Q2_K) | 117,7 GiB | een machine met ruim 128 GB geheugen, bijvoorbeeld 192 GB, met kwaliteitsverlies |
| Distill-Qwen-9B (Q8) | ongeveer 9 GiB | een gewone laptop met een degelijke GPU of een Mac |
De groottes komen van Hugging Face op 18 oktober 2026. Reken voor Pro op datacenter-GPU’s met veel geheugen, in de klasse van de H200 of B200. Eén gebruiker haalde met Flash 59 tokens per seconde op een Mac Studio M3 Ultra met 256 GB. Sinds 22 september (Flash) en 2 oktober (Pro) staan er GGUF-versies van ggml-org online, de organisatie achter llama.cpp.
Zo gebruik je MiMo vandaag
- Via de API van Xiaomi op platform.xiaomimimo.com, met de prijzen hierboven, een batchmodus aan de halve prijs en abonnementen van 6 tot 100 dollar per maand. Let op: de modelnamen van V2.5 werken vanaf 21 oktober niet meer.
- Via OpenRouter, waar Flash ook bij aanbieders als DeepInfra, Novita en GMICloud draait. Volgens de ranglijst van OpenRouter verwerkte Flash deze week 10,3 biljoen tokens, na DeepSeek V4.1 Flash, Step 5 Preview en GLM 5.3 Flash. De grootste gebruikers zijn agenttools zoals Cline en Hermes Agent.
- In de eigen apps: MiMo Studio, de desktopapp en de programmeeragent MiMo Code.
- Lokaal, met vLLM, SGLang of llama.cpp.
Werk je met gevoelige data, let dan op de route. De API van Xiaomi draait op servers in China. Wie de data in Europa wil houden, draait het model zelf of kiest een aanbieder die zegt waar zijn servers staan.
Kritiek en beperkingen
De beschuldiging van Anthropic. In een rapport over misbruik van Claude, gepubliceerd op 10 september, noemt Anthropic Xiaomi bij zeven Chinese labs die Claude zouden gebruiken om hun eigen modellen te trainen. Volgens The Decoder gaat het bij Xiaomi om meer dan 400.000 uitwisselingen in twintig dagen in maart en april 2026: gesprekken en programmeersessies van MiMo-gebruikers zouden via de tools OpenClaw en OpenCode naar Claude zijn doorgestuurd. Xiaomi reageerde tot nu toe niet. Of die data in V2.6 terechtkwam, is niet aangetoond.
Benchmarks van de maker zelf. Bijna alle agentcijfers komen van Xiaomi, deels op eigen tests zoals MiMo Code Bench, die niemand anders draait.
Herhalende tool-calls. Na de release bleek dat het model in agenttaken soms dezelfde tool-call blijft herhalen zonder vooruit te gaan. De MOPD-versies van Pro en Flash van 27 september beperken dat: neem die als je de gewichten gebruikt.
Traag en spraakzaam. Artificial Analysis meet voor Flash zo’n 52 tokens per seconde en 5 seconden tot het eerste token, trager dan de meeste open modellen. Het verbruikt ook veel uitvoertokens, wat de lage tokenprijs deels tenietdoet.
Chinese chips? Daanish Khazi, CEO van Paper Instruments, schreef dat de run volledig op Chinese chips draaide. Het rapport noemt geen merk, dus die claim is niet bevestigd.
Wat een gsm-maker hier bewijst
De top van de open modellen ligt niet meer alleen bij gespecialiseerde AI-labs. Een hardwarebedrijf met een compact team en een RL-run van minder dan drie miljoen dollar bracht in 2026 drie generaties uit en haalde de beste score. De ranglijst kan binnen weken omslaan, het recept dat Xiaomi erbij gaf blijft. Als een nieuwe ronde post-training op een model van dezelfde omvang de score van 26 naar 46 tilt, dan wordt die fase na de pretraining het terrein waar ook kleinere spelers kunnen meedoen. Wie open modellen volgt, houdt dus best niet alleen DeepSeek en Qwen in het oog, maar ook de bedrijven die er een eigen toestel mee willen vullen.
Veelgestelde vragen
Is Xiaomi MiMo gratis?
De gewichten van MiMo-V2.6-Pro, Flash en de 9B-versie zijn gratis te downloaden onder een MIT-licentie, ook voor commercieel gebruik. Via de API betaal je per token, bij Pro $0,435 per miljoen invoertokens en $0,87 per miljoen uitvoertokens.
Wat is het verschil tussen MiMo-V2.6-Pro en Flash?
Pro heeft 1,02 biljoen parameters, waarvan 42 miljard actief, en scoort 46 bij Artificial Analysis. Flash heeft 309 miljard parameters, waarvan 15 miljard actief, scoort 38 en kost ongeveer een derde van Pro. Op de meeste agenttaken van Xiaomi ligt Flash maar enkele punten achter.
Is MiMo beter dan DeepSeek?
Op de Intelligence Index wel: MiMo-V2.6-Pro scoort 46, DeepSeek V4.1 Flash 39. Maar op OpenRouter verwerkt DeepSeek V4.1 Flash deze week ruim drie keer zoveel tokens.