Nvidia bracht op 28 oktober Nemotron 3.5 Transcribe uit, een gratis spraakmodel met open gewichten dat opnames in 40 talen uitschrijft, vertaalt en vragen over de inhoud beantwoordt. Nederlands zit in de hoogste kwaliteitsklasse, met vier tot zes fouten per honderd woorden op Nvidia’s eigen tests. Eén ding ontbreekt voor Nederlandstalige vergaderingen: het model zegt in het Nederlands niet wie wat zei. Het werkt ook alleen met opgenomen audio, niet live.
Hieronder lees je wat het model doet, hoe goed het Nederlands echt is, wat je nodig hebt om het zelf te draaien en wanneer je beter iets anders kiest.
Wat Nemotron 3.5 Transcribe doet
Nemotron 3.5 Transcribe is geen klassiek spraakherkenningsmodel dat alleen woorden uitspuwt. Het is een taalmodel met oren: een spraak-encoder hangt aan Nemotron 3.5 Lightning, het tekstmodel dat Nvidia in augustus uitbracht. Je stuurt het met een gewone opdracht in tekst, zoals bij een chatbot. Volgens de modelkaart op Hugging Face kan één en hetzelfde model:
- letterlijk uitschrijven, met elke eh en herhaling, of een nette geschreven versie maken;
- een lijst met namen en vaktermen meekrijgen, zodat het die juist spelt;
- sprekers uit elkaar houden en elk woord een tijdstempel geven;
- vertalen van en naar het Engels, voor 31 talen;
- de taal herkennen en vragen over de opname beantwoorden (dat laatste alleen in het Engels getraind).
Een opname mag tot een uur duren en tot acht sprekers bevatten. Het model telt 34 miljard parameters, maar per stap rekent er maar zo’n 4,3 miljard mee. Dat is de truc van een mixture-of-experts: groot in kennis, snel in gebruik. Alle parameters moeten wel in het geheugen passen, dus in volle precisie heb je een kaart met 80 GB nodig. Er bestaan ook compactere versies voor kleinere kaarten.
Hoe goed verstaat het Nederlands?
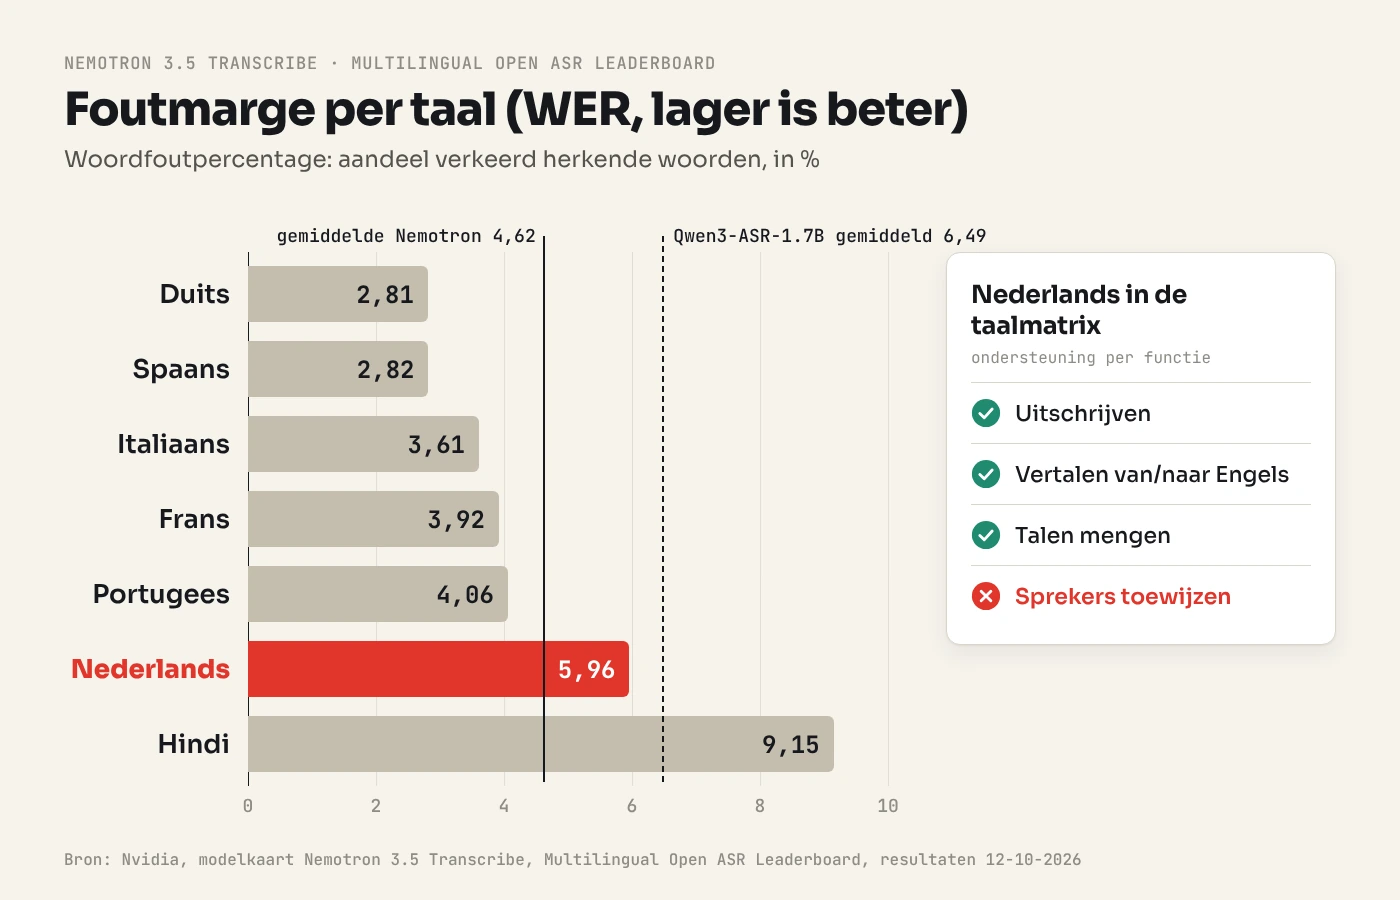
Nvidia deelt de 40 talen in drie klassen in. Nederlands staat in de hoogste, “Leading”, samen met onder meer Engels, Frans, Duits, Spaans, Pools en Tsjechisch. Op FLEURS, een test met voorgelezen zinnen, haalt het een word error rate (WER) van 3,75% voor het Nederlands. Op de zwaardere meertalige test van de Open ASR Leaderboard, met meer gevarieerde opnames, is dat 5,96%. Dat betekent dat ongeveer zes op de honderd woorden fout, vergeten of te veel zijn.
Dat is goed, maar niet het beste van de zeven talen in die tweede test. Duits (2,81%) en Spaans (2,82%) scoren duidelijk beter, alleen Hindi doet het slechter. Gemiddeld over de zeven talen komt Nemotron uit op 4,62%. Het volgende open model in Nvidia’s vergelijking, Qwen3-ASR-1.7B van Alibaba, haalt 6,49%. Ook in het Engels staat het volgens de blog van Nvidia en Hugging Face bovenaan de open modellen op de Open ASR Leaderboard, met gemiddeld 5,33%.
Twee kanttekeningen. Dit zijn cijfers van Nvidia zelf, op testsets met vooral voorgelezen en nette spraak. En Vlaams staat nergens apart. In een HOGENT-studie die we bij Voxtral 3 van Mistral bespraken, maakten vijf geteste spraakherkenners in 2024 op Vlaamse spraak 5 tot 12 procentpunt meer fouten dan op Nederlandse. Nemotron zat daar niet bij, maar er is geen reden om aan te nemen dat het die kloof helemaal overbrugt. Reken er dus op dat een vergadering in tussentaal minder strak uitgeschreven wordt dan de 5,96% doet vermoeden.
Een onafhankelijke meting is er wel voor het Engels: bij Artificial Analysis haalt Nemotron 2,81%, nipt achter het open model Voxtral Small van Mistral met 2,77%, meldt The Decoder. Op die onafhankelijke meting staat Nvidia dus net niet bovenaan, en betalende diensten zoals de nieuwste Voxtral 3-modellen scoren daar nog iets beter.
Wie zei wat? Niet in het Nederlands
Sprekers herkennen is een van de paradepaardjes van dit model. Een aparte module voor sprekerdetectie geeft zijn signalen rechtstreeks door aan het taalmodel, zodat het tijdens het schrijven al weet wie aan het woord is. Op Nvidia’s test met door elkaar pratende mensen doet het beter dan systemen die uitschrijven en sprekers scheiden in twee aparte stappen.
Alleen: die functie werkt in 13 talen, en Nederlands is er niet bij. In de taalmatrix staat bij Nederlands “ja” voor uitschrijven, vertalen en het mengen van talen in één zin, maar “nee” voor uitschrijven met meerdere sprekers. Frans, Duits, Spaans, Italiaans en Portugees kunnen het wel.
Voor een Vlaamse kmo die vergaderingen wil laten notuleren is dat de belangrijkste beperking. Je krijgt een correcte tekst, maar zonder “Spreker 1” en “Spreker 2”. Er zijn twee omwegen. Je kan een apart model laten bepalen wie wanneer spreekt en dat koppelen aan de tijdstempels per woord die Nemotron wel geeft. Of je past het model zelf aan: Nvidia toonde aanpassingen aan nieuwe talen en taken die 0,5 tot 2,3 uur rekentijd op één GPU kostten. Beide vragen technisch werk, dus test eerst met je eigen opnames.
Alleen opnames, niet live
Transcribe is gebouwd voor bestanden: een podcast, een interview, een opgenomen Teams-vergadering, een dictaat. Het knipt de audio intern in stukken van 30 seconden, maar Nvidia benadrukt dat dit geen live-modus is. Wil je live ondertitelen of een voice agent bouwen, dan heb je iets anders nodig.
Nvidia heeft daarvoor zelf een kleiner broertje: Nemotron 3.5 ASR Streaming, een model van 600 miljoen parameters uit juni. Dat schrijft live mee in 40 taalvarianten, waarvan 19 meteen klaar voor gebruik, Nederlands inbegrepen, met een foutmarge tussen 11,5% en 14% op de FLEURS-test, afhankelijk van hoe snel het moet reageren. Wie liever een dienst gebruikt, kijkt naar de realtimemodellen van Mistral of naar Eleven Realtime van ElevenLabs.
Wat heb je nodig om het zelf te draaien?
De referentie is één Nvidia H100 met 80 GB geheugen, een kaart voor datacenters. Op de lijst staan ook de RTX 5090 en RTX PRO 6000 voor werkstations, de A100, H200 en Blackwell-chips voor servers, en de DGX Spark. De gewichten bestaan in BF16, FP8 en NVFP4 (een compact 4-bitformaat voor Blackwell-kaarten), plus een GGUF-versie voor NeMo-Speech.cpp, waarmee het ook rechtstreeks op Windows draait.
Snel is het zeker. Op een H100 rekent de modelkaart met 260 tot 410 keer sneller dan realtime: een uur audio in 9 tot 14 seconden. Nvidia’s paradecijfers liggen nog hoger. Eén RTX PRO 6000 Blackwell zou honderd uur audio in minder dan drie minuten verwerken, tot 2.238 keer realtime. Dat haal je alleen met Nvidia’s eigen NIM-container en optimalisaties die nog niet open zijn. De open versie met vLLM is volgens Nvidia ongeveer half zo snel.
Ontwikkelaars serveren het model met vLLM achter een API die dezelfde vorm heeft als die van OpenAI, zodat bestaande code weinig hoeft te veranderen. Wie geen eigen GPU heeft, vindt gehoste versies bij Baseten, DeepInfra en Simplismart. Prijzen daarvan vonden we nog niet.
De licentie is OpenMDW-1.1 van de Linux Foundation, die commercieel gebruik toelaat. Dat maakt het interessant voor wie gevoelige opnames heeft: als je het zelf draait, verlaat de audio je eigen server niet. Dat lost niet alles op onder de GDPR, want een opname van een stem blijft een persoonsgegeven, maar je hoeft geen externe verwerker te vertrouwen. Wie al eens keek naar AI-modellen die op je eigen toestel draaien, kent die afweging.
Leren spellen wat jij zegt
Het sterkste argument voor bedrijven is misschien niet de basisscore, maar hoe makkelijk je het model bijstuurt. Geef je een lijst met verwachte namen en termen mee, dan halveert de foutmarge op Nvidia’s contexttest (van 3,33% naar 1,71%). Bij opnames van kwartaalcijfers steeg het aandeel juist herkende sleutelwoorden van 58% zonder lijst naar 96% met een lijst per fragment.
Gaat het om echt vakjargon, dan kan je het model bijtrainen. Nvidia deed dat met medische opnames van Indiase artsen. Een betere opdracht bracht de foutmarge van 30,8% naar 23,8%, bijtrainen bracht ze naar 11,8%. Dat kostte ongeveer 14 GPU-uren op één GB300, en het Engels in het algemeen werd daar nauwelijks slechter van (van 1,54% naar 1,69%). Nvidia raadt aan om minstens honderd echte, nagekeken opnames apart te houden om het resultaat te controleren.
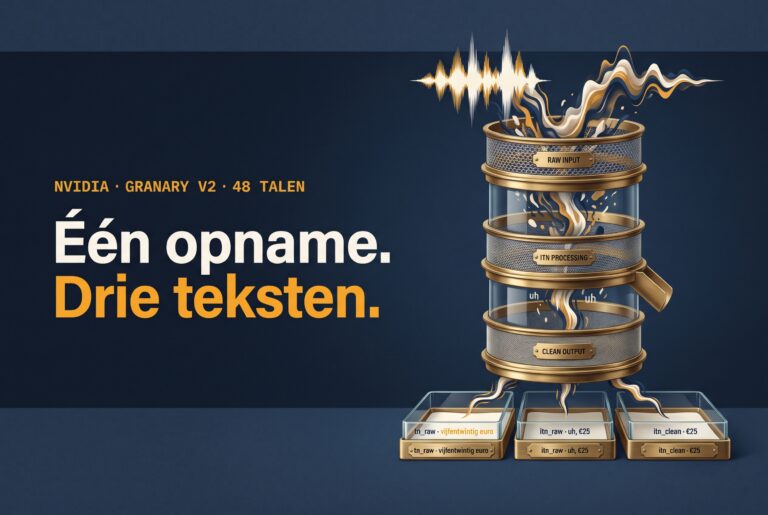
Om dat bijtrainen makkelijker te maken, bracht Nvidia tegelijk Granary v2 uit, een open spraakdataset met 463.062 uur audio in 48 talen, tegenover 25 talen in de eerste versie. De audio zelf haal je bij de oorspronkelijke bronnen, onder hun eigen licentie.
Voor wie het nu al de moeite loont
Heb je veel opnames met één spreker, zoals dictaten, interviews, podcasts of archiefmateriaal, en wil je die niet naar een clouddienst sturen? Dan is Nemotron 3.5 Transcribe vandaag een van de sterkste gratis opties voor het Nederlands. Voor vergaderverslagen met meerdere Nederlandstalige sprekers en voor alles wat live moet, is het nog niet af. TechCrunch noemt dit terecht een drukke maand voor spraak-AI: Mistral, ElevenLabs en Salesforce brachten in oktober ook nieuwe modellen uit. Het verschil zit dus steeds minder in de score en steeds meer in wat een model in jouw taal en met jouw opnames kan. Test het met tien eigen opnames, inclusief een paar in tussentaal, voor je beslist.
Veelgestelde vragen
Is Nemotron 3.5 Transcribe gratis?
Ja. De gewichten zijn gratis te downloaden onder de OpenMDW-1.1-licentie, die ook commercieel gebruik toelaat. Je betaalt wel voor de hardware of voor een gehoste dienst.
Kan het Vlaams?
Nvidia geeft geen cijfers voor Vlaams. Nederlands zit in de hoogste klasse, maar spraakherkenners maken op Vlaamse spraak doorgaans meer fouten. Test met je eigen opnames.
Werkt het live, bijvoorbeeld voor ondertitels tijdens een vergadering?
Nee. Het verwerkt alleen opgenomen audio, tot een uur per bestand. Voor live werk is er Nemotron 3.5 ASR Streaming, een kleiner model van Nvidia.
Kan ik het op mijn laptop draaien?
Op een gewone laptop niet. Je hebt een krachtige Nvidia-kaart nodig, zoals een RTX 5090, een RTX PRO 6000 of een DGX Spark, of je gebruikt een gehoste versie.