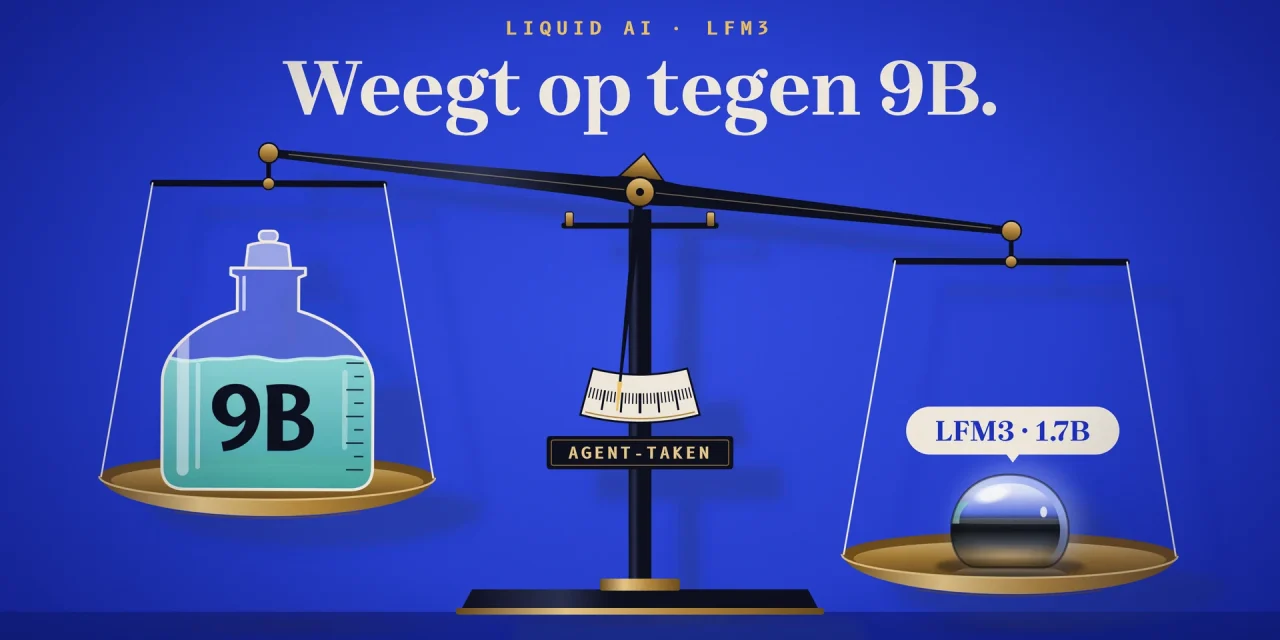
Liquid AI bracht op 27 oktober 2026 LFM3 uit: zes open modellen van ongeveer 2 miljard parameters, gebouwd op één gedeeld basismodel. Het tekstmodel LFM3-1.7B past bij 4-bit in ongeveer 1 GB geheugen en haalt op agenttaken volgens Liquid het niveau van modellen die vijf keer groter zijn. Het is gemaakt om lokaal te draaien, op je gsm, laptop of een Raspberry Pi, en om het bij te trainen voor één taak. Wie in het Nederlands wil werken, moet wel opletten: het spraakmodel spreekt Nederlands, de tekstmodellen officieel niet.
Wat is LFM3?
LFM staat voor Liquid Foundation Models. Liquid AI is een spin-off van het MIT-lab CSAIL en haalde eind 2024 250 miljoen dollar op in een ronde onder leiding van AMD. Waar de grote labs steeds grotere modellen in de cloud bouwen, maakt Liquid kleine modellen die op het toestel zelf draaien. Mercedes-Benz werkt met Liquid aan een spraakassistent voor in de auto die zonder cloud werkt, met een eerste productie gepland vanaf de tweede helft van 2026.
LFM3 is de derde generatie. Alle zes modellen zijn afgeleid van hetzelfde basismodel, LFM3-1.7B-Base, dat op 22 biljoen tokens getraind werd. De gewichten staan gratis op Hugging Face, samen met versies voor llama.cpp, MLX, ONNX en GPU-servers.
| Model | Wat het doet | Context | Talen |
|---|---|---|---|
| LFM3-1.7B | tekst, agents en tools aanroepen | 256K tokens | 16 talen, zonder Nederlands |
| LFM3-VL-2B | beeld en video lezen, documenten, schermen | 128K tokens | 16 talen, zonder Nederlands |
| LFM3-Audio-2B | spraak verstaan en spreken | 32K tokens | 18 spraaktalen, met Nederlands |
| LFM3-Omni-2B | tekst, beeld, video en audio tegelijk | 32K tokens | tekst zonder, spraak met Nederlands |
| d1-2B | beslissingen op tekst en beeld | 128K tokens | 16 talen, zonder Nederlands |
| d1-Omni-2B | beslissingen, ook op audio | 128K tokens | 16 talen, zonder Nederlands |
Hoe krijgt Liquid een agent in 1 GB?
Dat zit in de bouw van het model. De meeste taalmodellen bestaan volledig uit attention-lagen: elke laag kijkt naar alle vorige tokens, en het geheugen daarvoor (de KV-cache) groeit mee met de lengte van je tekst. LFM3 mengt drie soorten lagen. Van de 24 lagen zijn er 13 korte convoluties die alleen naar de woorden vlak ervoor kijken en bijna geen geheugen vragen. Vijf lagen kijken naar een venster van 256 tokens. Slechts zes lagen zien de hele context.
Het resultaat zie je in het geheugen. Voor een volle context van 128K tokens heeft LFM3-1.7B 1,6 GB KV-cache nodig. Qwen3.5-4B vraagt daarvoor 4,3 GB en MiniCPM5-2B 5,6 GB. Liquid koos de verdeling niet op papier maar met metingen op 14 combinaties van toestellen en software, van een Samsung Galaxy S26 Ultra en een Raspberry Pi 5 tot de NPU van Qualcomm. Bij 32K context genereert LFM3-1.7B volgens Liquid op drie geteste toestellen 1,8 tot 2,8 keer sneller tekst dan het volgende model in de vergelijking.
Het laatste stuk van de training, 3,5 biljoen tokens, bestond uit zorgvuldiger gekozen data met veel voorbeelden van agents die tools gebruiken. Daarna volgden nog vier trainingsrondes, waaronder reinforcement learning binnen echte agent-omgevingen zoals OpenClaw en Hermes Agent.
Waar LFM3 wint en waar het verliest
Liquid zet LFM3-1.7B in zijn modelkaart naast vijf andere kleine modellen, met Qwen3.5-9B van Alibaba als zwaarste tegenstander. Op agenttaken is het verschil groot. Op WebArena-Verified, waar een agent taken op websites moet afwerken, scoort LFM3-1.7B 38,42 tegenover 28,94 voor Qwen3.5-9B. De vorige versie, LFM2.5-2.6B, haalde er amper 3,02. Op AutomationBench is het 41,29 tegenover 15,10, en ook bij tools aanroepen (BFCL V4) en instructies volgen (IFEval) staat LFM3 voor. Over alle 29 scores samen haalt het gemiddeld 49,37, net boven de 47,24 van Qwen3.5-9B.
Er is ook een externe test. Softwarebedrijf MacPaw liet LFM3-1.7B en Qwen3.5-2B 65 alledaagse taken uitvoeren op echte Macs. LFM3 werkte 64 procent af tegenover 48 procent, met 58 procent minder tokens per taak. Het liep in minder dan 1 procent van de pogingen vast, tegenover 15 procent bij Qwen.
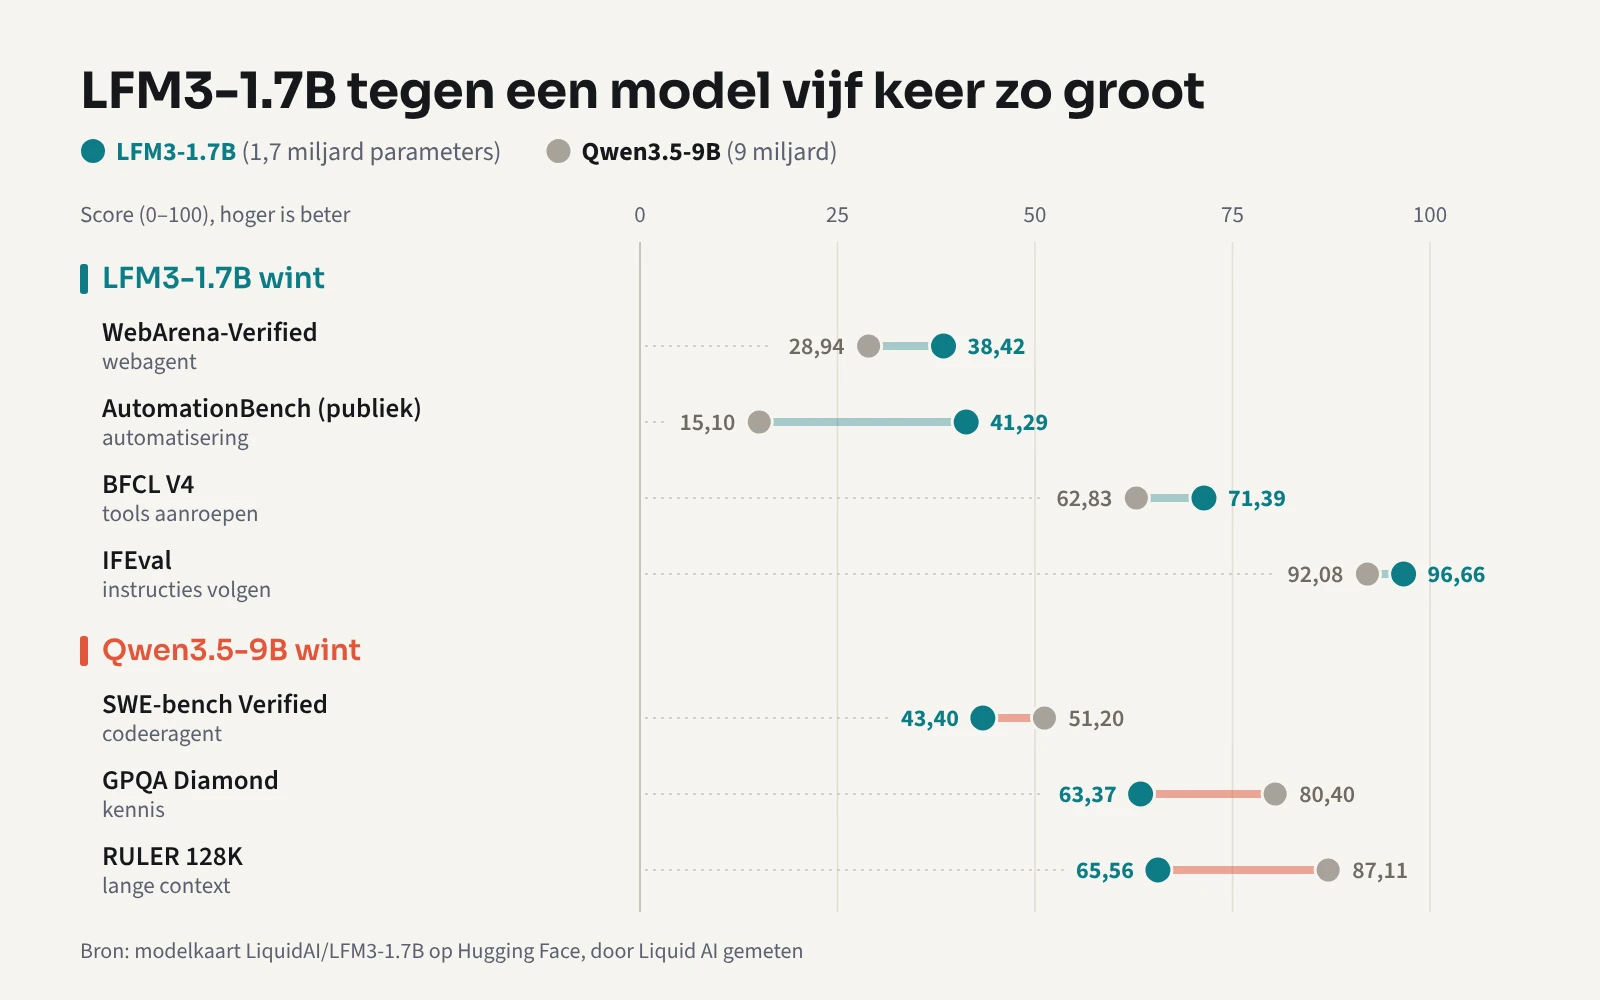
Waar kennis of diep redeneren telt, wint het grotere model. Op GPQA Diamond, wetenschapsvragen op doctoraatsniveau, haalt Qwen3.5-9B 80,40 tegenover 63,37. Als codeeragent op SWE-bench Verified is het 51,20 tegenover 43,40. En hoewel LFM3 256K tokens context aankan, vindt het in lange teksten minder goed terug wat het zoekt: 65,56 op RULER 128K tegenover 87,11. Liquid zegt het zelf in de modelkaart: het model is niet bedoeld voor codeeragents of complex redeneren in veel stappen.
Eén cijfer verdient aandacht. Op de kennistest AA-Omniscience beantwoordt LFM3-1.7B maar 7 procent van de vragen juist. Maar van de vragen die het niet juist beantwoordt, zegt het in bijna 93 procent dat het iets niet weet, in plaats van te gokken. Bij Qwen3.5-9B is dat 53 procent. Dat maakt LFM3 slecht als vraagbaak, maar bruikbaar in een agent die zelf opzoekt: met een zoektool verdubbelt de score op Humanity’s Last Exam bijna, van 7,17 naar 13,90.
Belangrijk: al deze cijfers komen van Liquid zelf. Onafhankelijke metingen zijn er een dag na de lancering nog niet.
Spreekt LFM3 Nederlands?
Hier wordt het voor Vlaamse gebruikers interessant. Het tekstmodel LFM3-1.7B ondersteunt officieel 16 talen: Engels, Frans, Duits, Italiaans, Spaans, Portugees en Pools, plus onder meer Arabisch, Chinees, Japans en Hindi. Nederlands staat er niet bij. Hetzelfde geldt voor het beeldmodel en voor de tekstkant van het Omni-model.
Het spraakmodel LFM3-Audio-2B noemt Nederlands wel, naast onder meer Zweeds, Deens, Fins en Turks: 18 spraaktalen in totaal. Maar ook daar is er een kanttekening. De meertalige benchmark voor spraakherkenning meet negen talen, en Nederlands is er niet een van. Hoe goed het model Nederlands, laat staan Vlaams, verstaat, weet je dus pas als je het zelf test. Dezelfde vraag over Vlaams stelden we bij Voxtral 3 van Mistral.
Wat betekent dat in de praktijk? Voor Franse en Duitse teksten zit je goed. Voor Nederlandse tekst kan het model werken, want het heeft veel meer gezien dan de officiële lijst, maar Liquid belooft niets. De nette oplossing is bijtrainen. Liquid levert een notebook waarin het model met gewone tekst een nieuwe taal leert, met Turks als voorbeeld. Dezelfde aanpak werkt in principe voor Nederlands, op één GPU.
De andere vijf modellen
LFM3-VL-2B leest beeld en, als eerste vision-model van Liquid, ook video. Over 62 benchmarks haalt het gemiddeld 71,4. Gemma 4 12B, dat meer dan zes keer groter is, scoort 71,7. Een medewerker van Liquid noemt het op Hacker News een sterk OCR-model voor zijn grootte: het leest tekst uit beelden, zeker na bijtrainen op je eigen formaat.
LFM3-Audio-2B kan volgens Liquid al vanaf 50 milliseconden antwoorden, omdat het je spraak verwerkt terwijl je nog praat. Op VoiceBench, een test voor gesproken opdrachten, gaat het van 55,2 naar 73,1 tegenover de vorige versie.
LFM3-Omni-2B combineert alles: je kan het een vraag stellen over een video met geluid, en het antwoordt in tekst of spraak. Het verslaat volgens Liquid Qwen2.5-Omni-7B op Daily-Omni met 70,1 tegenover 61,3. Toch zijn de losse modellen elk in hun eigen domein sterker, gaf een Liquid-medewerker op Hacker News toe. Kies dus het model voor de taak, niet het model dat alles kan.
d1-2B en d1-Omni-2B geven geen lopende tekst maar een getypt antwoord: ja of nee, een keuze, een score, een telling of een uitgelezen datum, telkens met een waarschijnlijkheid erbij. Zulke decision models gebruik je als poortwachter in een agent, net zoals Strands Decider 2B van AWS.
Hoe ver bijtrainen gaat, toont Liquid met een voorbeeld uit de industrie. Het trainde LFM3-VL-2B enkele uren op één A100-GPU met zo’n 3.000 dronefoto’s van windturbines. Daarna herkende het model het soort defect in 67 procent van de testbeelden. Voor het bijtrainen lag dat, net als bij GPT-6 Luna, onder 10 procent.
Wat mag je ermee?
LFM3 is open-weight, maar niet vrij van voorwaarden. De LFM Open License v1.0 is gebaseerd op Apache 2.0, met één grote uitzondering. Commercieel gebruik is gratis voor bedrijven met minder dan 10 miljoen dollar jaaromzet. Zit je daarboven, dan valt commercieel gebruik buiten deze licentie en heb je een aparte overeenkomst met Liquid nodig. Voor onderzoek en niet-commercieel gebruik geldt geen drempel.
Voor de meeste Belgische kmo’s is LFM3 dus gratis. Grotere bedrijven hebben voor elk commercieel gebruik een aparte licentie nodig, ook voor een interne test met een zakelijk doel. Vraag het Liquid dus vooraf. Verspreid je het model of een bijgetrainde versie, dan geef je de licentie mee en laat je de vermeldingen van Liquid staan.
Zo probeer je LFM3 zelf
- In je browser: de Liquid Playground draait alle modellen zonder installatie (je hebt wel een account nodig).
- Op je computer: download de GGUF-versie voor Ollama of LM Studio, of de MLX-versie op een Mac. Het tekstmodel past op een gewone recente laptop.
- Stel de juiste temperatuur in: Liquid raadt 0,1 aan voor chat, tools en agents.
- Geef een systeemprompt: het model is getraind om in een agent te werken en verwacht soms tools die er niet zijn. Een gebruiker op Hacker News zag het over tools nadenken bij een gewone kennisvraag, al bleek zijn lokale server standaard twee tools mee te sturen. Een Liquid-medewerker raadt aan om in de systeemprompt te zeggen dat er geen tools zijn als je gewoon wil chatten.
- Via een API: Liquid heeft een eigen API, maar publiceerde nog geen prijzen. OpenRouter is launchpartner, maar op 28 oktober stond LFM3 er nog niet tussen.
Wil je een volledig lokale agent opzetten, dan helpt het om te weten wat een harness doet. Dat lees je in ons stuk over Harness² van Google.
Een klein model is een onderdeel, geen chatbot
Wie LFM3 naast ChatGPT of Claude legt, mist het punt. Een model van 1 GB vervangt geen groot model voor moeilijke vragen. Het wordt interessant als onderdeel dat continu op de achtergrond draait: mails sorteren, velden uit facturen halen, beslissen welke taak naar welk groter model gaat. Omdat tokens lokaal niets kosten, kan je er veel tegelijk laten lopen. Liquid liet als demo meer dan 300.000 LFM3-agents parallel het e-mailarchief van Enron doorzoeken. Een ontwikkelaar op Hacker News doet het op kleine schaal al: een LFM-model labelt al zijn mails en berichten, en alleen wat het onzeker vindt, gaat naar een groter model. Dat is waarschijnlijk hoe de meeste bedrijven kleine modellen zullen gebruiken: als de eerste lijn die het meeste werk wegfiltert, lokaal en zonder dat je data het toestel verlaat.
Veelgestelde vragen
Is LFM3 gratis?
Ja, voor onderzoek en voor bedrijven met minder dan 10 miljoen dollar jaaromzet. Daarboven heb je voor commercieel gebruik een aparte licentie van Liquid AI nodig.
Draait LFM3 op een gsm?
Het tekstmodel neemt bij 4-bit ongeveer 1 GB geheugen in. Liquid mat de snelheid op een iPhone 17 Pro en gebruikte onder meer de Samsung Galaxy S26 Ultra en een Raspberry Pi 5 bij het ontwerp. Je hebt wel een app nodig die llama.cpp of een vergelijkbare runtime gebruikt.
Spreekt LFM3 Nederlands?
Het spraakmodel LFM3-Audio-2B ondersteunt Nederlands officieel. Het tekstmodel LFM3-1.7B niet: Nederlands staat niet bij de 16 talen. Frans en Duits wel.
Kan LFM3 ChatGPT vervangen?
Nee. Het is sterk in afgebakende agenttaken en tools aanroepen, maar zwak in algemene kennis en complex redeneren. Gebruik het voor één taak, liefst met een zoektool of je eigen documenten erbij.