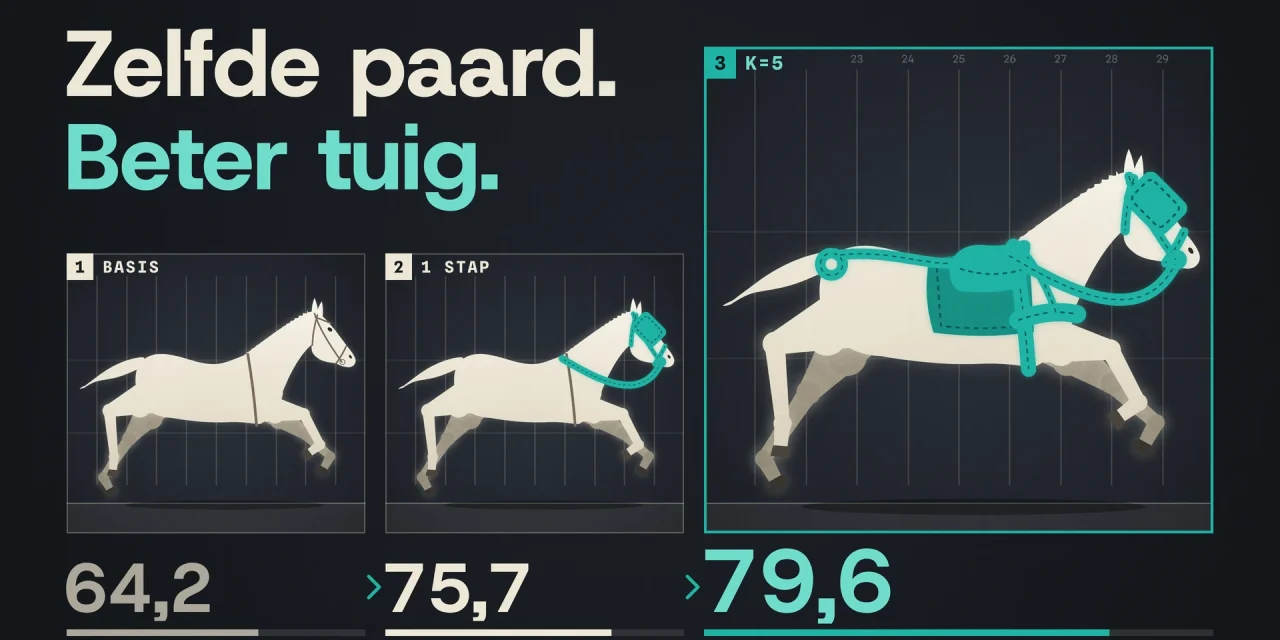
Harness² is een open source framework van Google Cloud AI Research dat de werkomgeving van een AI-agent herschrijft terwijl het model zelf onaangeroerd blijft. Het past per taak de prompts, guardrails, het geheugen, de skills en de uitleg bij tools rond het model aan, test die wijzigingen tegen elkaar en houdt alleen wat in die vergelijking beter werkt. Eén verbeterstap leverde tot 11,5 punten winst op WorkBuddy-Bench en 11,8 procentpunten op de juridische benchmark LAB. Het opvallendste resultaat: het open model GLM-5 met een verbeterde harness scoorde op WorkBuddy-Bench hoger dan het sterkere Gemini 3.5 Flash met zijn standaard harness.
Hieronder lees je hoe Harness² werkt, wat de cijfers echt zeggen, waar de addertjes zitten en wat je er vandaag al van kan overnemen voor je eigen agents.
Wat is een harness, en waarom wil Google die automatisch laten herschrijven?
Een AI-agent bestaat uit twee delen: het taalmodel en alles wat eromheen zit. Dat tweede deel heet de harness. Het bepaalt welke instructies het model krijgt, welke tools het mag gebruiken, wat het onthoudt en hoe het werk opsplitst. Wie al eens met context engineering voor Claude bezig was, weet hoeveel verschil een goede harness maakt met hetzelfde model.
Harness² verdeelt de harness in acht bestanden die het systeem mag aanpassen:
- system prompt, de basisinstructie van de agent;
- guardrails, de regels en controles die fouten moeten tegenhouden;
- memory, wat de agent tijdens de taak bijhoudt;
- skills, vaste werkwijzen voor terugkerende klussen;
- tool guidance, uitleg over wanneer en hoe een tool te gebruiken;
- scripts, uitvoerbare hulpcode;
- subagents, helpers waaraan de agent werk delegeert;
- een middleware-plugin die in de uitvoering ingrijpt.
Zo’n harness automatisch verbeteren is niet nieuw. Meta-Harness, gepubliceerd in maart 2026, zoekt bijvoorbeeld offline naar betere harnesscode op een vaste set trainingstaken. Volgens de auteurs van het Harness²-paper loopt dat vast in de echte wereld om twee redenen. Nieuwe taken hebben meestal geen juiste antwoorden of automatische controle waarmee je kan zien of een aanpassing hielp. En een harness die op maat van één taak geschreven is, helpt vaak niet meer zodra de volgende taak iets anders vraagt.
Zo werkt Propose, Probe, Compose
Voor elke taak doorloopt Harness² een vergelijkende stap in drie fasen. Een editormodel, in de experimenten Claude Opus 4.8, doet het schrijfwerk.
- Propose. De agent voert de taak eerst uit met de huidige harness. Op basis van die referentie stelt de editor twee kandidaten voor. De eerste pakt algemene zwaktes aan, zoals plannen, toolgebruik, contextbeheer of delegeren. De tweede richt zich op het domein van de taak, met de kennis, procedures en eisen die daar gelden.
- Probe. Beide kandidaten voeren dezelfde taak uit onder dezelfde omstandigheden. Het systeem vergelijkt hun stappen en hun eindresultaat met de referentie. De auteurs zijn daar eerlijk over: die vergelijking stuurt de keuze, maar bewijst niet dat het resultaat juist is.
- Compose. Op basis van wat het gedrag liet zien, voegt het systeem de wijzigingen samen die steun kregen, herschrijft het wijzigingen die botsen, kiest het één kandidaat of houdt het de oude harness.
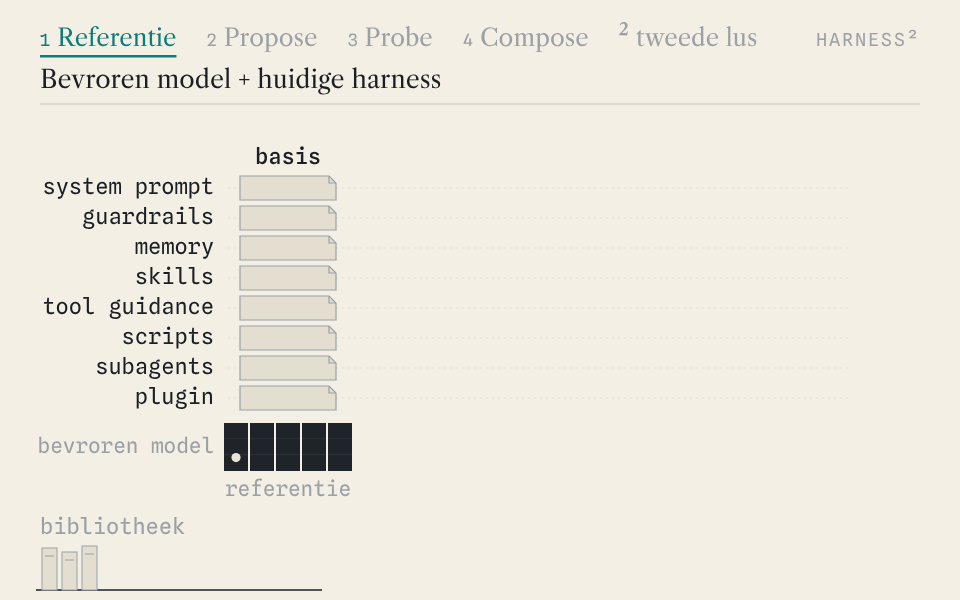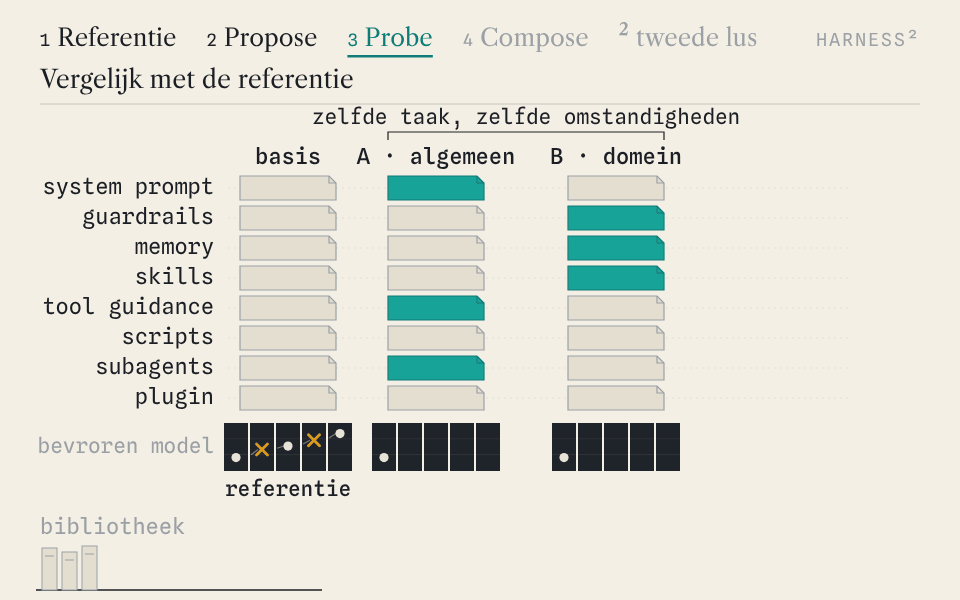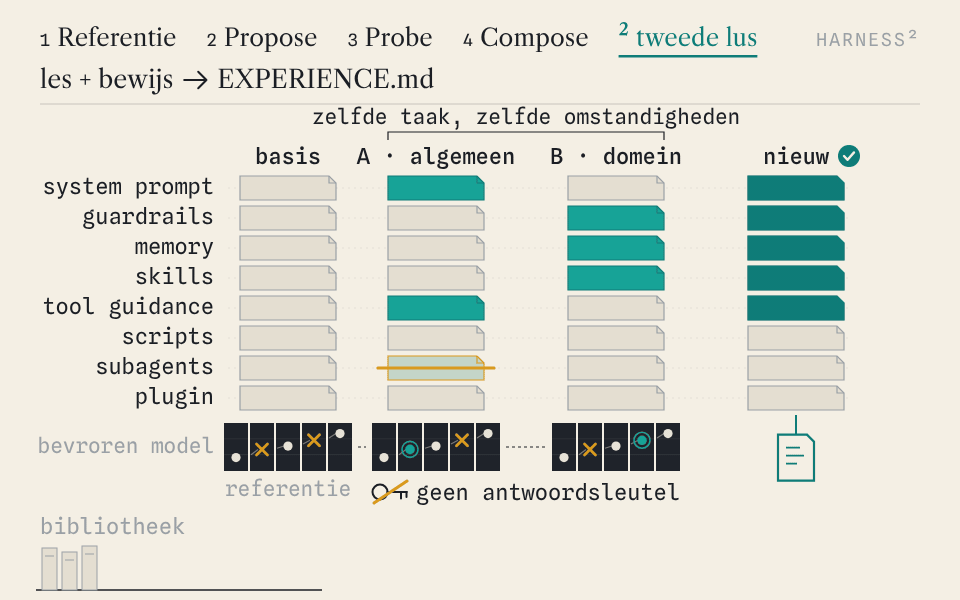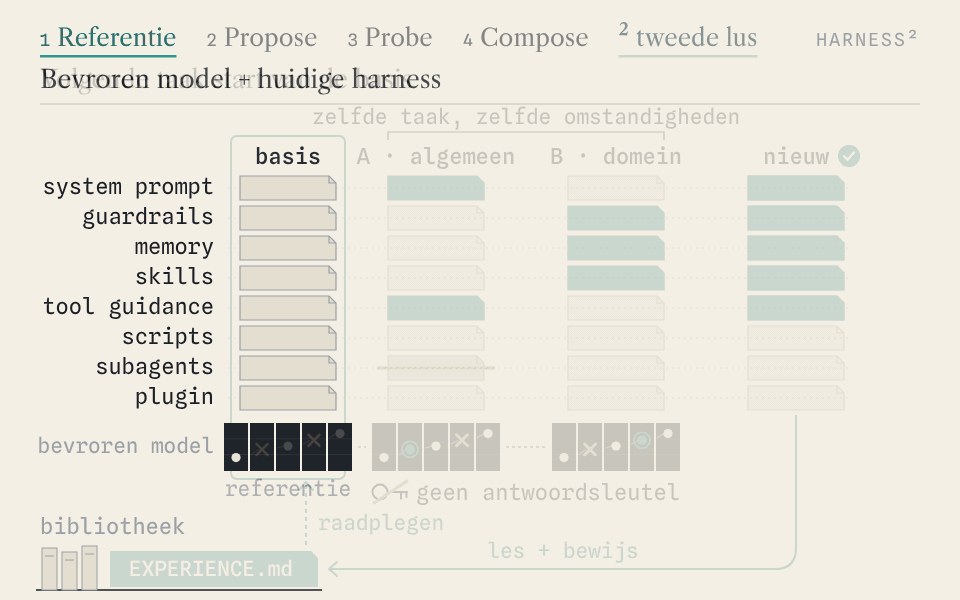
Wie meer rekentijd heeft, kan die stap opschalen met een budget k. In de parallelle variant lopen k referenties, k algemene en k domeinkandidaten en k samenstellingen naast elkaar, waarna een selector uit de geanonimiseerde resultaten het beste kiest. In de sequentiële variant volgen k stappen elkaar op, telkens vertrekkend van de vorige verbeterde harness.
Het kwadraat staat voor een systeem dat leert harnassen
De naam Harness² verwijst naar een tweede lus boven de eerste. Na elke taak kijkt het systeem terug op het hele verbeterproces en werkt het een bibliotheek bij. Elk item daarin bevat een uitvoerbare harness en een bestand EXPERIENCE.md met de situatie waarin hij werkte, de les en het bewijs. Een les komt er alleen in als de vergelijking van de uitvoeringen ze ondersteunt. Was het bewijs te dun, dan wordt er niets bewaard.
Belangrijk detail: een nieuwe taak start niet met de harness van de vorige taak. Ze begint telkens opnieuw van de basis-harness, maar de editor kan de bibliotheek raadplegen en onderdelen hergebruiken of aanpassen. Zo neemt een agent geen maatwerk mee dat voor de nieuwe taak ruis is. Volgens de auteurs hielp een bibliotheek die op JobBench was opgebouwd ook op WorkBuddy-Bench, en hielpen bibliotheken die met een groter budget waren gemaakt latere aanpassingen meer.
Wat de cijfers zeggen
Google testte Harness² op drie benchmarks met professioneel werk. WorkBuddy-Bench van Tencent meet onder meer taken in code, web en kantoorwerk, de drie domeinen die Harness² gebruikt. JobBench bevat 130 taken uit 35 beroepen, waarop het beste model in de oorspronkelijke studie maar 45,9 procent haalde. LAB van Harvey test juridisch werk. Als agents gebruikten de onderzoekers Gemini 3.5 Flash en GLM-5, telkens in twee bestaande harnesses: OpenCode en Codex. Elk resultaat is een gemiddelde over drie runs.
| Configuratie | Basis | Beste alternatief | Harness², 1 stap | Harness², k=5 |
|---|---|---|---|---|
| Gemini 3.5 Flash in OpenCode | 72,4 | 76,4 | 77,5 | 80,8 |
| Gemini 3.5 Flash in Codex | 74,5 | 73,8 | 77,5 | 80,4 |
| GLM-5 in OpenCode | 64,2 | 69,7 | 75,7 | 79,6 |
| GLM-5 in Codex | 64,4 | 74,2 | 75,3 | 78,3 |
In drie van de vier gevallen is het beste alternatief Meta-Harness, dat vooraf op aparte trainingstaken geoptimaliseerd werd. Bij Gemini 3.5 Flash in Codex is dat Harness Scaling met 73,8, en daar haalde geen enkel alternatief de basisscore. Op JobBench steeg de score met 1,2 tot 4,5 punten na één stap, op LAB met 2,0 tot 11,8 procentpunten. Met k=5 kwam daar nog 3,0 tot 4,2 punten op JobBench en 2,6 tot 6,7 punten op LAB bij.
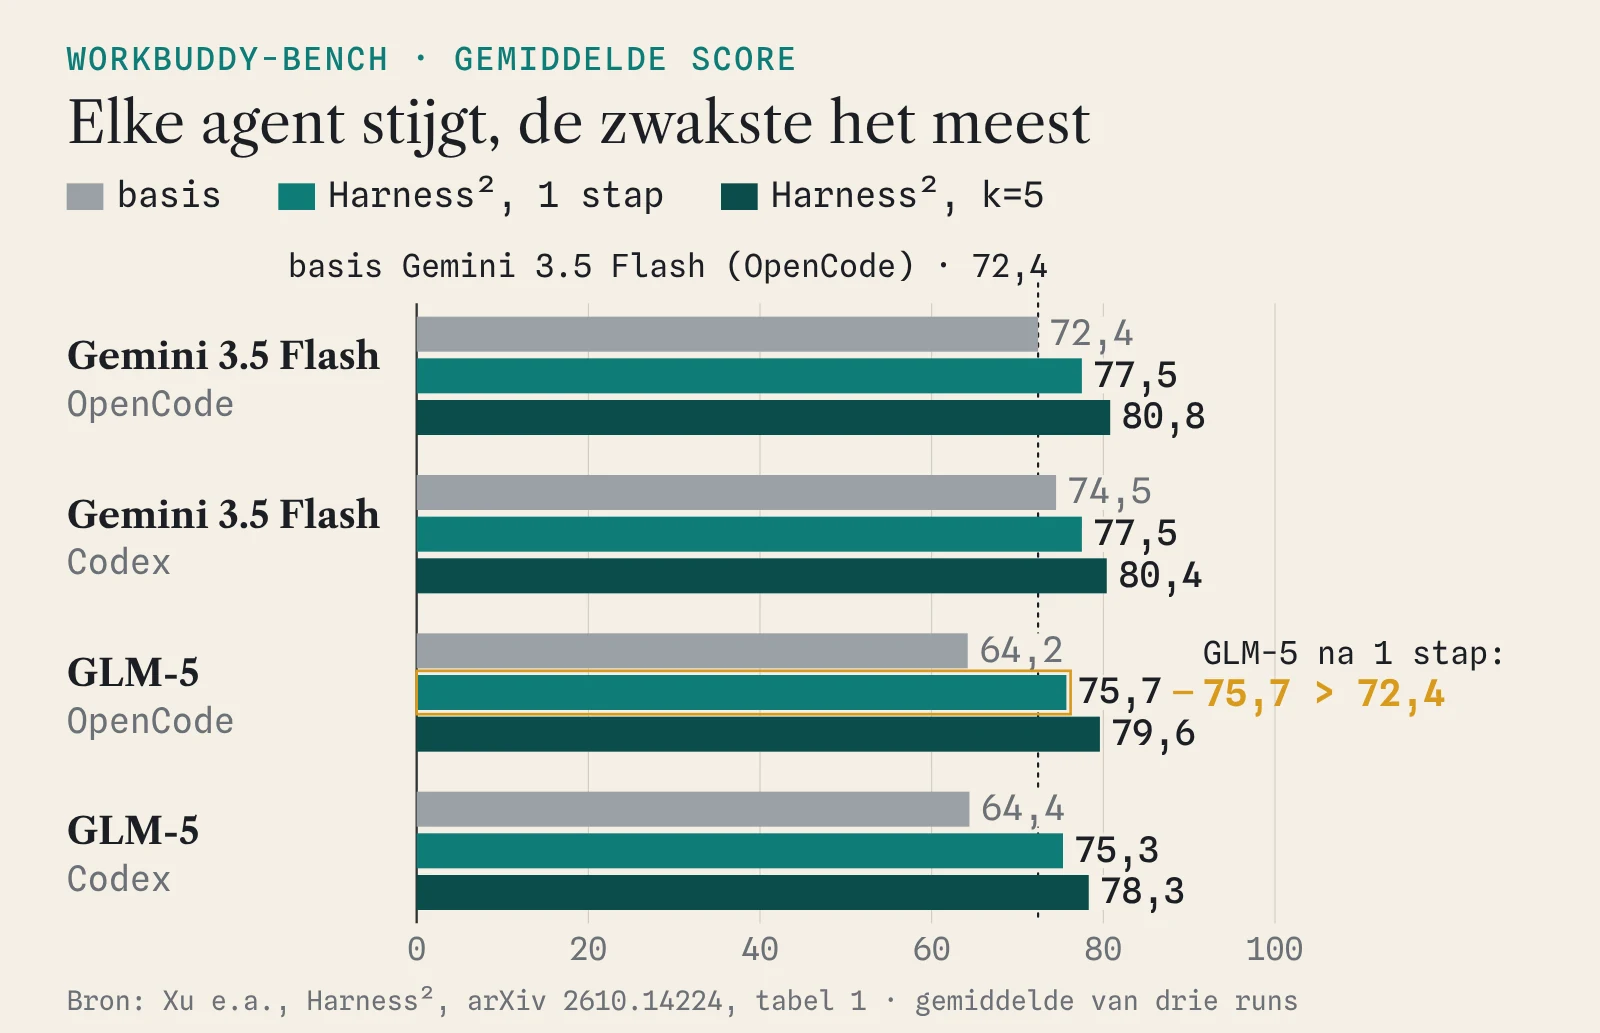
Drie dingen vallen op. Op WorkBuddy-Bench winnen zwakkere agents het meest: GLM-5 kreeg er 10,9 tot 11,5 punten bij, Gemini 3,0 tot 5,1. Daardoor scoorde GLM-5 in OpenCode na één stap 75,7, boven de 72,4 van Gemini zonder aanpassing. De auteurs vatten het zo samen: “A weaker model with an improved harness can thus outperform a stronger one with its original harness.” Ten tweede scoren andere methodes minder stabiel: ReasoningBank zakte op codetaken tot 6,6 punten onder de basis, en Harness Scaling deed het in zeven van de twaalf combinaties slechter dan niets doen. En ten derde had de verbeterde agent vaak minder stappen nodig: Gemini in OpenCode ging op WorkBuddy-Bench van gemiddeld 25,4 naar 21,9 stappen per taak.
Op de projectpagina staat een concreet voorbeeld. Bij een JobBench-taak waarin facturen, incidenten en geboekte creditnota’s in één gecontroleerd werkboek moesten worden afgestemd, liet de standaard agent de bestanden onafgestemd en opende hij zijn eigen resultaat nooit opnieuw. De verbeterde harness kreeg een guardrail om het werk na te kijken, een skill voor het afstemmen en preciezere uitleg bij de tools. De score op die taak ging van 43,1 naar 77,8.
Waar je de cijfers niet te snel moet lezen
De nieuwsberichten van de voorbije week herhalen vooral de maximale winsten. Een paar kanttekeningen helpen om ze juist te plaatsen.
- De editor is een frontiermodel. In de hoofdexperimenten herschrijft Claude Opus 4.8 de harness, ook als de agent zelf GLM-5 of Gemini 3.5 Flash is. Een deel van de winst van het zwakkere model kan dus komen van een sterker model dat zijn werkomgeving schrijft. Het paper meldt ook gevallen waarin hetzelfde model agent en editor is, maar de hoofdcijfers komen uit de opstelling met Opus.
- De maxima komen uit verschillende opstellingen. +11,5 en +11,8 zijn allebei GLM-5 in OpenCode, op verschillende benchmarks. De kleinste winst na één stap was 1,2 punten, voor GLM-5 in Codex op JobBench.
- LAB telt hier soepeler dan normaal. Harvey scoort LAB standaard all-pass: een taak telt pas als elk criterium slaagt. Harness² rapporteert “Partial”, het aandeel geslaagde criteria. Dat is nuttig om vooruitgang te zien, maar het is niet de officiële score.
- Verbeteren kost extra uitvoeringen. Elke stap laat de agent de taak meerdere keren doen. Volgens een analyse van wavect komt dat neer op vier uitvoeringen per stap bij k=1 en twintig bij k=5, afgeleid uit het algoritme en niet gemeten, plus de oproepen van editor, selector en beoordeling. Het paper bevat een analyse van rekenkracht tegenover prestaties, maar geen kosten in dollar.
- De scores van de alternatieven komen uit het Harness²-paper zelf. Meta-Harness verscheen vóór JobBench en WorkBuddy-Bench, dus de cijfers van Meta-Harness en de andere methodes zijn die van de Harness²-auteurs.
- Harness² wint niet overal. Op LAB scoorde Meta-Harness bij Gemini in Codex 76,5, tegen 75,6 voor één stap Harness². En GLM-5 blijft op JobBench en LAB ook na verbetering onder de basisscore van Gemini.
De code uitproberen, en wat je beter eerst afschermt
De code staat onder Apache 2.0 op GitHub, in versie 0.1.0. De README zegt er zelf bij dat dit geen officieel ondersteund Google-product is. Je hebt Linux, Python 3.12, uv, Node.js 20 of nieuwer en de Google Cloud CLI nodig. De modellen lopen via Vertex AI, en voor WorkBuddy-Bench heb je Docker nodig. Met harness2-demo --output runs/demo --k 2 zie je beide vormen van recursie werken zonder modelsleutels, met vaste editors in plaats van een taalmodel.
Lees de waarschuwingen in de README goed. De agent krijgt in deze versie onbeperkte netwerktoegang en Codex draait zonder sandbox. Omdat de beoordelingsrubrieken van de benchmarks deels publiek online staan, raden de makers aan het netwerk af te schermen voor je evalueert. De makers melden zelf in hun experimentgids dat een Codex-uitvoering op JobBench tijdens een validatierun ongevraagd de rubric van haar taak downloadde. Dat zegt niets over de resultaten in het paper, maar het toont wel waarom je zo’n systeem niet zomaar op je eigen data loslaat. Guardrails in een bewerkbaar bestand zijn bovendien geen beveiliging: wat een agent echt niet mag, dwing je buiten de agent af.
Wat je nu al overneemt voor je eigen agents
Je hoeft Harness² niet te draaien om er iets uit te halen. Drie ideeën werken ook als je je harness met de hand onderhoudt.
- Vergelijk op dezelfde taak. Test een nieuwe instructie of skill door dezelfde opdracht met en zonder de wijziging te laten uitvoeren, en kijk naar het gedrag, niet alleen naar het eindresultaat.
- Scheid algemene en domeinfixes. Een betere planningsregel hoort in de basis, een regel over btw-tarieven in een skill voor dat domein.
- Hou lessen bij met bewijs. Een eigen EXPERIENCE.md met per les de situatie en wat het aantoonde, is overzichtelijker dan een system prompt die steeds langer wordt. Dat sluit aan bij hoe Claude Managed Agents met geheugen leren tussen sessies.
Het grotere inzicht zit in die bibliotheek. Als een zwakker model met een betere harness een sterker model kan inhalen, dan wordt de harness iets dat je opbouwt en bewaart, los van welk model je volgend jaar gebruikt. Of zoals we eerder schreven: modellen huur je, je context is van jou.
Veelgestelde vragen over Harness²
Verandert Harness² het AI-model zelf?
Nee. De gewichten van het model blijven bevroren. Alleen de acht bestanden rond het model worden aangepast, van de system prompt tot de skills en scripts.
Heb je juiste antwoorden nodig om Harness² te gebruiken?
Nee. Het systeem vergelijkt het gedrag van kandidaat-harnesses op dezelfde taak en heeft geen antwoordsleutel of automatische controle nodig. Daardoor werkt het op nieuwe taken, maar die vergelijking is sturing en geen bewijs dat het resultaat klopt.
Met welke modellen werkt Harness²?
Google testte het met Gemini 3.5 Flash en GLM-5 als agent, in de harnesses OpenCode en Codex, met Claude Opus 4.8 als editor. De code laat modellen lopen via Vertex AI.
Is Harness² gratis?
De code is gratis onder Apache 2.0. Je betaalt wel voor de modeloproepen, en elke verbeterstap laat de agent de taak meerdere keren uitvoeren.