Meta-Harness is een methode van onderzoekers van Stanford, MIT en KRAFTON waarbij een AI-agent de code rond een AI-model herschrijft, terwijl het model zelf onaangeroerd blijft. Het geheim zit in wat die agent te lezen krijgt: niet alleen de scores van eerdere pogingen, maar alle ruwe logboeken, tot zo’n tien miljoen tokens per ronde. Daarmee klopte een automatisch gevonden harness de beste handgemaakte harnassen waarmee de zoektocht begon, op een zware codeerbenchmark. Hieronder lees je hoe het werkt, wat de cijfers echt zeggen en wat je er vandaag al voor je eigen agents uit haalt.
Wat is een harness, en wat doet Meta-Harness ermee?
Een harness is alle code rond een taalmodel: de systeemprompt, welke tools het mag gebruiken, wat het onthoudt, welke voorbeelden het te zien krijgt en wanneer een taak als klaar geldt. Claude Code is een harness rond Claude, Codex een harness rond de modellen van OpenAI. Hoeveel dat uitmaakt, is groot. De auteurs wijzen in hun paper op een studie waarin alleen een andere harness rond hetzelfde model tot zes keer betere resultaten leidde op dezelfde test.
Zo’n harness bouwen mensen vandaag nog grotendeels met de hand. Meta-Harness draait dat om. Een coding agent stelt een nieuwe harness voor, die wordt getest, en alles wat daarbij gebeurt gaat naar een gewone map met bestanden. In de volgende ronde leest de agent die map en stelt hij iets beters voor. Het model waar alles om draait, blijft bevroren. Alleen de code eromheen verandert.
De naam zegt dus letterlijk wat het is: een harness die harnassen maakt. De paper van Yoonho Lee, Roshen Nair, Qizheng Zhang, Kangwook Lee, Omar Khattab en Chelsea Finn verscheen eind maart 2026 en werd gepresenteerd op COLM 2026. Een kortere versie stond als poster op een workshop van ICML 2026.
Zo werkt de zoektocht, ronde na ronde
De lus is eenvoudig. De onderzoekers starten met een paar werkende harnassen, bijvoorbeeld een bestaande agent. Daarna herhaalt de lus vier stappen.
- De voorsteller, in de experimenten Claude Code met Opus 4.6, doorzoekt de map met alle eerdere kandidaten.
- Hij schrijft een of meer nieuwe harnassen, als gewone Python-code.
- Elke kandidaat die de controle van de interface doorstaat, draait op de taken.
- Broncode, score en de volledige uitvoeringslogs van die run komen in de map erbij.
Na de laatste ronde krijg je niet één winnaar, maar de beste afwegingen tussen nauwkeurigheid en kost. Een run duurt volgens de auteurs enkele uren.
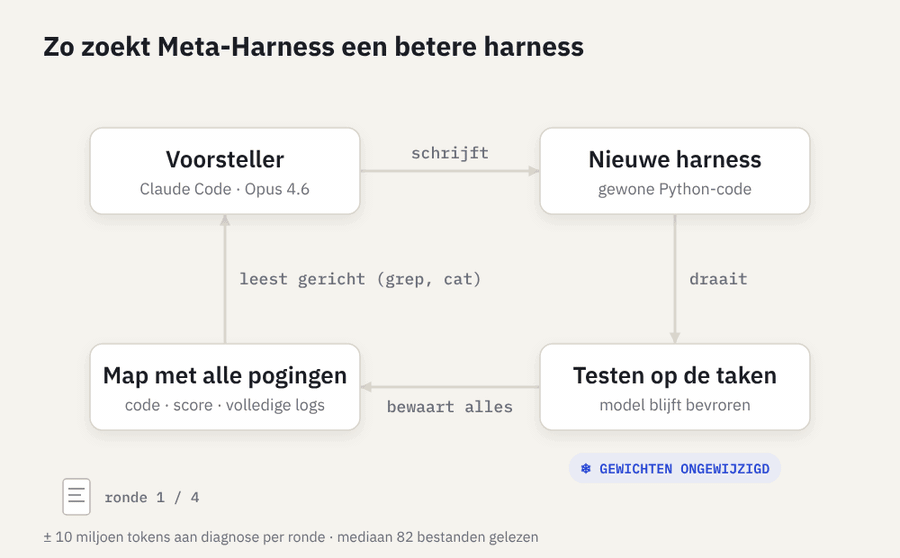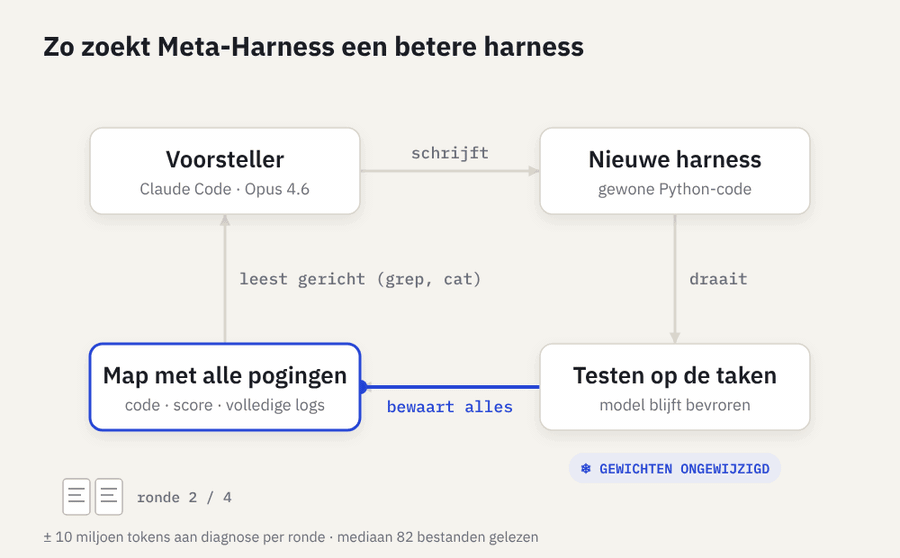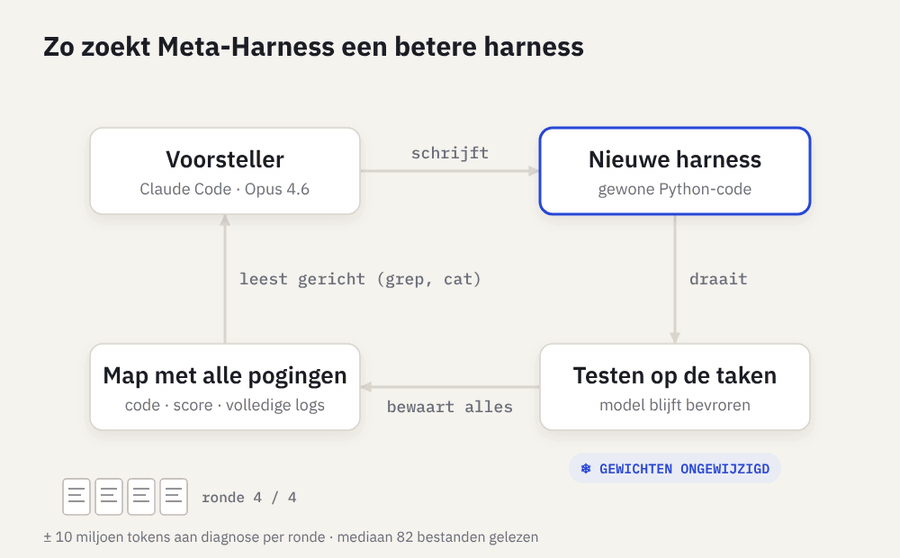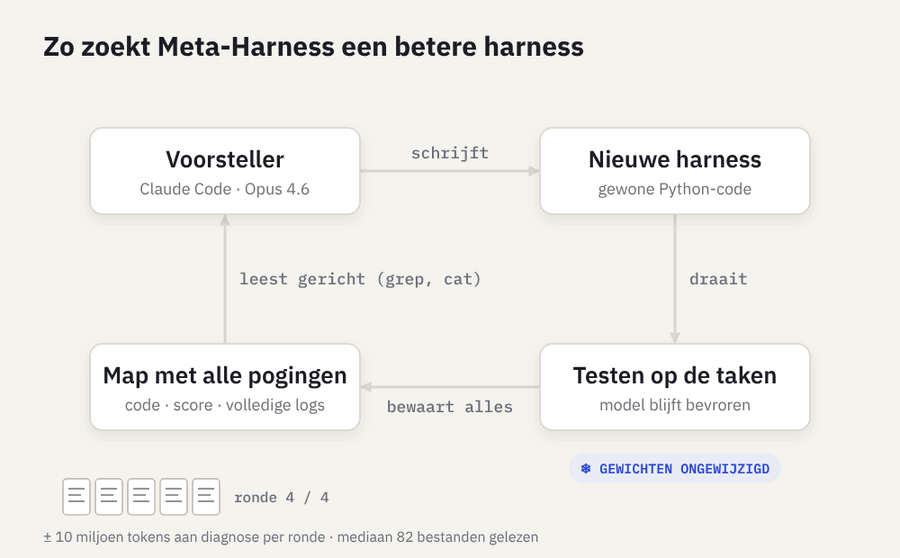
Het verschil met eerdere methodes zit in die map. Een agent als Claude Code kan er met grep en cat gericht in zoeken, zoals een developer door logbestanden gaat. In de TerminalBench-2-runs las de voorsteller per ronde doorgaans zo’n 82 bestanden (de mediaan): ongeveer 41 procent broncode, 40 procent logs en maar 6 procent scores. Hij keek telkens naar meer dan twintig eerdere kandidaten.
Waarom de ruwe logboeken het verschil maken
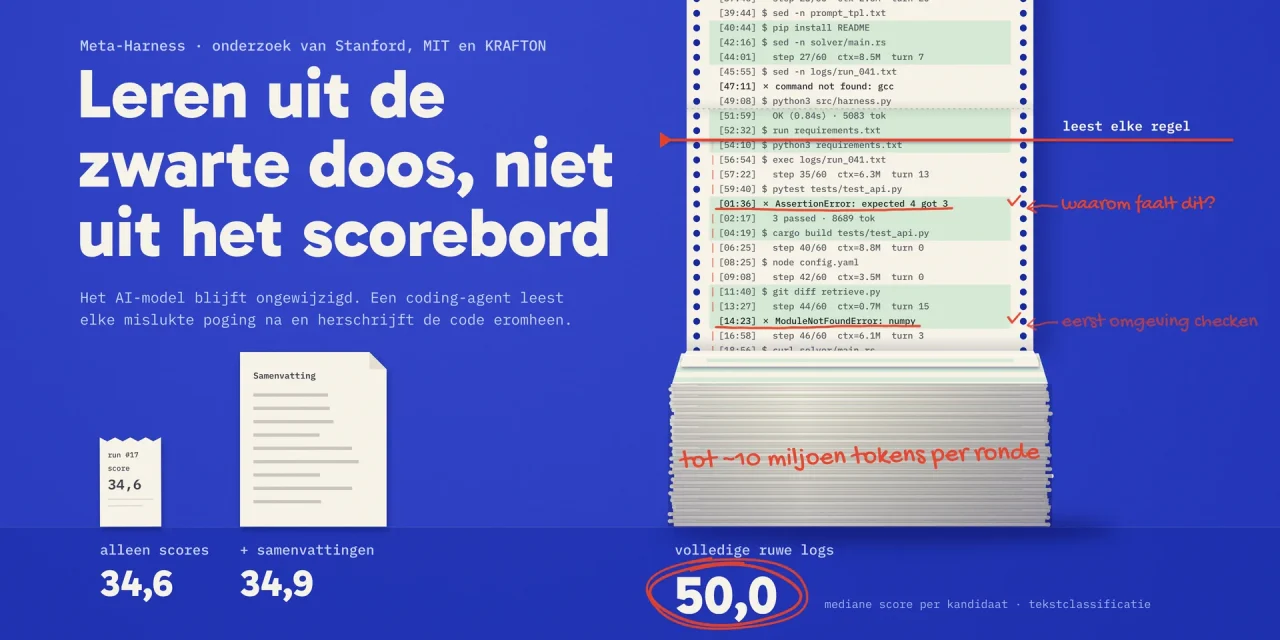
Eerdere technieken om prompts of code automatisch te verbeteren, zoals OPRO, GEPA, TextGrad of AlphaEvolve, geven het model een sterk ingedikte geschiedenis: de laatste poging, een paar scores of een samenvatting. Volgens de schatting van de auteurs is dat 2.000 tot 26.000 tokens per ronde. Meta-Harness laat tot ongeveer 10 miljoen tokens aan diagnose toe, honderden keren meer.
Dat dit telt, toont de proef waarin de onderzoekers de voorsteller telkens minder lieten zien. Met alleen scores lag de mediaan van alle kandidaten op 34,6 procent. Met scores en een samenvatting door een taalmodel 34,9 procent, nauwelijks beter. Met toegang tot de ruwe logs sprong de mediaan naar 50,0 procent, en de beste kandidaat naar 56,7 procent.
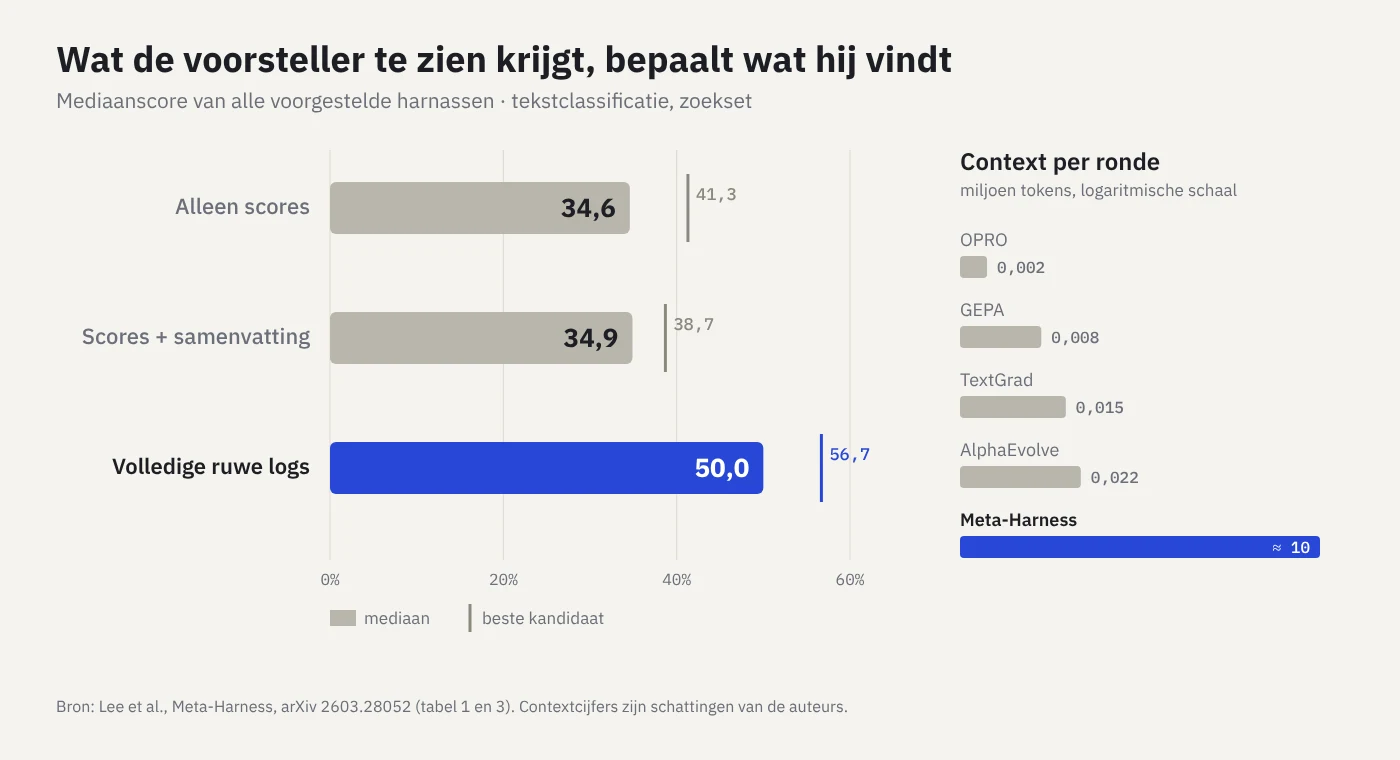
De verklaring is herkenbaar voor wie ooit een bug zocht. Een score zegt dat iets misging, een samenvatting zegt ongeveer wat. Pas in het logboek zie je bijvoorbeeld dat een agent drie beurten verloor aan uitzoeken welke Python-versie er stond, of dat een commando halverwege afbrak. Precies dat soort details stuurt een gerichte oplossing.
Wat de cijfers zeggen
De onderzoekers testten Meta-Harness in drie heel verschillende situaties.
| Taak | Model | Meta-Harness | Beste vergelijking |
|---|---|---|---|
| Tekstclassificatie, drie datasets | GPT-OSS-120B | 48,6% | 40,9% (ACE), met 4 keer meer context |
| Wiskunde op IMO-niveau, 200 problemen | gemiddelde van 5 niet-geziene modellen | 38,8% | 37,5% (BM25), 34,1% zonder retrieval |
| TerminalBench-2, 89 taken | Claude Opus 4.6 | 76,4% | 74,7% (Terminus-KIRA) |
| TerminalBench-2, 89 taken | Claude Haiku 4.5 | 37,6% | 35,5% (Goose) |
Drie dingen vallen op. Bij tekstclassificatie wint de gevonden harness het meest waar veel labels op elkaar lijken: zo’n 16 punten op juridische categorieën. Bij wiskunde werd de harness met één set modellen gezocht en hielp hij ook vijf modellen die nooit in de zoektocht zaten. En bij TerminalBench-2 klopte de automatisch gevonden harness de beste handgemaakte harnassen die als vertrekpunt dienden. Met Haiku 4.5 is hij de sterkste van alle gerapporteerde agents. De standaardversie van Claude Code haalde op dezelfde test 58,0 procent met Opus 4.6 en 27,5 procent met Haiku.
Wat Meta-Harness zelf bedacht
De gevonden harnassen zijn geen onleesbare reeksen tekens, maar code die een mens kan nalezen. Een paar voorbeelden uit de paper:
- Eerst rondkijken. Voor de eerste modelaanroep voert de TerminalBench-harness één shellcommando uit dat de werkmap, de geïnstalleerde talen en pakketbeheerders en het vrije geheugen in kaart brengt. Dat zijn ongeveer 80 regels code. De agent bespaart er twee tot vier verkenningsbeurten mee en wint 7 van de 89 taken, vooral taken waarvoor speciale software nodig is.
- Labels vooraf tonen. Bij tekstclassificatie zet de beste harness eerst de lijst van mogelijke labels in de prompt, met per label voorbeelden en paren die op elkaar lijken maar verschillen. Hij heeft geen extra modelaanroepen nodig.
- Een router per soort vraag. Bij wiskunde verdeelt de harness problemen over vier routes: combinatoriek, meetkunde, getaltheorie en de rest, elk met een eigen manier om voorbeelden te zoeken.
Mooi detail: na zes mislukte pogingen die prompt en logica tegelijk aanpasten, stelde de voorsteller een puur toevoegende wijziging voor. Die won. In zijn notities schreef hij de eerdere mislukkingen toe aan een herschreven prompt die alles door elkaar haalde. Dat is precies wat een goede developer ook zou besluiten na het lezen van de logs.
Waar je de cijfers niet te snel moet lezen
De resultaten zijn sterk, maar ze komen van de auteurs zelf en hebben grenzen.
- Zelfde taken voor zoeken en testen. Bij TerminalBench-2 gebruikten de onderzoekers dezelfde 89 taken om de harness te zoeken en om hem te scoren. Ze controleerden met de hand en met zoekpatronen of er geen taakspecifieke antwoorden in de code sloegen, maar de harness is op maat van die benchmark.
- Niet de hoogste score. ForgeCode meldt 81,8 procent met Opus 4.6, meer dan Meta-Harness. De auteurs konden dat resultaat met de publieke code niet nabootsen. Op de ranglijst van Opus-agents staat Meta-Harness tweede.
- Eén voorsteller, drie domeinen. Alle experimenten gebruikten Claude Code met Opus 4.6 als voorsteller. Of een ander model even goed zoekt, is nog niet onderzocht.
- Geen prijskaartje. De paper noemt geen kost in dollar. Tien miljoen tokens context per ronde, tientallen kandidaten en vijf testruns per taak lopen snel op.
- Kleine verschillen. Op wiskunde is het verschil met de klassieke zoekmethode BM25 1,3 punt. De grote winst zit bij taken met veel verwarrende labels en bij agents.
Google bracht half oktober met Harness² een verwante aanpak uit, die per taak bijleert in plaats van één keer vooraf te zoeken. In die paper is Meta-Harness in drie van de vier vergelijkingen op WorkBuddy-Bench het sterkste alternatief. Het idee dat de harness een eigen knop is om aan te draaien, staat dus niet meer ter discussie. Hoe je dat het best automatiseert, wel.
Drie dingen die vandaag meta-harness heten
Zoek je op meta-harness, dan kom je bij minstens drie verschillende dingen uit. Ze hebben weinig met elkaar te maken.
- Meta-Harness van Stanford is het onderzoek uit dit artikel: een harness die betere harnassen zoekt. De code staat open onder de MIT-licentie.
- Een meta-harness als beheerlaag is een laag boven de agents die je al gebruikt. Omnigent van Databricks, sinds juni 2026 open source onder Apache 2.0 en nog in alfa, laat je Claude Code, Codex en andere agents via één interface aansturen, met kostenbudgetten, goedkeuringsregels en een sandbox. Automatisch optimaliseren staat daar pas op de planning. Vandaag gaat het om controle en samenwerken.
- Meta, het bedrijf achter Facebook, heeft met Muse Code sinds 5 augustus een eigen harness rond zijn model Muse Spark. Daarover lees je meer in onze post over Muse Wonder. Meta-onderzoekers publiceerden daarnaast HyperAgents, agents die ook hun eigen verbeterproces aanpassen. Dat ligt in dezelfde familie als Meta-Harness, maar het is een ander project.
Zelf proberen
De onderzoekers zetten de code op GitHub. Je vindt er het raamwerk, de twee voorbeelden uit de paper (tekstclassificatie en TerminalBench-2) en een apart archief met de gevonden TerminalBench-harness. Je hebt uv nodig en Claude Code als voorsteller. Een ander model kan, maar dan pas je de wrapper aan die elke interactie logt. De auteurs schrijven zelf dat ze de opgekuiste code alleen nakeken op of ze draait.
Voor een eigen toepassing laat je een coding assistant het bestand ONBOARDING.md lezen. Daaruit volgt een plan met wat je wil verbeteren en hoe je het meet. Dat meten is het echte werk. Zonder een goede testset met taken die je echt belangrijk vindt, optimaliseert Meta-Harness ijverig de verkeerde dingen. Houd ook een deel van je taken apart om op het einde te testen, iets wat de paper voor TerminalBench niet deed.
Reken op een stevige factuur aan tokens. Begin klein, met een paar iteraties op een beperkte set taken, en kijk wat de voorsteller in de logs vindt voor je de lus langer laat draaien.
Het logboek is meer waard dan de score
Ook zonder Meta-Harness te draaien, haal je er drie lessen uit voor je eigen agents. Bewaar de volledige logs van je agentruns, niet alleen of een taak lukte, want daar zit de informatie die verbeteringen stuurt. Pas je harness in kleine, toevoegende stappen aan in plaats van alles tegelijk te herschrijven. En schrijf de opdracht voor wie je harness verbetert, mens of agent, scherp uit: de auteurs merkten dat het bijsturen van die instructie meer opleverde dan meer rondes of meer kandidaten.
Het model kies je bij een leverancier, en dat wisselt elk kwartaal. De harness en de logs die hem beter maken, zijn van jou. Ook dat is een reden om je context in eigen handen te houden.
Veelgestelde vragen over Meta-Harness
Leert het AI-model zelf bij met Meta-Harness?
Nee. De gewichten van het model veranderen niet. Alleen de code eromheen wordt herschreven: prompts, tools, geheugen en de logica die bepaalt wat het model te zien krijgt.
Is Meta-Harness van Meta?
Nee. Meta-Harness komt van onderzoekers van Stanford, MIT en KRAFTON. Meta, het bedrijf, heeft eigen agentwerk zoals Muse Code en het onderzoek HyperAgents.
Wat is het verschil met Harness² van Google?
Meta-Harness zoekt vooraf, op een vaste set taken, naar één betere harness die je daarna hergebruikt. Harness² past de harness per taak aan tijdens het gebruik en bewaart lessen in een bibliotheek.
Werkt de gevonden harness ook met andere modellen?
Soms. De wiskunde-harness hielp vijf modellen die niet in de zoektocht zaten, met winsten tussen 1,6 en 8,7 punten. De TerminalBench-harness is gezocht en getest per model.
Wat kost een run van Meta-Harness?
De paper noemt geen bedrag. Een run duurt enkele uren, met tot ongeveer 10 miljoen tokens context per ronde voor de voorsteller, bovenop de kost van alle testruns.