Dessa is een spraakmodel van Block, het bedrijf van Jack Dorsey achter Square en Cash App, dat leerde praten door naar opgenomen gesprekken te luisteren. Het zag volgens Block nooit één geschreven woord en vertrekt niet van een bestaand taalmodel. Het luistert en praat tegelijk, zegt “yeah” terwijl jij nog bezig bent en lacht midden in een zin. Je kan het nog niet gebruiken: Block geeft alleen een kleine groep veiligheidsonderzoekers toegang, en harde cijfers over hoe goed het is, ontbreken nog.
Wat Block aankondigde
Block stelde Dessa op 23 oktober 2026 voor als research preview, een onderzoeksresultaat en geen product. Op de projectpagina noemt het team Dessa “the most authentic full-duplex speech model ever built”. Het lab achter het model is klein: zes onderzoekers en een handvol stagiairs onder leiding van Ragavan Thurairatnam, en ze rapporteren rechtstreeks aan Dorsey. Thurairatnam noemde het op X “a GPT3 moment for speech”.
Dit zijn de belangrijkste claims van Block:
- Alleen spraak. Dessa is van nul getraind op menselijke gesprekken, zonder tekst en zonder voorgetraind model. Er gaat audio in en er komt audio uit.
- Full-duplex. Het model luistert terwijl het spreekt, en leerde zelf wanneer het onderbreekt en wanneer het alleen kort bevestigt.
- Emotie. Dessa hoort en maakt sarcasme, lachen, zuchten en een stem die breekt.
- Zuinig. Het leerde taal uit honderden keren minder woorden dan een groot taalmodel, en de training liep op één NVIDIA GB200 NVL72, één serverrack.
- Lokaal. Het antwoordt sneller dan realtime, en het draait lokaal op een MacBook Pro met M4 Max of beter.
Waarom praten zonder tekst ertoe doet
De meeste spraakassistenten werken met een ketting van modellen. Een spraakherkenner maakt van je stem tekst, een taalmodel schrijft een antwoord en een stemmodel leest dat voor. Dat is betrouwbaar, want tussen de stappen staat tekst die je kan lezen, loggen en controleren. Maar alles wat niet in letters past, valt weg: een zucht, een aarzeling, de toon waarmee je “prima” zegt. ElevenLabs, dat zelf zo’n cascade verkoopt, gaf dat in maart 2026 toe: modellen die spraak rechtstreeks verwerken, bewaren intonatie en emotie beter.
Er bestond al een tussenvorm. Moshi van het Parijse lab Kyutai verwerkt audio rechtstreeks, maar voorspelt ook tekst als een soort innerlijke monoloog en bouwt op een tekstmodel van 7 miljard parameters. Het open model PersonaPlex van NVIDIA bouwt daarop voort. Dessa gaat een stap verder en laat de tekst helemaal weg. Block vergelijkt het met een baby: “Babies learn to talk without ever seeing a word written down. We wanted to see if a model could too.”
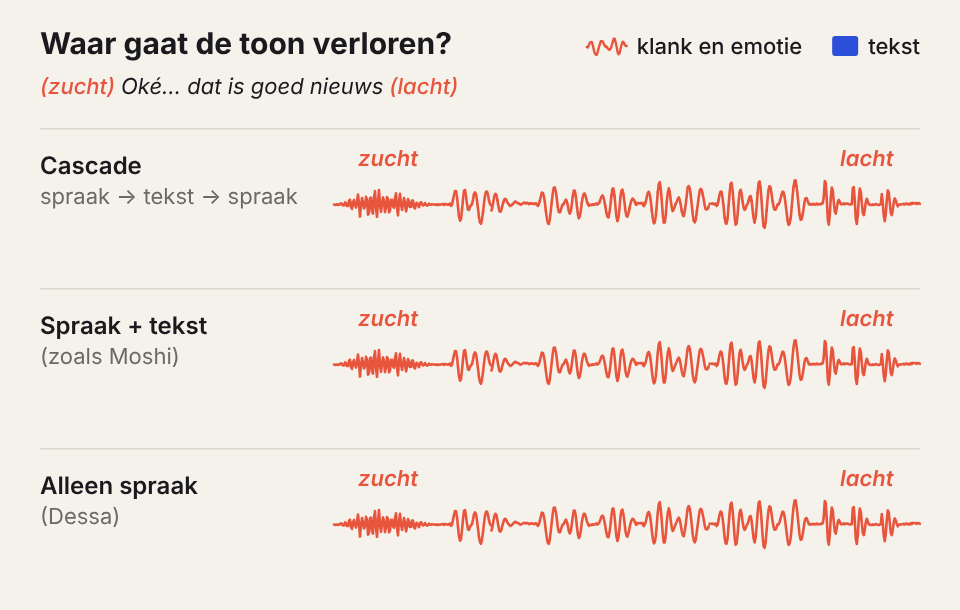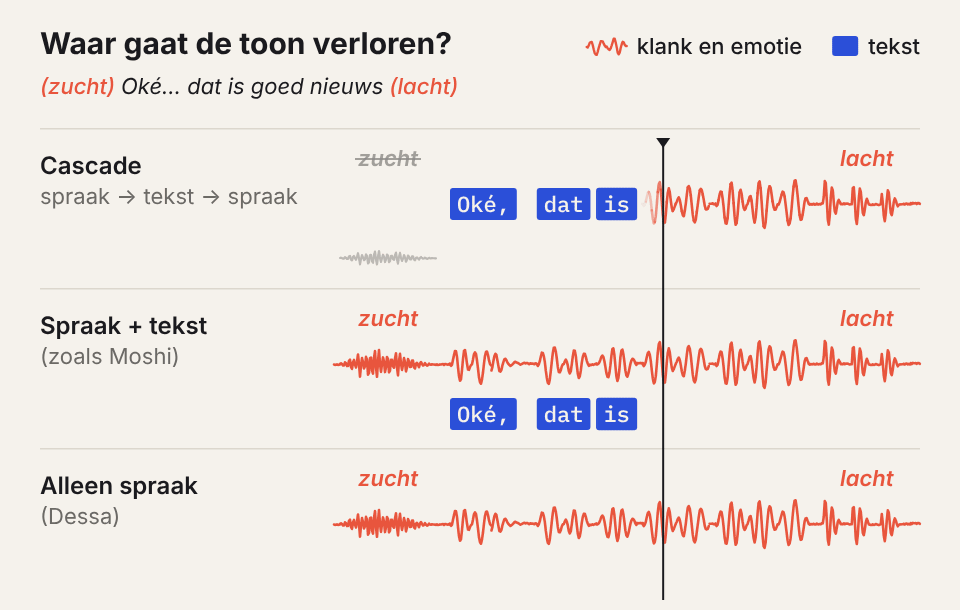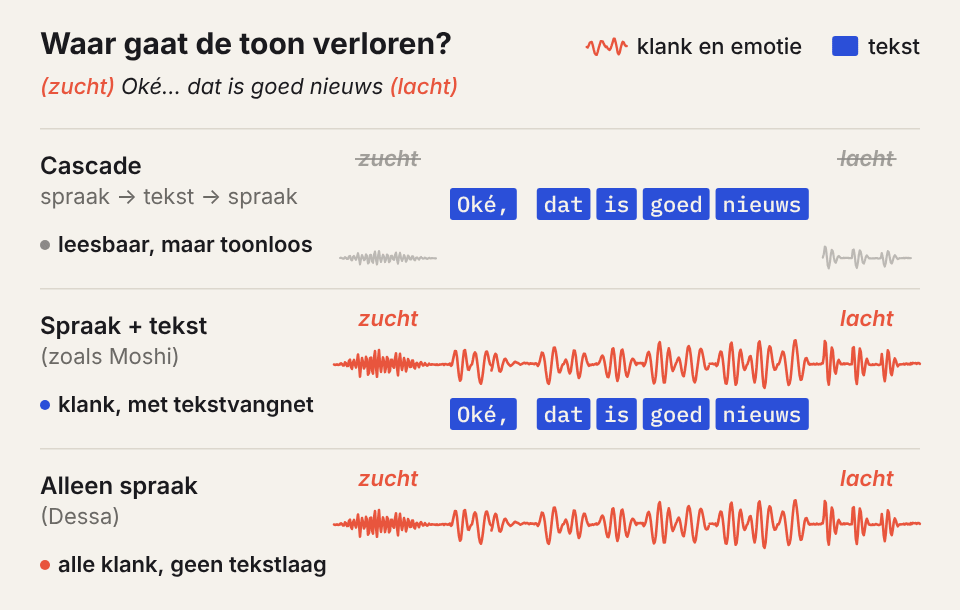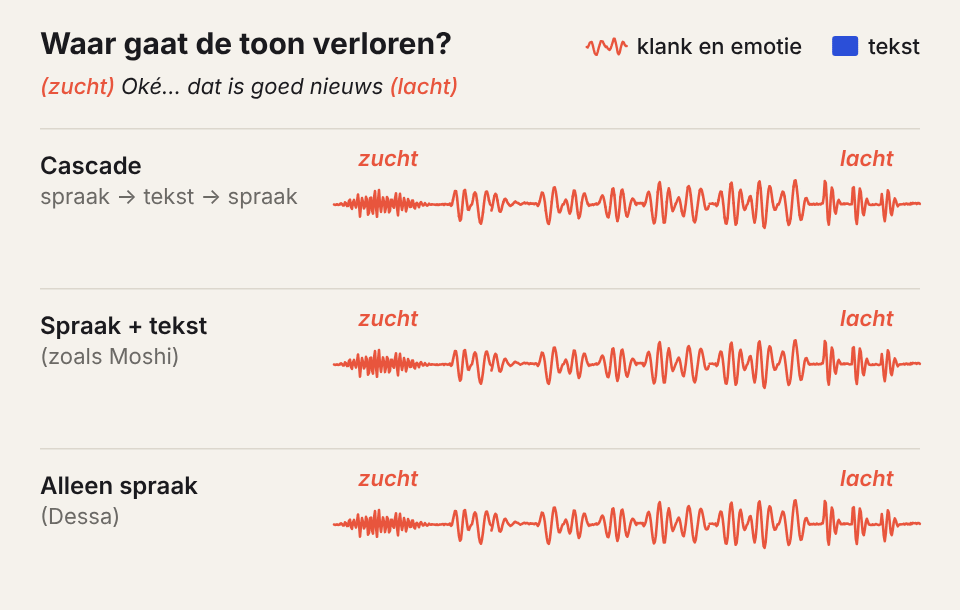
Dat is ook een gok. Een gesproken woord kost volgens Block duizenden keren meer bytes dan hetzelfde woord getypt, en geen zin wordt twee keer op dezelfde manier uitgesproken. Leren uit klank is dus veel duurder dan leren uit tekst. Dat het toch lukte met minder woorden en één rack, is de opvallendste claim van de aankondiging. Hoeveel uur audio er precies in ging, zegt Block niet.
Wat full-duplex aan een gesprek verandert
Een klassieke voice assistent werkt als een walkietalkie. Jij praat, hij wacht op stilte, en pas dan antwoordt hij. Een full-duplex model luistert en spreekt tegelijk. Het kan “mm-hm” zeggen terwijl jij uitlegt, meelachen, en stoppen zodra jij het onderbreekt. Zo praten mensen ook.
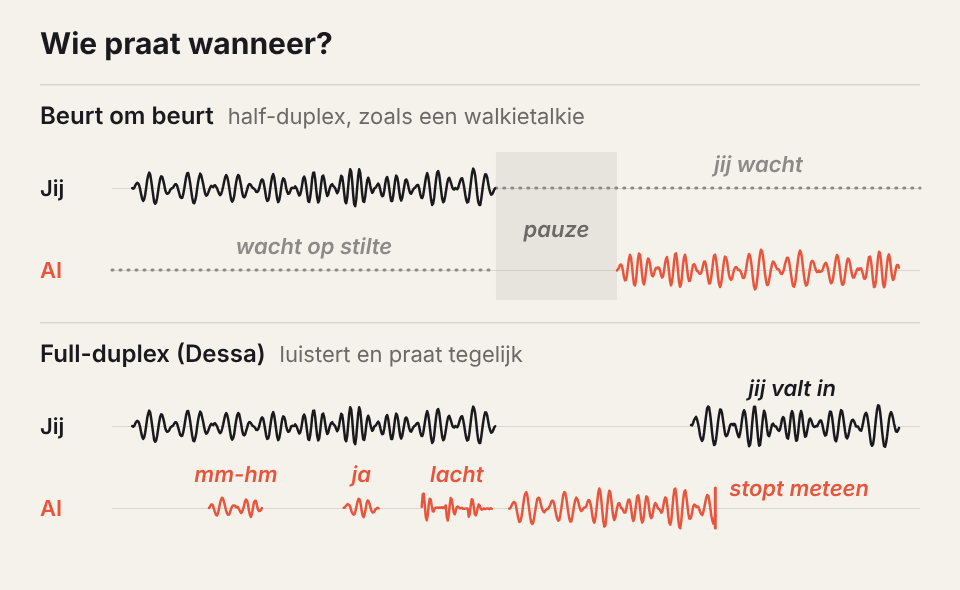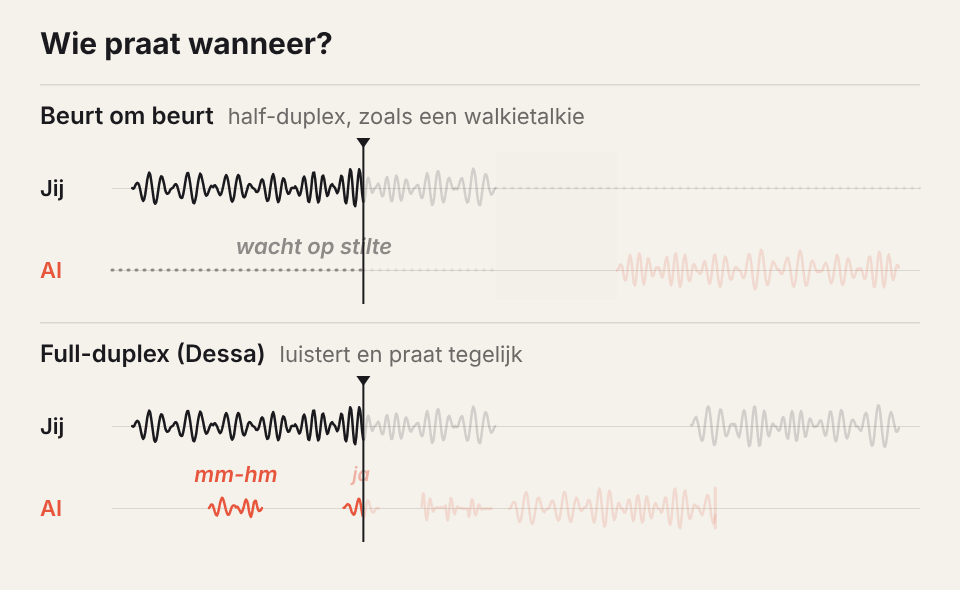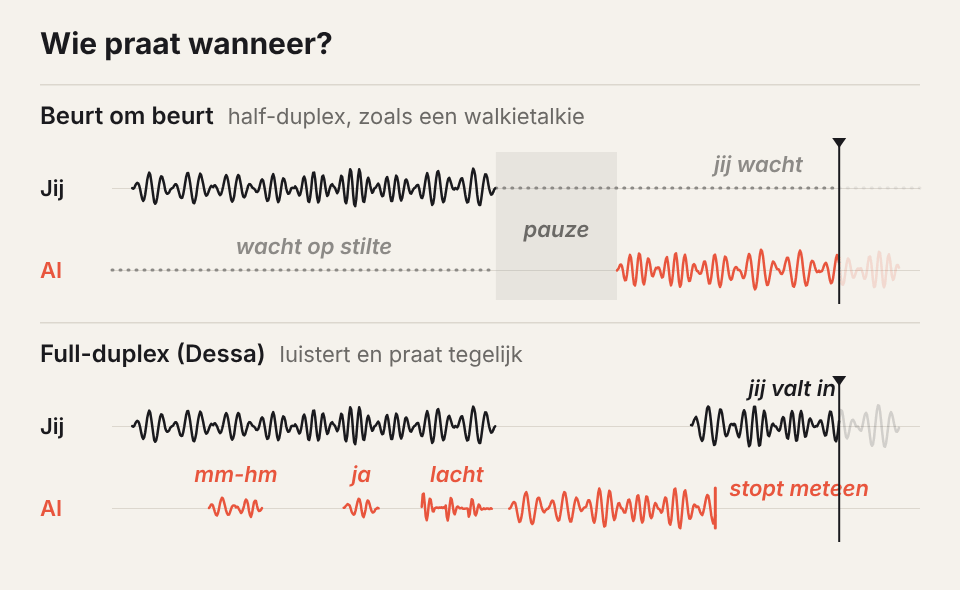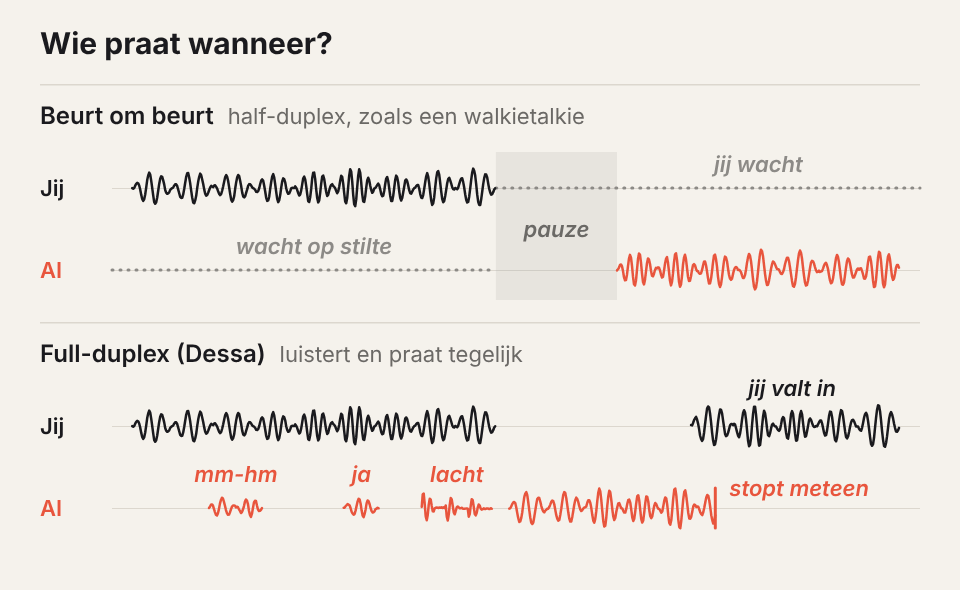
Dessa is niet het eerste full-duplex model. OpenAI bracht in juli 2026 GPT-Live naar ChatGPT, dat ook tegelijk luistert en praat en moeilijke vragen doorgeeft aan een ander model, bij de lancering GPT-5.5, terwijl het gesprek doorloopt. Het verschil zit in de bouw: Dessa leerde alles uit klank, en bevat volgens Block geen tekstlaag waarop het kan terugvallen.
Wat de demo’s tonen, en wat niet
Block zette zes live opnames in de kijker, plus een vijftiental extra fragmenten, allemaal zonder dat iemand het model stuurde. Dessa lacht om een grap, praat luider als je dat vraagt, vult de titel van een film aan die de spreker vergeten is, en reageert met een snik van ontroering op een verrassing voor een huwelijksverjaardag. In één opname praat Dessa met GPT-Live-1 van OpenAI. Block meldt daarbij dat die ontwikkelaar los staat van Block en Dessa niet beoordeeld of goedgekeurd heeft.
The Verge luisterde en vond de gesprekken grotendeels natuurlijk, maar soms ongemakkelijk en een beetje griezelig. Dessa spreekt iemand aan als “Ronaldo”, en een gesprek over de films van Christopher Nolan schiet plots naar de Superman-films van Bryan Singer. Ook Crypto Briefing zag een verkeerd herkende spreker en abrupte wissels van onderwerp.
Belangrijker is wat ontbreekt. Er is geen paper, geen modelgrootte, geen aantal uren training, geen reactietijd in milliseconden en geen enkele benchmark. OrcaRouter vat het samen als “research result with an unusually good demo page”. Dat weegt, want andere spraakmodellen laten zich wel meten. Op de onafhankelijke ranglijst van Artificial Analysis staan Grok Voice 3.0, GPT-Live-1 en Eleven Realtime van ElevenLabs naast elkaar, met reactietijd, redeneren, afgeronde taken en beurtwissel. Dessa staat er niet op. Zelfgekozen opnames tonen dat een goed gesprek mogelijk is, niet hoe vaak het lukt.
Van nep-Joe Rogan tot veiligheidslab
De naam Dessa is niet nieuw. Het team komt uit Dessa, een deep-learningbedrijf uit Toronto dat Thurairatnam mee oprichtte. In mei 2019 haalde het wereldwijd het nieuws met RealTalk, een nagemaakte stem van podcaster Joe Rogan die zo echt klonk dat het bedrijf het model en de data bewust niet vrijgaf. Het waarschuwde toen al dat binnen enkele jaren een paar seconden audio zou volstaan om iemands stem na te maken. Daarna werkte Dessa aan het opsporen van deepfakes, en in februari 2020 nam Square het team over. Het moederbedrijf Square, Inc. heet sinds december 2021 Block.
Die voorgeschiedenis verklaart de voorzichtige lancering. Block noemt veiligheid een van zijn drie redenen voor het project, naast nieuwsgierigheid en beter begrip tussen mens en AI. Het team schrijft dat AI steeds machtiger wordt “and it’s still nearly deaf to the emotion in our voices”. Een model dat hoort dat iemand in nood is, kan daar beter op reageren. Hetzelfde vermogen maakt een overtuigende, emotionele stem ook bruikbaar voor oplichting. Block geeft daarom eerst onderzoekers toegang, met de vraag om risico’s te vinden die het team zelf niet zag.
Dessa komt ook op een opvallend moment voor Block. In februari 2026 schrapte Dorsey meer dan 4.000 jobs, bijna de helft van het personeel, met AI als hoofdreden. Een eigen onderzoekslab dat een fundamenteel model bouwt, past in die koers.
Wat Dessa voor jou betekent
Op korte termijn weinig. Er is een wachtlijst, maar geen releasedatum, geen prijs, geen API en geen licentie. De links voor de lancering staan op “coming soon”. Toch zijn er drie dingen om in het oog te houden.
- Lokaal draaien. Als Dessa echt op een laptop draait, hoeft je stem niet naar een server. Voor gesprekken over gezondheid, geld of werk is dat een groot verschil met cloudassistenten. Hoeveel geheugen het precies vraagt, weet niemand nog.
- Nederlands is onzeker. Voor zover te horen zijn de demo’s Engels. Block noemt het leren van nieuwe talen zelf een open onderzoeksvraag. Een model dat alleen uit opgenomen gesprekken leert, heeft voor het Nederlands en zeker voor Vlaams veel minder materiaal. Hoe groot dat verschil kan zijn, zagen we al bij Voxtral 3 van Mistral.
- Een stem die je niet herkent als AI. In Europa geldt sinds 2 augustus 2026 artikel 50 van de AI Act: wie met een AI-systeem praat, moet dat weten, tenzij het overduidelijk is. Hoe menselijker het model klinkt, hoe belangrijker die melding wordt.
Veelgestelde vragen over Block Dessa
Kan ik Block Dessa al uitproberen?
Nee. Alleen een kleine groep AI-veiligheidsonderzoekers met een e-mailadres van een universiteit, bedrijf of lab krijgt vroege toegang. Iedereen kan zich op de wachtlijst zetten op block.xyz/dessa.
Spreekt Dessa Nederlands?
Dat is niet bekend. De gepubliceerde gesprekken zijn voor zover bekend Engels, en Block noemt nieuwe talen leren een open onderzoeksvraag.
Is Dessa open source?
Nee, voorlopig niet. Block publiceerde geen gewichten, geen code en geen licentie. Wie een open full-duplex model zoekt, kan kijken naar Moshi van Kyutai of PersonaPlex van NVIDIA.
Wat is het verschil tussen Dessa en GPT-Live van OpenAI?
Beide luisteren en praten tegelijk. GPT-Live zit in ChatGPT, is voor iedereen beschikbaar en kan moeilijke vragen doorgeven aan een krachtiger achtergrondmodel, bij de lancering GPT-5.5. Dessa is een onderzoeksmodel dat volgens Block alleen uit spraak leerde en lokaal draait, maar nog niet te gebruiken is.
Wie nooit leest, kan ook niets opzoeken
Dessa’s sterkte is ook zijn grens. Zonder tekstlaag hoort het model elke zucht, maar heeft het geen ingang voor documenten, tabellen of tools, en kan niemand achteraf nalezen wat het “dacht”. OpenAI lost dat bij GPT-Live op door de stem te laten doorgeven aan een krachtiger achtergrondmodel dat kan zoeken en redeneren. Block heeft nog niet getoond hoe Dessa samenwerkt met een systeem dat wel kan lezen. Pas als dat lukt, wordt een stem die alles hoort ook een assistent die iets gedaan krijgt.