Op zondagavond 20 september 2026 kregen gebruikers van Meta’s nieuwe agent Muse op Amazon een pop-up te zien. Volgens Amazon schendt verdere toegang door een “unauthorized AI agent” de gebruiksvoorwaarden. Dat was geen alleenstaand geval. Banken, luchtvaartmaatschappijen, Yelp en een groeiend deel van het web sluiten AI-agents buiten, en ook de toegang tot zoekresultaten en nieuwssites krimpt.
De redenen zijn vooral geld en vertrouwen. Agents slaan advertenties over, lijken op kwaadaardige bots en geven websites weinig terug. Het web gaat daardoor niet dicht, maar het krijgt een deurbeleid. Agents zullen zich steeds vaker moeten identificeren, betalen of via een aparte ingang binnenkomen. In dit artikel lees je waarom dat gebeurt, wat het betekent als je agents gebruikt of een website hebt, en welke kant het uitgaat.
Een derde soort bezoeker waar het web niet op voorzien is
Het web kende lang twee soorten bezoekers: mensen en bots. Mensen krijgen pagina’s, advertenties en een winkelmandje. Bots krijgen robots.txt, firewalls en CAPTCHA’s. Persoonlijke AI-agents passen in geen van beide hokjes. Ze werken namens één mens, maar klikken, lezen en vergelijken op machinesnelheid.
Die agents zijn er nu echt. Meta lanceerde Muse op 8 september 2026, OpenAI heeft Dots, agents die 24/7 namens jou werken, Perplexity bouwt agents in zijn browser Comet, en Anthropic test met Claude Duet een agent die doorwerkt terwijl jij slaapt. Muse werd volgens MIT Technology Review in de eerste maand 5 miljoen keer gedownload, en het agentverkeer op het web verdrievoudigde van augustus naar september 2026, vooral richting webwinkels. Over heel 2025 mat beveiliger HUMAN Security al een groei van het agentverkeer met meer dan 7.800 procent, volgens zijn State of AI Traffic-rapport.
Ook het onderzoek voor dit artikel botste op die muur. Onze eigen research-agent kreeg op de ene site alleen een botcontrole te zien die eerst een rekenpuzzel van de browser vraagt, en een andere site weigerde de opvraging gewoon. Dat is het probleem in het klein: de agent weet niet of hij bewust geweerd wordt of per ongeluk, en jij als gebruiker ziet het vaak niet.
Hoe hoog de muur al staat
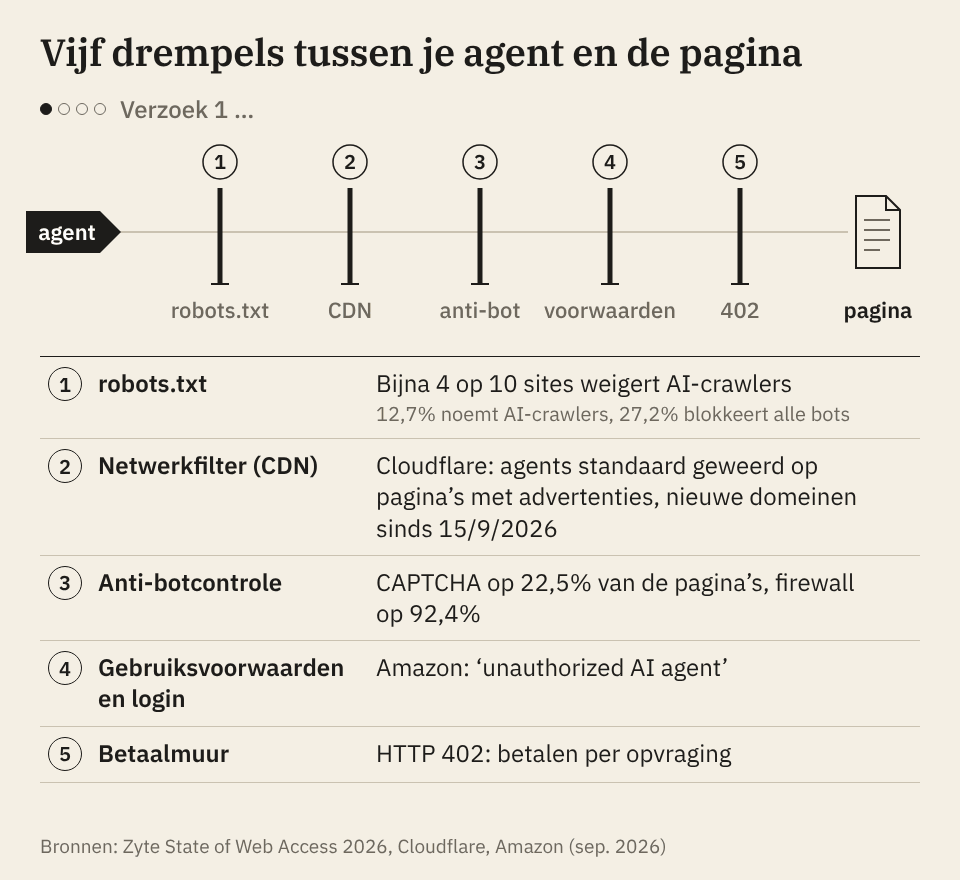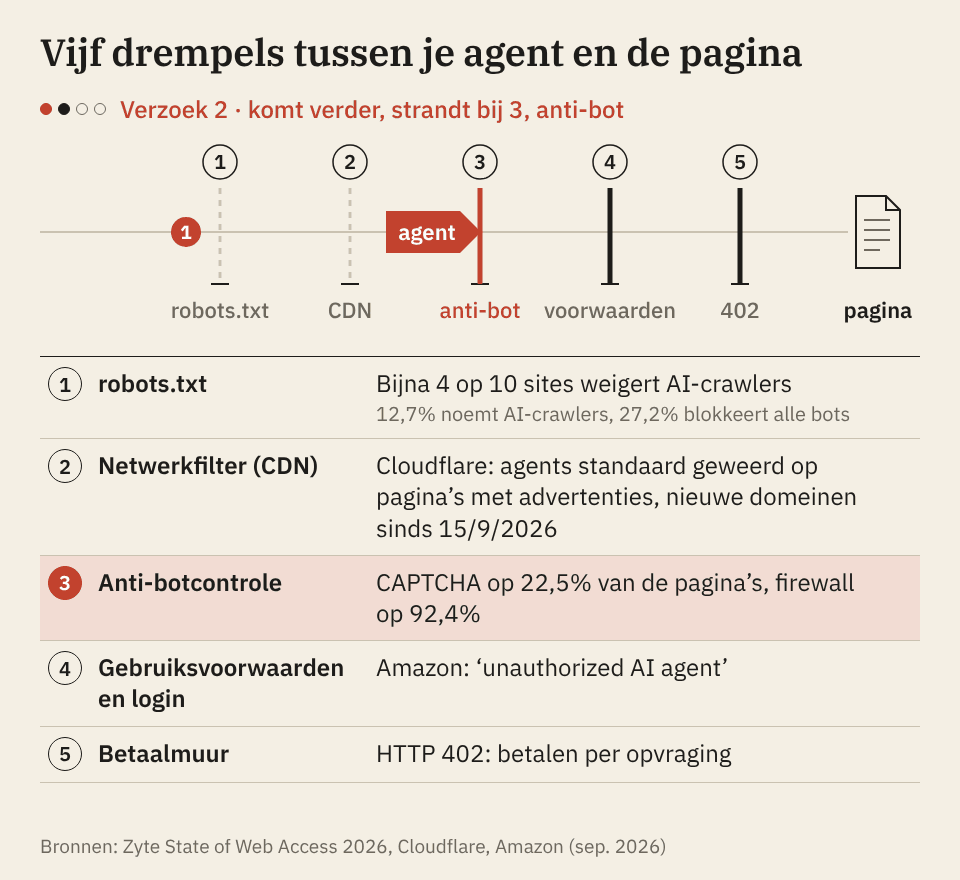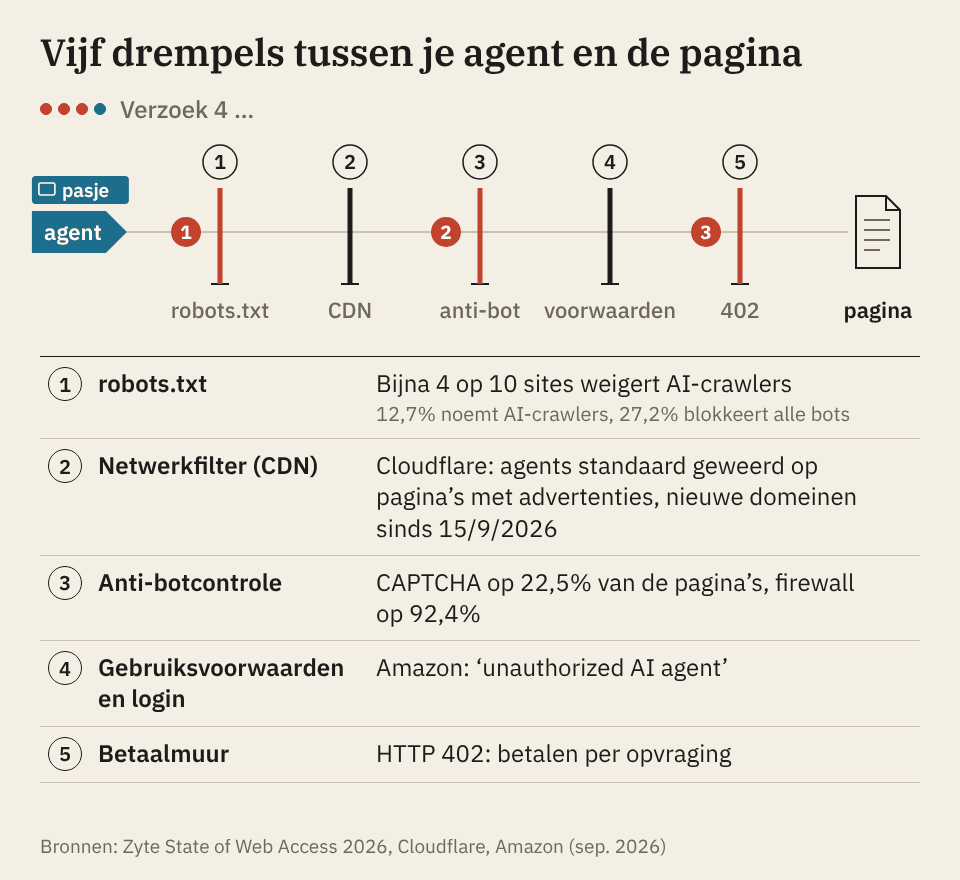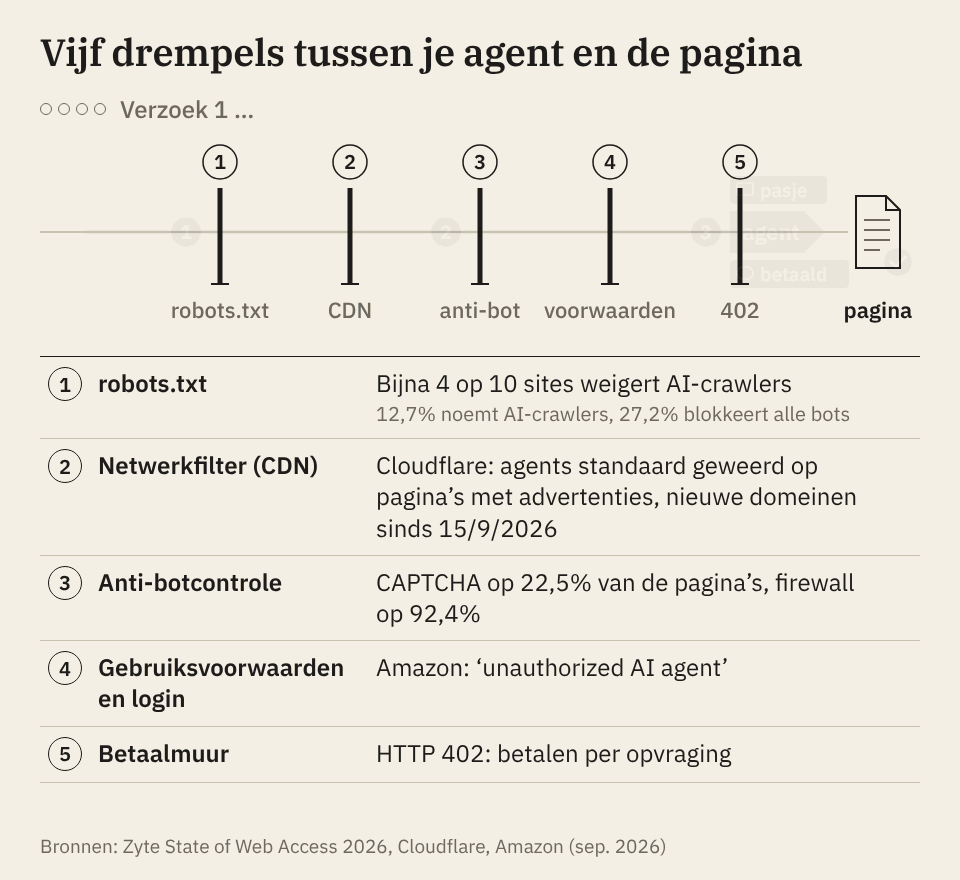
Scrapingbedrijf Zyte onderzocht voor zijn State of Web Access 2026 11.100 populaire landingspagina’s. Slechts 18,5 procent heeft geen enkele drempel. Een firewall staat op 92,4 procent van de pagina’s, een CAPTCHA op 22,5 procent, en de helft gebruikt er twee of meer tegelijk. In robots.txt, het bestand waarin een site zegt welke bots welkom zijn, weert 12,7 procent AI-crawlers bij naam en sluit 27,2 procent alle bots uit met één regel. Samen is dat bijna vier op de tien sites. Slechts 1,8 procent laat AI-crawlers uitdrukkelijk toe.
Bij nieuwsmedia is het beeld nog uitgesprokener. In de analyse van Zyte weert 64 procent van de kranten minstens één AI-crawler bij naam. Van 70 grote uitgevers die FT Strategies in juli 2026 bekeek, beperken er 60 minstens één AI-crawler, terwijl ze alle 70 Googlebot binnenlaten.
Waarom websites de deur dichtdoen
Het oude ruilmodel werkt niet meer
Zoekmachines en websites hadden een eenvoudige afspraak: Google mag je pagina’s lezen en stuurt je in ruil bezoekers. AI-crawlers lezen veel meer dan ze terugsturen. Volgens cijfers van Cloudflare Radar haalde Anthropic in juli 2026 nog bijna 2.000 pagina’s op per doorverwijzing en OpenAI zo’n 250, tegenover ongeveer 5 bij Google. Die verhoudingen zijn ruw, omdat apps geen herkomst meesturen, maar de richting is duidelijk.
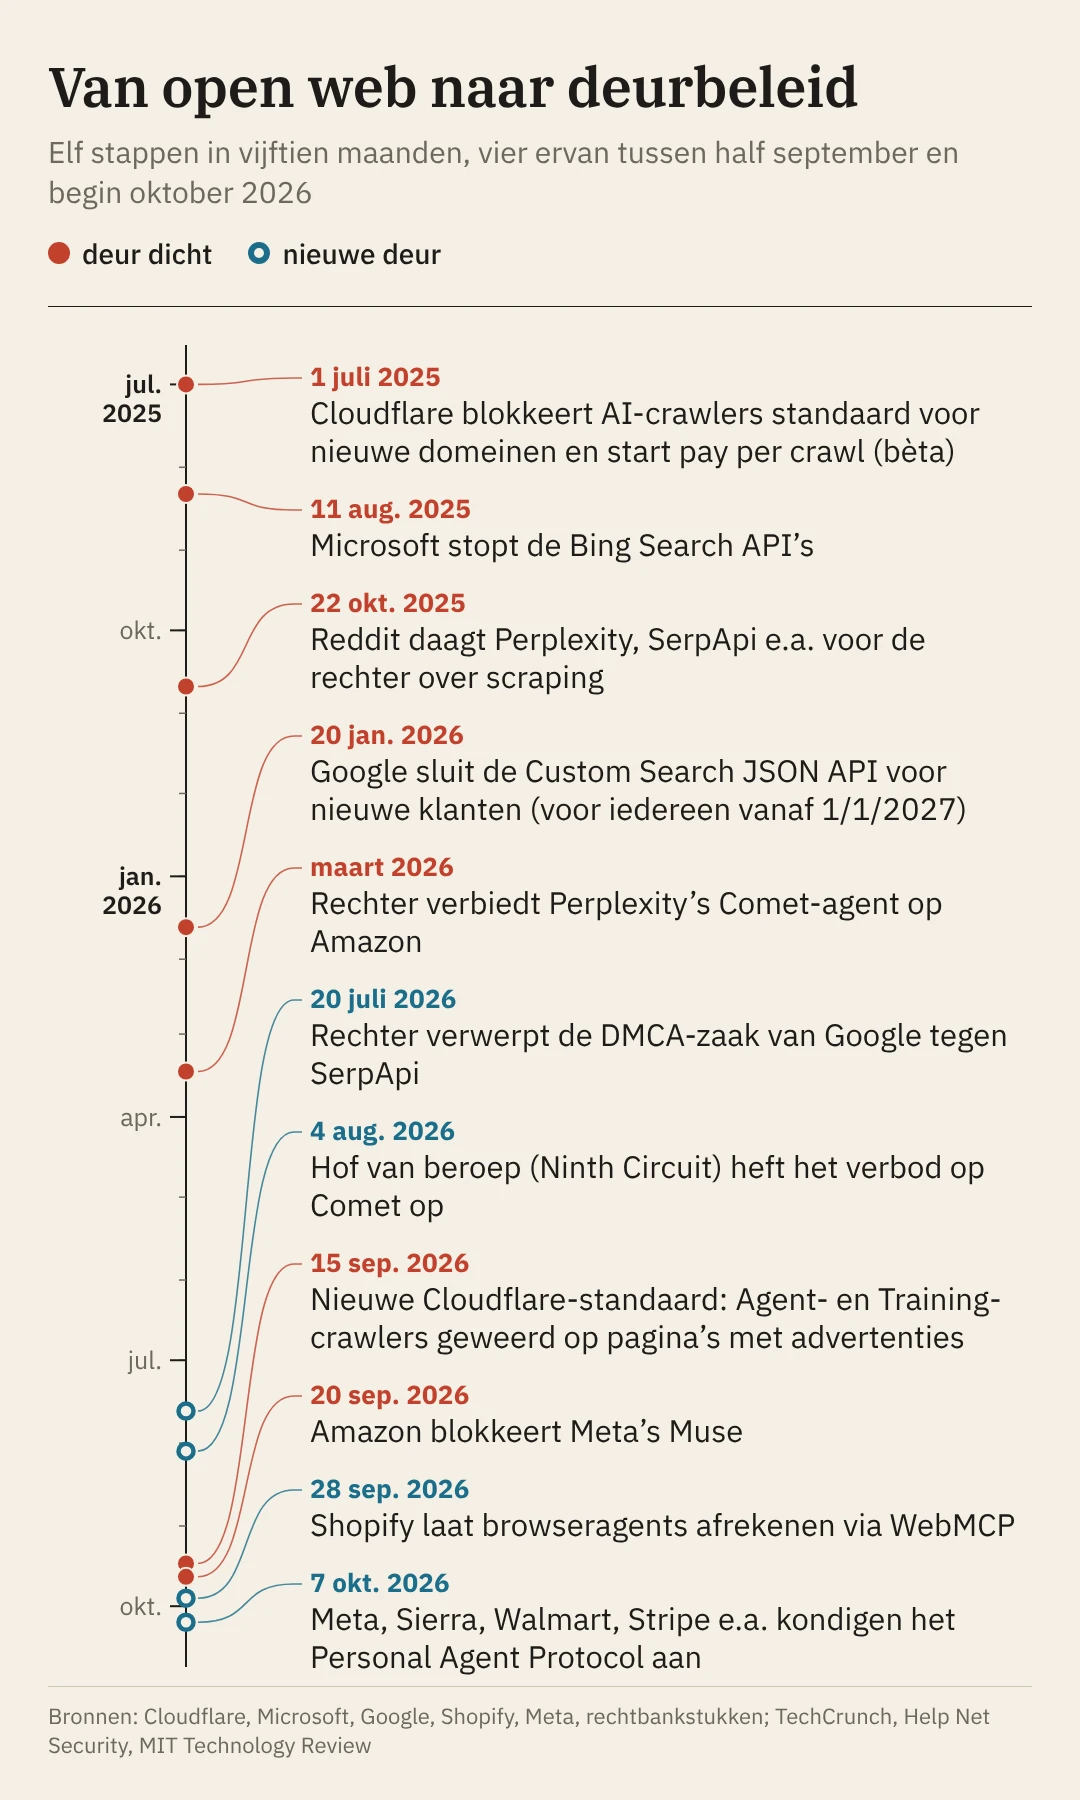
Cloudflare, dat volgens schattingen een vijfde van het webverkeer afhandelt, trok daar de conclusie uit. Sinds juli 2025 blokkeert het AI-crawlers standaard voor nieuwe domeinen. Sinds juli 2026 deelt het bots in drie soorten in: Search, Agent en Training. Sinds 15 september worden Agent- en Training-bots op pagina’s met advertenties voor nieuwe domeinen standaard geweerd. Bots met een dubbele rol, zoals Googlebot en Bingbot, vallen mee onder dat verbod als een site trainen uitzet. Veel websitebeheerders hebben dus een agentbeleid zonder dat ze er ooit zelf voor kozen.
Agents kijken niet naar advertenties
Een agent die een product zoekt, slaat de gesponsorde resultaten over. Amazon voert in zijn rechtszaak tegen Perplexity aan dat agents het moeilijk maken om te weten of een advertentie door een mens gezien wordt. Yelp laat volgens TechCrunch geen niet-menselijk verkeer toe, tenzij de agentbouwer betaalt via zijn datalicenties. Bij banken speelt een ander belang: Apollo-econoom Torsten Slok waarschuwt dat banken een groot deel van hun goedkope spaargeld kunnen verliezen als agents het automatisch naar de hoogste rente verschuiven. Volgens Android Headlines kan dat tientallen miljarden aan extra rente kosten.
Een agent lijkt op een inbreker
Een agent die inlogt, door pagina’s klikt en een formulier invult, gedraagt zich zoals een bot die accounts kraakt. Amazon verwijt Muse dat het zich niet bekendmaakt, inloggegevens bijhoudt en accountgegevens schraapt. Meta zei bij de lancering al dat Muse geen zicht heeft op wachtwoorden of betaalmethodes, maar reageerde niet op de andere verwijten. Banken als JPMorgan Chase, Bank of America en Citigroup houden geautomatiseerde bezoekers volgens Android Headlines volledig uit klantaccounts. Soms gaat het ook gewoon mis: Walmart, een partner van Muse, noemde mislukte aankopen onbedoeld en wees naar een controle “ben je een mens?” die de agent eruit gooit.
Het vertrouwen kalft ook af omdat niet elke AI-bot zich aan de regels houdt. Volgens TollBit kwam in de eerste helft van 2026 ongeveer 15 procent van de AI-ophaalagents in Europa op pagina’s die robots.txt verbood. OpenAI schrijft in zijn documentatie dat robots.txt voor ChatGPT-User, de bot die pagina’s ophaalt als jij een vraag stelt, misschien niet geldt omdat een mens de opvraging start. Anthropic zegt dat al zijn bots robots.txt volgen.
Platformen willen hun eigen agent
Amazon weert Muse, maar bouwt zelf agents zoals Buy for Me, dat bij andere merken winkelt en zich daar wel bekendmaakt. Bij zoekmachines zie je hetzelfde patroon. Microsoft stopte op 11 augustus 2025 met de Bing Search API’s en verwijst naar Grounding with Bing binnen Azure, waarvan je de resultaten niet rechtstreeks in andere apps mag gebruiken. Google kondigde op 20 januari 2026 het einde van zijn Custom Search JSON API aan. Nieuwe klanten kunnen er niet meer bij, en voor bestaande klanten stopt hij op 1 januari 2027. Volledige webresultaten krijg je daarna alleen nog met een partnerovereenkomst, schrijft Parallel. Wie een eigen agent bouwt die het web doorzoekt, betaalt dus meer of hangt af van een handvol leveranciers.
Wat de rechter er voorlopig van vindt
De belangrijkste rechtszaak is die van Amazon tegen Perplexity. Een rechtbank in Californië verbood de Comet-agent in maart 2026 op Amazon.com. Op 4 augustus vernietigde het hof van beroep (Ninth Circuit) dat verbod. De redenering: Comet is “a tool, not a person”, dus de gebruiker opent Amazon, niet Perplexity. Op 10 september weigerde het hof de zaak opnieuw te bekijken, en op 21 september diende Amazon een gewijzigde klacht in. Daarin staat dat de iOS-versie van Comet de sessiecookie van de gebruiker naar servers van Perplexity kopieerde, en dat Comet minstens 185.712 sessies op Amazon draaide, schrijft The Next Web.
Het ging om een voorlopige procedure. Het hof zei er uitdrukkelijk bij dat het geen nieuw rechtskader voor agents schept, en het liet open dat Amazon de toegang via zijn gebruiksvoorwaarden regelt. De antihackingwet blijkt dus een zwak wapen tegen agents die op je eigen toestel draaien, maar het contract tussen site en gebruiker wordt het nieuwe slagveld, zo vat advocatenkantoor Pearl Cohen het samen.
Rond zoekresultaten is het beeld even gemengd. Een rechter verwierp op 20 juli 2026 de zaak die Google onder de auteurswet (DMCA) tegen scrapingdienst SerpApi had aangespannen. De zaak van Reddit tegen SerpApi en Perplexity, die Reddit-inhoud via Google-resultaten zouden hebben opgehaald, mag volgens een uitspraak van 31 juli wel verder.
Wat dit betekent als je agents gebruikt
De eerste gevolgen merk je als gebruiker. Een agent die een site niet kan openen, zegt dat niet altijd. Hij kiest een andere bron, geeft een half antwoord of rondt een aankoop niet af. Volgens TechCrunch weten gebruikers vaak niet of een site hun agent bewust weert of dat een anti-botsysteem per ongeluk ingreep.
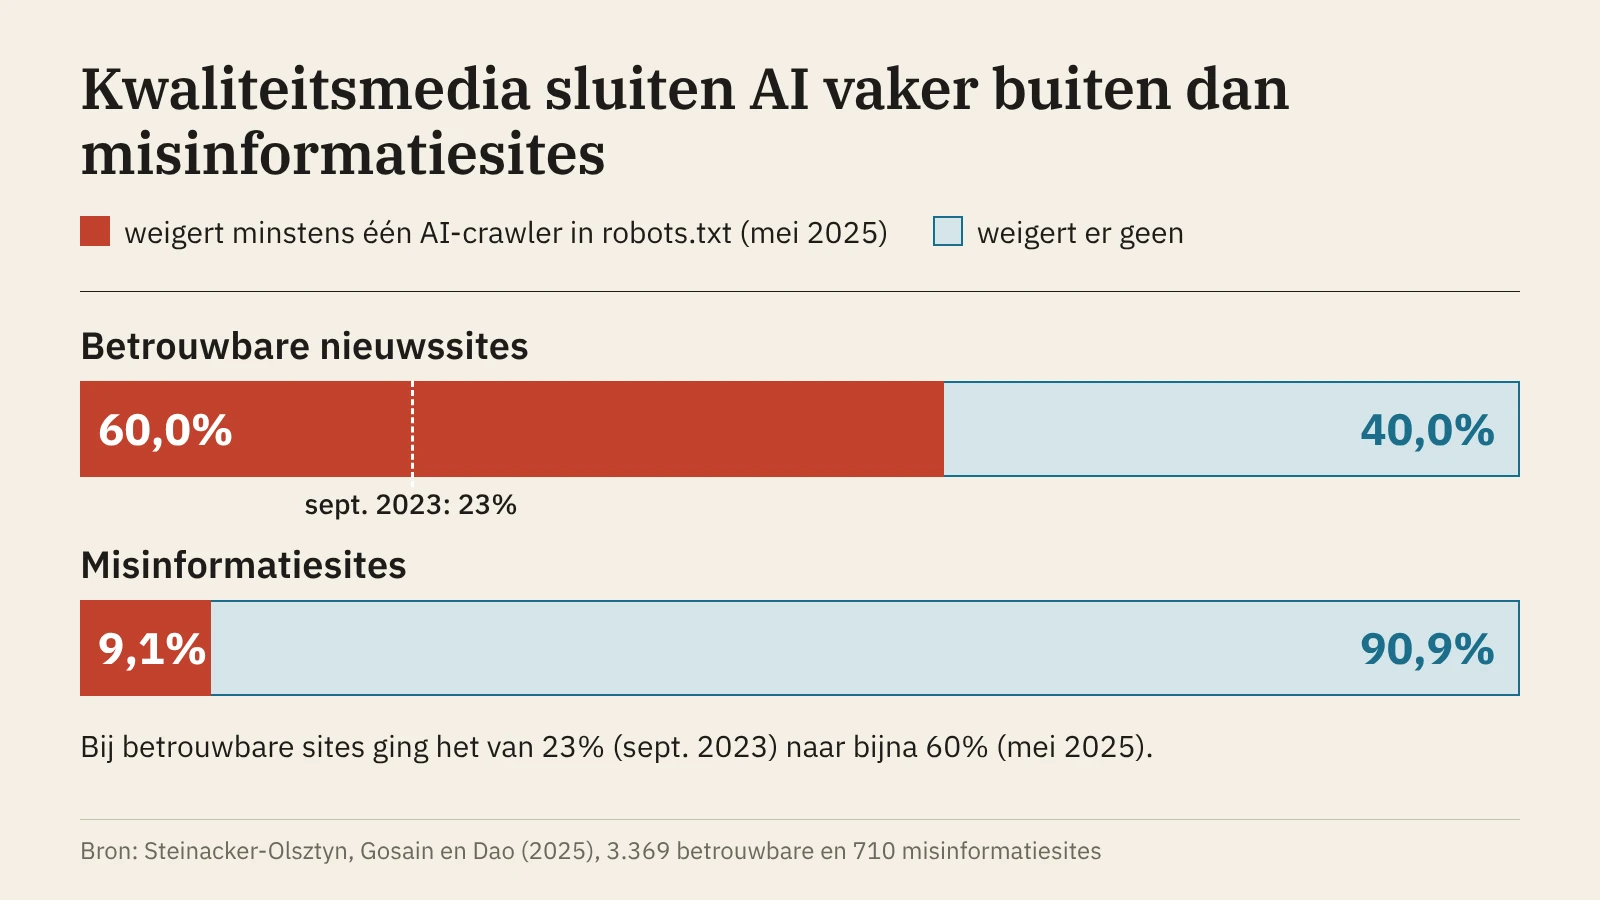
Minder zichtbaar is wat er met de kwaliteit van antwoorden gebeurt. Onderzoekers Nicolas Steinacker-Olsztyn, Devashish Gosain en Ha Dao vonden dat 60 procent van de betrouwbare nieuwssites minstens één AI-crawler weigert, tegenover 9,1 procent van de sites die misinformatie verspreiden. Wie AI buitensluit, beschermt zijn werk, maar laat de open ruimte over aan bronnen die minder streng zijn met de feiten.
Wat je zelf kan doen:
- Vraag je agent welke bronnen hij niet kon openen, zeker bij onderzoek of een aankoop.
- Gebruik waar het kan officiële koppelingen. Agents met een connector of partnerschap lopen minder vaak vast dan agents die als browser rondklikken. Meta sluit voor Muse daarom merkpartnerschappen af, en Dots werkt met koppelingen naar duizenden apps. Zelfs Google hield volgens een gebruiker de agent Instinct tegen terwijl die een Gmail-inbox opruimde.
- Wees voorzichtig met je wachtwoorden. Laat een agent alleen inloggen waar de site dat toelaat. Gebruikers melden geschorste accounts na agentgebruik, en de gebruiksvoorwaarden van grote winkels verbieden niet-geautoriseerde agents.
- Controleer bij belangrijke handelingen zelf de laatste stap, zoals bij een betaling of een boeking.
Wat dit betekent als je een website hebt
Voor websites is de vraag niet langer of AI je site leest, maar wie je binnenlaat, waarvoor en wat je ervoor terugkrijgt. Een paar beslissingen die je nu best bewust neemt:
| Vraag | Waarom het telt | Wat je doet |
|---|---|---|
| Welk beleid staat er nu? | Achter Cloudflare kan je site sinds 15 september agents al weren zonder dat je het weet. | Kijk in je CDN-instellingen en robots.txt welke soorten bots je toelaat. |
| Trainen, zoeken of handelen? | Een trainingscrawler, een zoekbot en een agent die namens een klant komt, zijn drie verschillende bezoekers. | Maak per soort een keuze. Veel uitgevers weren GPTBot (training) maar laten OAI-SearchBot (zoeken) toe. |
| Welke pagina’s? | Artikels, productpagina’s en accountpagina’s vragen elk een ander antwoord. | Beslis per deel van je site, niet voor de hele site in één keer. |
| Blokkeer je ook mensen? | Strengere botcontroles treffen echte klanten. Een gebruiker meldde op X dat Walmart hem als mens buitenhield. | Test je eigen aankoop- en loginproces na elke wijziging aan je botinstellingen. |
| Wil je agents als klant? | Agents brengen bestellingen mee, geen advertentieweergaven. | Webwinkels kunnen agents een eigen ingang geven, zoals Shopify met WebMCP. |
Wie alles blokkeert, verdwijnt ook uit AI-antwoorden en uit de winkelmandjes van agents. Wie alles openzet, geeft zijn inhoud weg. De meeste sites zullen ergens in het midden uitkomen, en dat midden kies je beter zelf dan dat je het overlaat aan een standaardinstelling.
Zo evolueert het, met pasjes, tolpoorten en aparte ingangen
De komende jaren wordt de toegang voor agents waarschijnlijk niet eenvoudig open of dicht. Er groeien drie lagen naast elkaar.
Een pasje voor de agent
Het kernprobleem is dat een site niet ziet wie er aanklopt. Daar werkt de sector nu aan. Met Web Bot Auth ondertekent een agent elke opvraging cryptografisch, zodat een site kan nagaan van wie hij komt. Visa bouwde er in oktober 2025 samen met Cloudflare zijn Trusted Agent Protocol op, en ook Mastercard en American Express werken met Cloudflare aan dezelfde techniek. Begin oktober 2026 kondigden Meta en Sierra het Personal Agent Protocol aan, met steun van onder meer Walmart, Shopify en Stripe. Een agent komt daarin eerst binnen als gast, bijvoorbeeld om een voorraad te checken, en logt via OAuth in voor accounttaken. De klant bepaalt wat zijn agent mag, het bedrijf welke acties toegelaten zijn. OpenAI en Anthropic staan voorlopig niet op de lijst.
Een tolpoort per opvraging
De tweede laag is betalen. De statuscode HTTP 402, “Payment Required”, bestond al decennia zonder echt gebruik. Cloudflare stuurde er in augustus 2025 volgens eigen cijfers dagelijks meer dan een miljard van rond, en kondigde in juli 2026 een Monetization Gateway aan waarmee sites, datasets en API’s agents per opvraging kunnen laten betalen, schrijft Cloudmagazin. De betaalkant zit nog grotendeels in bèta. Over het idee van agents die zelf betalen, lees je meer in ons stuk over de machine native economy volgens BlackRock.
Een aparte ingang voor agents
De derde laag is een eigen rijstrook. Shopify laat browseragents sinds 28 september 2026 via WebMCP een openstaande checkout lezen en afronden, nadat de koper bevestigt. In een eigen test van Shopify lukten zo 60 van de 60 aankopen, tegenover 56 met gewone browserautomatisatie, in gemiddeld 10,3 tegenover 27,4 seconden. Voor agents is zo’n ingang sneller en betrouwbaarder. Voor de winkel is hij controleerbaar.
Wat dat voor het web betekent
Die lagen lossen het probleem van de agent op, maar ze hebben een prijs. MIT Technology Review waarschuwt voor een web dat minder rekening houdt met gewone bezoekers, met zwaardere controles om te bewijzen dat je een mens bent en met prijzen die per agent kunnen verschillen. Volgens MIT Technology Review verwacht Ethan Mollick van Wharton dat de blokkades zich over het hele web verspreiden, omdat agents die terugbetalingen vragen of onderhandelen klantendiensten kunnen overspoelen. Tegelijk schrijft hij dat mensen het steeds minder zullen pikken als hun agent iets niet mag doen wat ze zelf wel mogen.
Ook de regels schuiven. De IETF werkt aan een gemeenschappelijke woordenlijst waarmee sites aangeven wat AI met hun inhoud mag. In Europa moeten aanbieders van AI-modellen voor algemene doeleinden onder de AI Act opt-outs van rechthebbenden respecteren, en de Europese Commissie zoekt met de sector naar een lijst van erkende opt-outprotocollen naast robots.txt. Die regels gaan vooral over trainen. Voor agents die namens jou winkelen of je bank openen, bestaat er in Europa nog geen apart kader.
Onze inschatting voor de komende twaalf maanden: eerst nog meer blokkades, daarna een golf van afspraken. Grote platformen sluiten partnerschappen af en kiezen welke agents binnen mogen. Kleinere sites beslissen intussen via de standaardinstellingen van hun CDN of webshopplatform. Agents die zich niet kunnen tonen, blijven buiten.
Veelgestelde vragen
Mag een website mijn AI-agent blokkeren?
Ja, in de praktijk wel. Een site bepaalt via haar gebruiksvoorwaarden en techniek wie binnen mag. In de Verenigde Staten oordeelde het hof van beroep in een voorlopige procedure dat Amazon waarschijnlijk niet kan aantonen dat Perplexity zelf toegang neemt, omdat de agent op het toestel van de gebruiker draait. Het hof liet uitdrukkelijk open dat sites toegang via hun gebruiksvoorwaarden regelen. Voor zover wij konden nagaan, is er in Europa nog geen vergelijkbare uitspraak.
Wat is het verschil tussen een AI-crawler en een AI-agent?
Een crawler haalt in bulk pagina’s op, om een model te trainen of een zoekindex te vullen. Een agent werkt voor één gebruiker en voert een taak uit, zoals een prijs vergelijken, een tafel reserveren of iets kopen. Cloudflare deelt bots sinds juli 2026 in als Search, Agent of Training.
Respecteren AI-agents robots.txt?
Niet altijd. Volgens TollBit kwam ongeveer 15 procent van de AI-ophaalagents in Europa op pagina’s die robots.txt verbood. OpenAI zegt dat robots.txt voor ChatGPT-User misschien niet geldt, Anthropic zegt dat zijn bots het wel volgen.
Moet ik als webwinkel agents toelaten?
Dat hangt af van je model. Leef je van advertenties, dan brengen agents weinig op. Verkoop je producten, dan brengt een agent mogelijk een klant mee. Geef agents dan liefst een gecontroleerde ingang, zoals een agentcheckout of een officiële koppeling, in plaats van ze door je gewone pagina’s te laten klikken.
Wat is HTTP 402?
Het is een statuscode die “betaling vereist” betekent. Een site kan een agent daarmee vertellen wat een pagina of opvraging kost. De agent betaalt en vraagt de pagina opnieuw op met een betaalbewijs. Cloudflare en andere partijen bouwen er betaalsystemen voor agents op.
Het web krijgt een portier
Bij het vroege web won wie zijn deur openzette voor zoekmachines. Bij het agentweb wint wie weet wie er aanklopt, namens wie en met welk mandaat. Een agent die zich kan identificeren en kan betalen, komt straks verder dan een agent die zich als mens voordoet. En als website-eigenaar is niets beslissen ook een beslissing: dan kiest je CDN.