Thomas Dohmke, tot vorig jaar CEO van GitHub, lanceerde maandag met zijn start-up Entire een eigen platform om code te hosten, te reviewen en te bouwen. Het opvallendste onderdeel heet Trails. Het vervangt de pull request door een dashboard waarop AI-agents elke push scoren, onder meer op veiligheid en op slordige AI-code. Zijn de scores groen, dan mag je volgens Entire mergen zonder elke regel te lezen.
Je kan het vandaag proberen met 100 dollar gratis tokenkrediet, ook met een repository die gewoon op GitHub blijft staan. Maar onderzoek van dit jaar toont dat AI-reviewers zich laten sturen door hoe je een wijziging inleidt. Hieronder lees je hoe Trails werkt, wat het kost en waar je beter toch een mens laat meekijken.
Wat Entire maandag lanceerde
Entire noemt zichzelf de eerste Git-forge voor samenwerking tussen agents en mensen. Het platform bestaat uit drie delen:
- Trails, de vervanger van de pull request. Daarover gaat de rest van dit artikel.
- Gedistribueerde Git-hosting op een eigen server die compatibel is met Git. Je kiest bij de lancering een hoofdregio in de Verenigde Staten, de Europese Unie, India of Australië en kan je code naar andere regio’s laten kopiëren of net in één regio houden.
- Continuous Memory, twee open source plug-ins die lokaal werken: entire-graph, een kaart van je code, en entire-brain, dat de sessies van je coding agents doorzoekbaar maakt. De Entire CLI bewaart die sessies in je Git-geschiedenis. Zo hoeft een volgende agent niet opnieuw uit te zoeken waarom iets ooit zo gebouwd is. Het idee lijkt op het Open Knowledge Format, dat bedrijfskennis als gewone bestanden voor agents klaarzet.
Voor builds en tests werkt Entire samen met Buildkite en Depot, zodat je GitHub Actions-workflows kan meenemen. Het bedrijf haalde in februari een seedronde van 60 miljoen dollar op bij een waardering van 300 miljoen, telt volgens GeekWire zo’n 50 medewerkers en werkt volledig remote. De timing is geen toeval: vandaag begint GitHub Universe, de jaarlijkse conferentie van GitHub in San Francisco.
Waarom de pull request volgens Dohmke niet meer werkt
De redenering van Entire is eenvoudig. Agents schrijven code sneller dan mensen ze kunnen lezen. Volgens Dohmke groeit de reviewstapel in twee richtingen tegelijk: er komen meer wijzigingen bij, en elke wijziging bevat meer code. Coding agents en review-agents zetten bovendien lange beschrijvingen en commentaren in de pull request. In zijn lanceringsblog schrijft hij: “The pull request has become an audit log that only the agent reads.”
Tegen The New Stack gaf hij toe dat hij het zelf meemaakt: “I open a pull request, and I realize I have no idea what all that code does.” Code review was altijd al een flessenhals, zei hij tegen GeekWire, maar die is nu tien keer groter.
Hij staat daar niet alleen in. Anthropic schreef half oktober dat het aantal gemergde wijzigingen in zijn eigen codebase steeg van ongeveer 2.500 per dag in mei naar meer dan 30.000 in september, en dat broncodebeheer daardoor de grootste flessenhals werd. Het bedrijf bouwde een eigen reviewtool waarin reviewers vooral naar de bedoeling van een wijziging kijken. Dat de tijdwinst van AI vaak in de review verdwijnt, lees je ook in ons stuk over waarom AI developers sneller maakt, maar hun team niet.
Zo verloopt een review in Trails
Een Trail begint bij een bugmelding, een vraag voor een nieuwe functie of gewoon vanuit je coding agent, voor of na het eerste werk. Eén Trail kan over meerdere repositories lopen. Daarna gaat het zo:
- Je agent pusht code. Elke push start de review-agents die je voor die repository aanzette.
- Elke review-agent werkt apart in een eigen sandbox in de cloud en geeft een score met uitleg. Onder de motorkap draaien Claude Code en Codex met de nieuwste modellen, in sandboxes van Daytona en E2B.
- Je ziet de scores bovenaan, met de laatste vijf runs per eval ernaast. Zo zie je of een score stabiel is of nog schommelt.
- Bevindingen met een ernstgraad en een voorgestelde oplossing blijven open tot een agent of een mens ze oplost of afwijst. Je kan als mens nog altijd zelf commentaar geven, zoals in een pull request.
- Je agent werkt verder op de feedback en pusht opnieuw. Staat de slop-score op oranje, dan laat je de agent doorgaan tot ze groen wordt.
- Gates bepalen wanneer je mag mergen. Je stelt per repository in wat moet slagen: geslaagde CI-builds, de evals, en als je wil een goedkeuring door een mens.
Elk project krijgt kant-en-klare review-agents voor codekwaliteit, veiligheid en slop. Entire gebruikt in zijn eigen repositories drie evals: Security, Slop en Human Review Required. Die laatste moet, zoals de naam zegt, aangeven of een mens nog moet meekijken. Hoe die eval precies oordeelt, legt Entire niet uit. Eigen review-agents maak je in de webinterface of met een JSON-bestand in je repository, waarin je ook kiest welk model van Anthropic of OpenAI ze gebruiken. Volgens The New Stack kan je zo ook meten hoeveel een lange sessie afdreef van de oorspronkelijke vraag, wat Entire intent drift noemt.
Wat Trails echt anders maakt dan een AI-reviewer in een gewone pull request, is de context. Volgens The New Stack worden de oorspronkelijke vraag en de sessie van de agent deel van de review, en volgens Entire toont een Trail ook wat de agent onderweg leerde. Je beoordeelt dus de bedoeling en het resultaat samen. GitHub heeft met Copilot code review sinds maart ook een agentische reviewer, maar die blijft een commentator in de klassieke pull request.
Wat het kost
Hosting, Trails en de standaard runners zijn gratis. Je betaalt alleen de tokens die je review-agents verbruiken, tegen de gewone prijs van het model. Elke billing-account krijgt eenmalig 100 dollar startkrediet, zonder kredietkaart. Dat krediet vervalt na 90 dagen. Daarna koop je vooraf krediet vanaf 10 dollar. Valt je saldo op nul, dan stoppen je agents in alle regio’s.
| Model in Entire | Input per miljoen tokens | Output per miljoen tokens |
|---|---|---|
| Claude Opus 5.5 (standaard bij Anthropic) | 4 dollar | 20 dollar |
| Claude Sonnet 5.5 | 2 dollar | 10 dollar |
| Claude Haiku 5.5, tot 100.000 tokens per prompt | 0,10 dollar | 0,50 dollar |
| GPT-6.1 Sol (standaard bij OpenAI) | 2 dollar | 10 dollar |
| GPT-6 Astra | 10 dollar | 50 dollar |
Een rekenvoorbeeld: een review-agent op Opus 5.5 die 200.000 tokens leest en 10.000 tokens schrijft, kost ongeveer 1 dollar. Met drie review-agents per push en een paar pushes per Trail heb je met het startkrediet dus ruwweg dertig pushes om het uit te proberen. Gecachte input is veel goedkoper, en met GPT-6.1 Sol kost dezelfde run ongeveer de helft. Prijzen van oktober 2026, volgens de tarieflijst van Entire.
Zo test je het zonder GitHub te verlaten
Je hoeft niet te verhuizen om Trails te proberen. Met de GitHub-app van Entire laat je een repository spiegelen naar de regio’s die je kiest. GitHub blijft dan de bron, Trails werkt bovenop je pull requests, en pushes gaan gewoon terug naar GitHub. Ligt GitHub plat, dan blijft Entire clones en fetches bedienen vanuit de spiegel, en kunnen agents verder pushen naar branches die met entire/unmirrored/ beginnen tot GitHub terug is.
Wil je eerst lokaal zien wat de review-agents vinden, dan kan dat met de open source CLI. Met entire review --configure stel je een profiel in met meerdere reviewers, bijvoorbeeld Claude Code en Codex, en een model dat als rechter de verslagen samenvoegt tot één oordeel. Met entire review laat je ze je branch beoordelen, met entire review --findings bekijk je de bevindingen. De handleiding raadt aan om bevindingen die meerdere reviewers vonden apart te zetten van wat maar één reviewer zag.
Kies je voor de EU-regio, dan blijft je private repository in Europa. Hou er wel rekening mee dat sessies van je agents met Continuous Memory in je Git-geschiedenis belanden, en wat ooit in Git staat, haal je er moeilijk weer uit. Kijk dus wat er in je prompts staat. Waarom zulke logs net zo waardevol zijn, lees je in ons stuk over Meta-Harness.
Waar AI-review tekortschiet
De belofte van Trails staat of valt met de vraag of de scores kloppen. Daar is goed en minder goed nieuws over.
Het goede nieuws: sterke modellen vinden veel. In een studie van februari met meer dan 9.000 tests vonden commerciële modellen 89 tot 96% van de kwetsbaarheden in de testcode. Misleidend commentaar in de code zelf veranderde daar nauwelijks iets aan. De missers zaten vooral in race conditions, timingproblemen en ingewikkelde autorisatielogica, en net die fouten zijn het gevaarlijkst.
Het minder goede nieuws komt uit onderzoekers uit Athene van maart. Wie een wijziging inleidt als foutloos, verlaagt de kans dat een AI-reviewer de fout ziet sterk. Bij GPT-4o-mini zakte de detectie van 97,2% naar 3,6%. Bij Claude 3.5 Haiku daalde ze bijna 60 procentpunt. De onderzoekers stuurden ook pull requests in die een bekende fix terugdraaiden en dat voorstelden als veiligheidsverbetering. Bij Copilot lukte dat in 35% van de gevallen. Bij Claude Code, waar ze hun uitleg konden bijschaven, in 88%. Wie de omschrijving wegliet en de reviewer uitdrukkelijk vroeg om die te negeren, zag de detectie terugkomen: bij Copilot in alle gevallen, bij Claude Code in 94%.
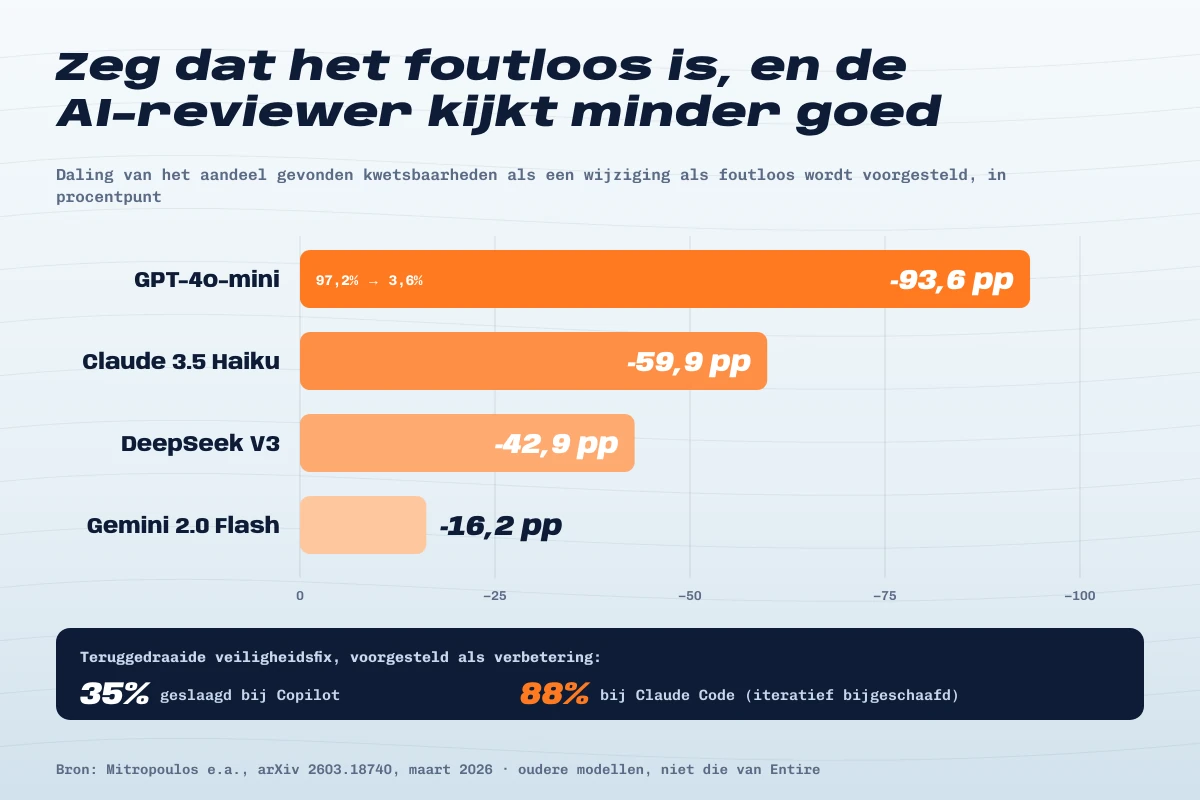
Die modellen zijn ouder dan wat Entire gebruikt, dus de cijfers zeggen niet hoe Trails zelf scoort. Maar het mechanisme raakt de kern van Trails, dat net de vraag en de sessie van de agent bij de review betrekt. Voor een mens is dat nuttige context. Krijgt een review-agent die ook mee, dan kan het sturing zijn: wie leest dat iets een veiligheidsfix is, gelooft dat sneller. In reacties op daily.dev klonk dezelfde twijfel. Developers vragen zich af of scores betrouwbaar genoeg zijn om op te mergen, en wijzen erop dat eval-modellen verschuiven zodra het onderliggende model verandert.
Gebruik je Trails, dan helpt dit:
- Laat minstens één security-eval alleen de code zien, zonder vraag of sessie, en vraag hem uitdrukkelijk om omschrijvingen te negeren.
- Zet een gate met menselijke goedkeuring op wijzigingen aan authenticatie, betalingen, rechten en gelijktijdige verwerking, ook als alle scores groen zijn.
- Leg per eval vast welk model hij gebruikt en kijk na een modelwissel of je scores verschuiven.
- Combineer de evals met klassieke statische analyse. In de studie van februari haalde die combinatie de beste resultaten.
Hoe snel is 89 keer sneller?
Entire zegt dat pushen tot 89 keer sneller gaat dan bij GitHub en 6 keer sneller dan bij Cursor Origin, de Git-hosting die Cursor in augustus lanceerde. In Entires eigen grafiek haalt het 418 pushes per seconde tegenover 4,7 voor GitHub. Die cijfers komen uit ForgeMark, een benchmark die Entire zelf schreef en open source zette. Hij meet hoeveel kleine pushes veel agents tegelijk kwijt kunnen, niet hoe snel een gewoon team werkt. Laat je tientallen agents tegelijk op één codebase los, dan telt dat. Voor een team van vijf developers merk je het nauwelijks. Hetzelfde geldt voor de 71% minder tokens die de code-graph zou opleveren: een claim uit eigen tests, die nog niemand onafhankelijk nagemeten heeft.
Minder lezen, niet minder opletten
Trails verplaatst de review van regels naar beslissingen: wat vroeg je, wat deed de agent, en welke risico’s zien de reviewers. Dat is een eerlijk antwoord op een probleem dat elk team met coding agents kent. Maar de gate “mens nodig?” is de belangrijkste instelling in het hele product, en die laat je best niet aan een score over. Probeer Trails eerst op een gespiegelde repository die niet bedrijfskritisch is, vergelijk de bevindingen met je eigen review, en beslis dan pas welke wijzigingen je ongelezen laat passeren. Vandaag om 17 uur Belgische tijd begint de keynote van GitHub Universe. Daar hoor je hoe GitHub antwoordt.
Veelgestelde vragen
Is Entire gratis?
Hosting en Trails zijn gratis. Je betaalt de tokens van je review-agents tegen marktprijs. Je start met 100 dollar krediet dat 90 dagen geldig is.
Kan ik Entire gebruiken als mijn code op GitHub staat?
Ja. Je spiegelt je repository met de GitHub-app van Entire. GitHub blijft de bron en Trails werkt bovenop je pull requests.
Waar staat mijn code bij Entire?
Bij de lancering kies je een hoofdregio: de Verenigde Staten, de Europese Unie, India of Australië. Je kan je code in één regio houden of naar andere regio’s laten kopiëren.
Welke AI-modellen gebruikt Trails?
De review-agents draaien op Claude Code en Codex. Standaard is dat Claude Opus 5.5 of GPT-6.1 Sol, maar je kiest zelf andere modellen van Anthropic of OpenAI.
Vervangt Trails menselijke review volledig?
Alleen als jij dat instelt. Met gates kan je per repository een menselijke goedkeuring verplichten, en dat is voor gevoelige code een goed idee.