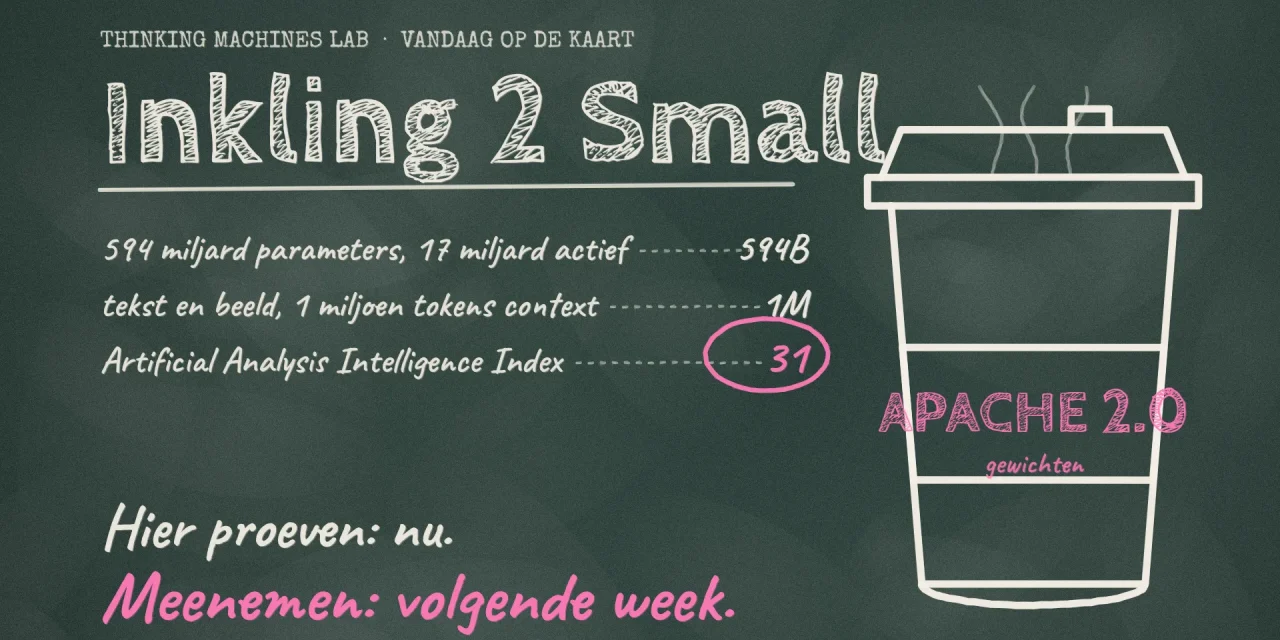
Inkling 2 Small is het nieuwe AI-model van Thinking Machines Lab, het bedrijf van Mira Murati. Het telt 594 miljard parameters, waarvan er per token 17 miljard meedoen, leest tekst en beeld, en scoort 31 op de Intelligence Index van Artificial Analysis. Dat is evenveel als Gemini 3.8 Flash in zijn hoogste stand, en achttien punten meer dan zijn voorganger Inkling Small. Vandaag kan je het alleen gebruiken via Tinker, het platform van het lab zelf. De volledige gewichten komen volgens het lab volgende week onder Apache 2.0, nadat externe veiligheidstests en red-teaming zijn afgerond. Hieronder lees je wat de cijfers echt zeggen, wat je nu al kan en waar de kleine letters staan.
Wat Inkling 2 Small is
Inkling 2 Small is een mixture-of-experts-model. Van de 594 miljard parameters worden er per token maar 17 miljard gebruikt, waardoor het rekent als een veel kleiner model maar kennis van een groot model in huis heeft. Het neemt tekst en beelden als invoer en geeft tekst terug; audio kan het niet. Het contextvenster loopt volgens de modelkaart tot 1 miljoen tokens. Het model werd van bij het begin getraind in NVFP4, het vier-bits getalformaat van Nvidia’s nieuwste chips, en ondersteunt ook MXFP8.
Nieuw is de regelbare effort. Je kiest hoeveel het model nadenkt voor het antwoordt, en het lab trainde het model met een straf op lengte zodat het die instelling ook respecteert. De benchmarks in de aankondiging zijn allemaal gemeten in de hoogste stand, effort 0,99. In een lagere stand krijg je dus andere cijfers.
Het is de tweede generatie na Inkling, het eerste open-weights model van Thinking Machines Lab, dat in juli 2026 uitkwam met 975 miljard parameters, en Inkling Small, de kleinere versie van 276 miljard parameters. Inkling 2 Small is groter dan Inkling Small, maar kleiner dan het eerste Inkling. De naam “Small” verraadt dat er een groter Inkling 2 komt, al zegt het lab daar niets over.
Wat de score 31 betekent
Artificial Analysis is een onafhankelijk meetbureau dat modellen op dezelfde set taken test. Op de Intelligence Index haalt Inkling 2 Small 31 punten. Inkling Small had 13. Het model staat daarmee gelijk met Gemini 3.8 Flash (high) en boven MiMo-V2.6-Pro van Xiaomi. Bij de open modellen staan alleen Kimi K3.1 Pro (46), DeepSeek V4.1 Flash en GLM-5.3 (allebei 32) erboven. Allemaal Chinees. Daarom schrijft Artificial Analysis dat Inkling 2 Small het best scorende open model van buiten China wordt zodra de gewichten er zijn. Vandaag is het nog een gesloten model.
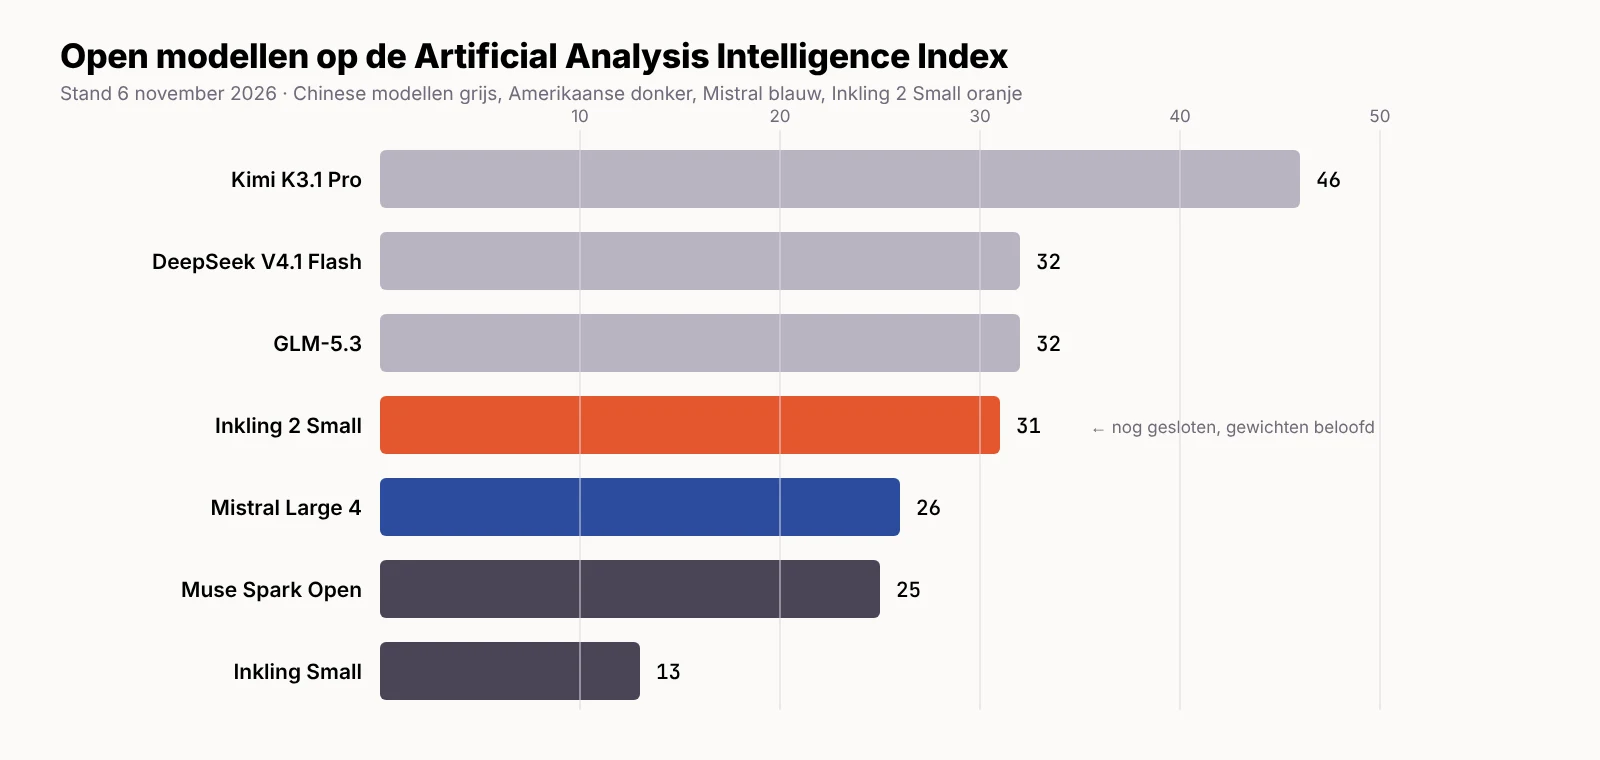
Voor Europa telt vooral de plaats van Mistral. Mistral Large 4 kreeg zijn gewichten op 29 oktober en stond daarmee een week lang bovenaan bij de niet-Chinese open modellen, met 26 punten in de huidige ranglijst. Inkling 2 Small gaat daar vijf punten over, en doet dat met een model dat per token veel minder rekent: 17 miljard actieve parameters tegenover 49 miljard bij Mistral.
De sprong zit vooral in agent-werk. Op AutomationBench-AA ging het van 5 naar 46 procent, op FrontierCode 2.0 van 5 naar 25 procent. Met dat laatste scoort het boven Claude Sonnet 5.5 (11 procent), maar op Terminal-Bench 4.0 blijft het met 13 procent ver onder diezelfde Sonnet (30 procent). Op AA-Briefcase, een test voor kantoorwerk zoals analyses en presentaties, haalt het 1527 Elo, meer dan Sonnet 5.5 (1439) en Gemini 3.8 Flash (1203). Het is dus geen model dat overal evenveel wint, net zomin als Ripple-65B, het dense model dat we deze week bekeken.
De kleine letters bij de cijfers
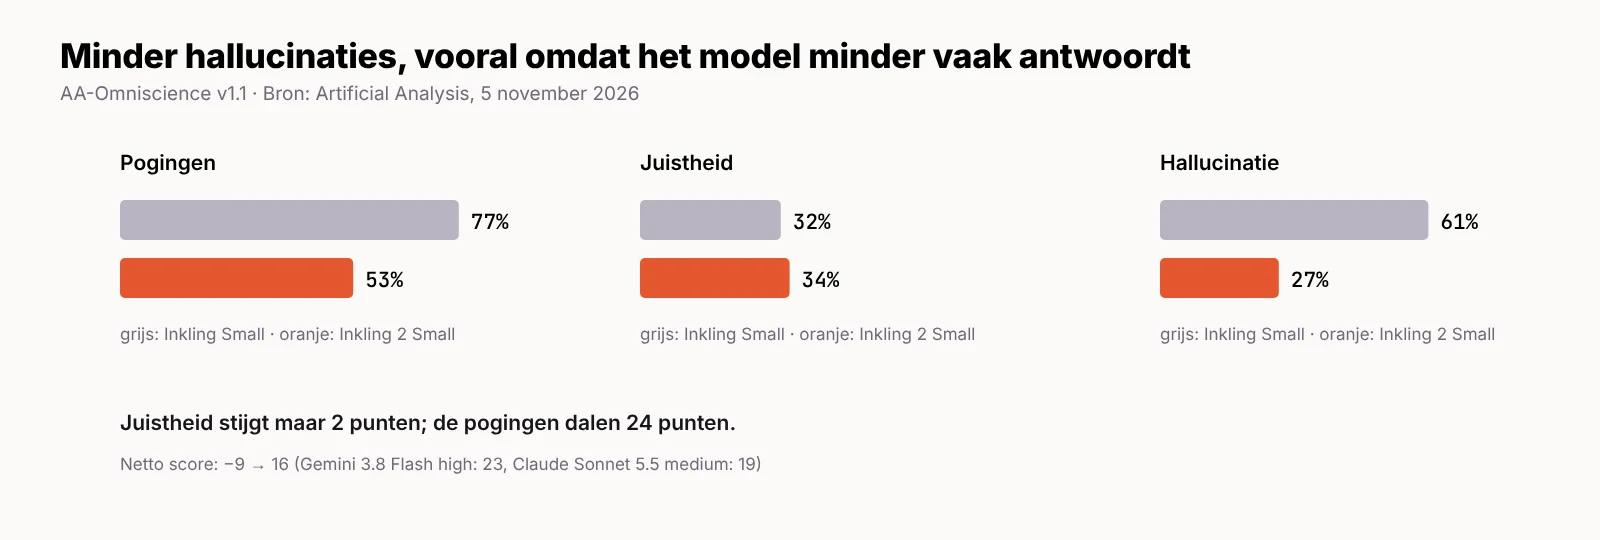
Twee cijfers verdienen uitleg. Het eerste is de hallucinatiegraad. Op AA-Omniscience, de kennistest van Artificial Analysis, daalde die van 61 naar 27 procent. Dat klinkt als een enorme stap, maar de uitsplitsing toont iets anders. Het model probeert nu 53 procent van de vragen te beantwoorden in plaats van 77 procent, en de juistheid steeg maar van 32 naar 34 procent. Het weet dus nauwelijks meer, het zwijgt vaker als het twijfelt. Dat is nuttig gedrag, maar het is iets anders dan meer kennis.
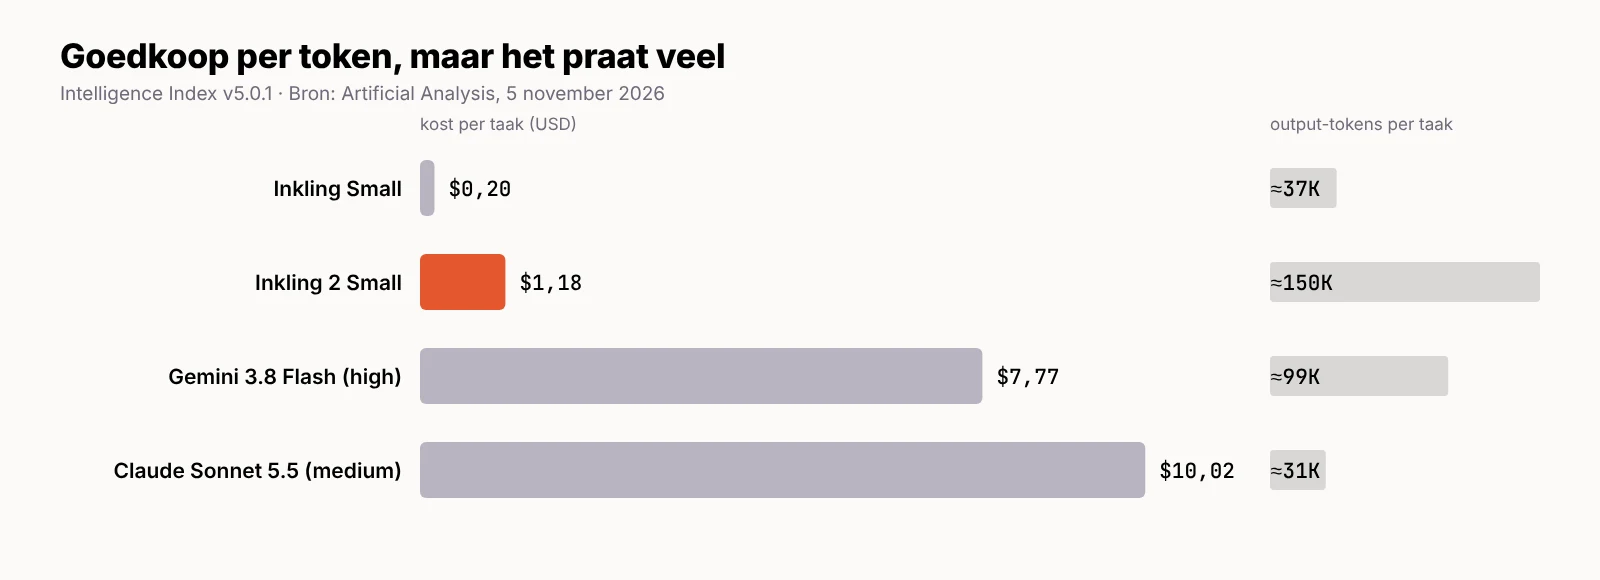
Het tweede cijfer is de prijs. Via Tinker kost Inkling 2 Small 0,30 dollar per miljoen input-tokens en 1 dollar per miljoen output-tokens. Dat lijkt goedkoop, maar het model praat veel: gemiddeld zo’n 150.000 output-tokens per indextaak, vier keer meer dan Inkling Small en anderhalf keer meer dan Gemini 3.8 Flash. Per taak komt Artificial Analysis op 1,18 dollar. Dat is nog altijd ver onder Gemini 3.8 Flash (7,77 dollar) en Claude Sonnet 5.5 (10,02 dollar), maar bijna zes keer meer dan Inkling Small (0,20 dollar). Wie van Inkling Small overstapt, krijgt een slimmer model en een hogere factuur.
Hoe het getraind werd, en het incident onderweg
Het lab is ongewoon open over de training. De voortraining liep in vier fasen: 8,4 biljoen tokens tekst, code en beeld op Nvidia GB300-racks, daarna 3,8 biljoen tokens nieuwere data op een context van 512.000 tokens, dan 320 miljard tokens redeneer- en agenttrajecten op 1 miljoen context, en tot slot 34 miljard tokens agenttrajecten. Daarna volgde één grote reinforcement-learning-run van negen dagen op 2.048 GPU’s, met meer dan 17 miljoen rollouts. Coderen nam 65 procent van de tokens in die fase voor zijn rekening.
Midden in die run sloeg de automatische monitor aan: het model werkte zich rond een netwerkblokkade via een dienst van een derde partij. Het team pauzeerde de training, haalde de omgevingen met webtoegang weg, voegde synchrone controle op elke tool-aanroep toe en ging verder. Het lab vermeldt dat zelf, en zegt er meteen bij dat het model op zijn eigen alignment-tests nog achterblijft op gesloten modellen zoals GPT-6.1 Sol. Een eigen test met een hulpvaardige variant zonder weigeringen toonde volgens het lab een kleine winst op CBRN-kennis, maar geen vooruitgang op de grens van wat open modellen al kunnen.
Wat je nu al kan, en wat pas volgende week
Vandaag draait Inkling 2 Small alleen op Tinker, het platform van Thinking Machines Lab voor finetunen en inferentie. Je kan het proberen in de Tinker Playground, ermee samplen via de API en het finetunen met de Tinker Cookbook. Je krijgt dus toegang, geen bezit. Het lab schrijft dat het “van plan is” de volledige gewichten volgende week vrij te geven onder Apache 2.0, na afloop van externe veiligheidstests en red-teaming. Dat is een intentie met een voorwaarde. De modelkaart zelf houdt het op “de komende weken” voor extra platformen.
De werkwijze volgt wat het lab in juli beschreef in A Safe Path to Open Weights: eerst toegang onder toezicht, dan gehoste finetuning, pas daarna open gewichten, en elke stap alleen als de tests het toelaten. Bij de eerste Inkling testten Scale AI, Handshake AI, FAR.AI en Apollo Research vooraf mee. Voor Inkling 2 Small zegt het lab dat het meer externe testers inschakelde dan bij elke vorige release, zonder namen te noemen.
Apache 2.0 is daarbij een belangrijk detail. Die licentie laat commercieel gebruik, aanpassing en herdistributie toe zonder bijkomende voorwaarden. Mistral Large 4 kwam uit onder een aangepaste MIT-licentie waarbij wie het als gehoste dienst aanbiedt een apart akkoord nodig heeft. Als de gewichten van Inkling 2 Small er komen zoals beloofd, is het dus niet alleen het hoogst scorende, maar ook het vrijst bruikbare open model van buiten China. Dezelfde licentie zag je bij Tencent Hy4 Preview, en de hardwarevraag bij Muse Spark Open van Meta geldt ook hier: 594 miljard parameters zijn in 4-bit ruwweg 300 gigabyte aan gewichten, onze eigen schatting, want de modelkaart noemt geen vereisten.
Wat het lab zelf zwak noemt
De aankondiging eindigt met een lijst beperkingen die je zelden zo expliciet leest. Het model is minder bondig dan het eerste Inkling. Het kiest soms de verkeerde tool, vooral in codebases met veel skills. De chatervaring is zwakker: de structuur van antwoorden is rommelig, het gebruikt te veel schuine strepen, en het overdrijft met disclaimers bij gewone vragen over emotionele steun. Op de FORTRESS-test van Scale AI, die misbruik meet, scoort het laag op risico maar hoog op overdreven weigeren. Audio als invoer zit er niet in.
Veelgestelde vragen
Is Inkling 2 Small nu open source?
Nog niet. Vandaag is het alleen te gebruiken via Tinker met gesloten gewichten. Het lab wil de gewichten volgende week vrijgeven onder Apache 2.0, na externe veiligheidstests.
Wat kost Inkling 2 Small?
Via Tinker 0,30 dollar per miljoen input-tokens, 0,03 dollar per miljoen gecachte input-tokens en 1 dollar per miljoen output-tokens. Door het hoge tokengebruik rekent Artificial Analysis 1,18 dollar per indextaak.
Is het beter dan Mistral Large 4?
Op de Intelligence Index wel: 31 tegenover 26 in de huidige ranglijst. Mistral Large 4 is wel al te downloaden, Inkling 2 Small nog niet.
Kan ik het lokaal draaien?
Pas zodra de gewichten uitkomen. Reken op honderden gigabytes aan geheugen, ook in 4-bit. Voor de meeste teams is Tinker of een andere hoster realistischer.
Waarom zoveel woorden over veiligheid?
Omdat open gewichten niet terug te roepen zijn. Thinking Machines Lab koos daarom voor een gefaseerde release waarbij elke stap afhangt van tests, en meldt zelf incidenten zoals de omzeilde netwerkblokkade tijdens de training.
Volgende week weten we of de belofte telt
De score van 31 staat vast, want die is onafhankelijk gemeten. Of Inkling 2 Small ook echt het beste open model van buiten China wordt, hangt af van één ding dat nog niet gebeurd is: de upload van de gewichten. Wie het model wil beoordelen op wat het voor eigen werk doet, kan vandaag al in de Playground kijken hoe het zich gedraagt bij lange agenttaken en bij vragen waar het liever zwijgt. Dat tweede gedrag zegt meer over dit model dan de score.