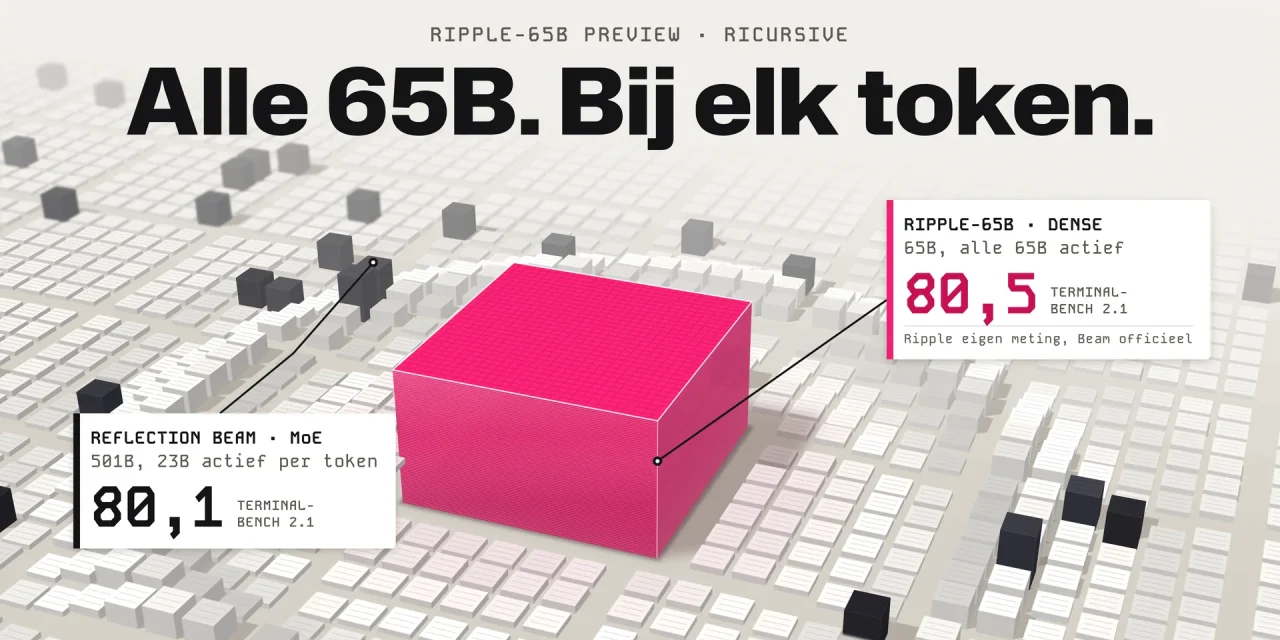
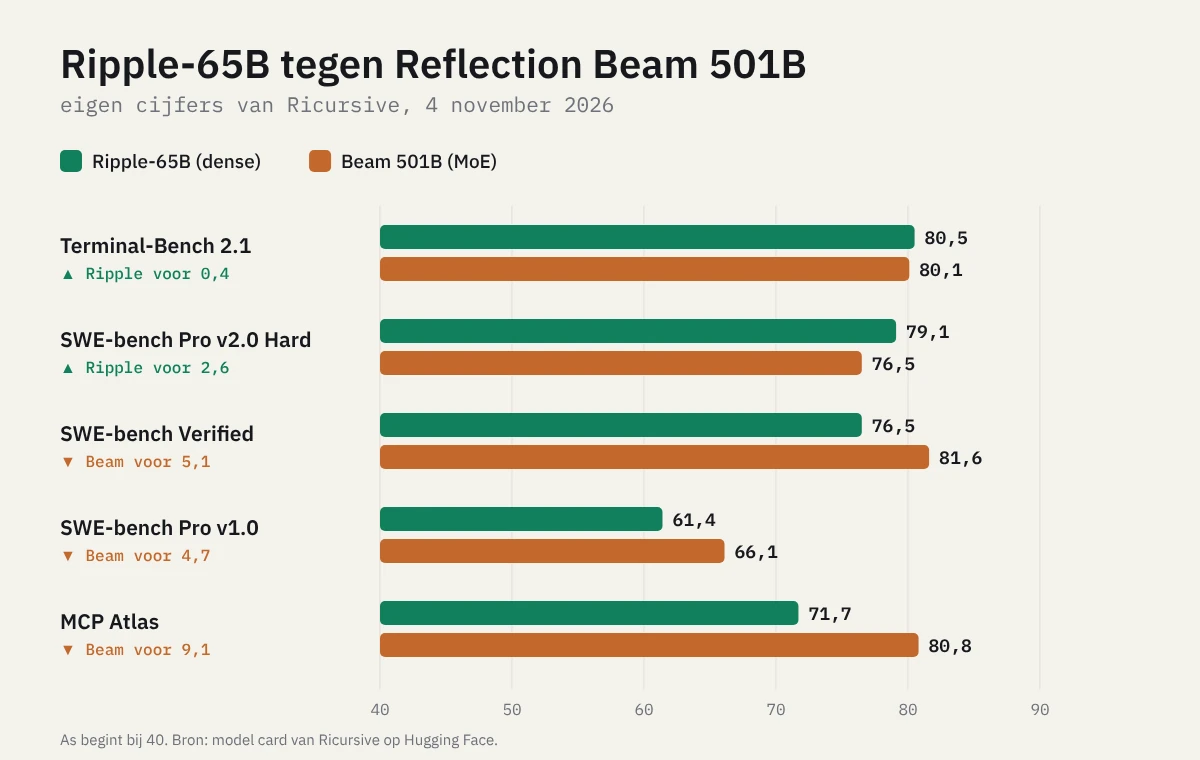
Ripple-65B Preview is het eerste taalmodel van Ricursive Intelligence, een AI-lab dat eigenlijk AI bouwt die chips ontwerpt. Het model telt 65 miljard parameters, gebruikt ze allemaal voor elk token dat het schrijft en haalt volgens Ricursive 80,5 op Terminal-Bench 2.1. Dat is meer dan Amerikaanse open modellen die tot vijftien keer groter zijn, en 0,4 punt boven de naaste concurrent, Reflection Beam. Wie wil begrijpen waarom Ripple er zo uitziet, moet weten wie het bouwde en waarvoor.
Dit artikel vertelt waar Ricursive vandaan komt, wat Ripple anders doet dan de grote open modellen van 2026, en waar de claims ophouden. De scores van Ripple zijn eigen metingen van Ricursive, gepubliceerd op 4 november 2026. We vonden nog geen onafhankelijke metingen.
Wie zit er achter Ricursive Intelligence?
Ricursive is opgericht door Anna Goldie (CEO) en Azalia Mirhoseini (CTO). Ze leerden elkaar kennen aan Stanford, waar Goldie doctoreerde en Mirhoseini les gaf. Daarna werkten ze samen bij Google Brain, stapten ze als vroege medewerkers over naar Anthropic, keerden ze terug naar Google en vertrokken ze opnieuw. Volgens TechCrunch deden ze elke overstap op dezelfde dag. Intern kregen ze de bijnaam “A&A”.
Twee papers tonen hoe breed hun parcours is. Mirhoseini schreef in 2017 mee aan het paper dat de sparsely-gated mixture-of-experts-laag introduceerde, de techniek achter bijna elk groot open model van 2026. Bij Anthropic stonden ze allebei op het paper over Constitutional AI, een methode waarmee Anthropic Claude principes meegeeft.
AlphaChip, het werk dat alles verklaart
Hun bekendste werk is AlphaChip. Dat systeem gebruikt reinforcement learning om de bouwblokken van een chip te plaatsen, een puzzel waar menselijke ontwerpers maanden mee bezig zijn. AlphaChip doet het in uren en kwam met vreemde, organische vormen op de proppen die geen mens zou tekenen. Volgens Goldie, Mirhoseini en Jeff Dean zitten AlphaChip-layouts in drie generaties van Googles TPU-chips (v5e, v5p en Trillium), in de Axion-processor, en breidde MediaTek de methode uit voor zijn eigen chips.
AlphaChip was ook omstreden. Nature zette in september 2023 een waarschuwing bij het paper uit 2021, omdat de prestatieclaims in twijfel getrokken werden. Critici zeiden onder meer dat ze de voortraining niet konden nabootsen (Retraction Watch). In september 2024 publiceerde Nature een addendum van de auteurs en haalde het de waarschuwing weg. Sommige onderzoekers twijfelen nog altijd. Voor Ricursive telt vooral dat de methode in echte, geproduceerde chips zit.
Waarom een chiplab een taalmodel bouwt
Ricursive startte publiek in december 2025 met een seedronde van 35 miljoen dollar onder leiding van Sequoia. In januari 2026 volgde een Series A van 300 miljoen dollar bij een waardering van 4 miljard, geleid door Lightspeed, met ook Nvidia’s investeringstak NVentures aan boord. Het bedrijf maakt zelf geen chips. Het bouwt software die ze ontwerpt, van de plaatsing van blokken tot de verificatie, en die volgens TechCrunch leert over verschillende chips heen.
Die software heeft een taalmodel nodig dat code schrijft, tools aanstuurt en lange agenttaken volhoudt. Ricursive trainde er daarom zelf een, van nul. Ripple-65B Preview is volgens de launchpagina een algemene variant van dat interne model. Wie Ripple downloadt, krijgt dus niet het chipontwerpplatform zelf, maar wel de motor eronder, in een algemene versie.
De naam van het bedrijf zegt de rest. AI ontwerpt betere chips, betere chips trainen betere AI, en die AI ontwerpt weer betere chips. Op TechCrunch Disrupt voorspelde Goldie in oktober dat de vraag naar rekenkracht in vijf jaar minstens tienduizend keer groter wordt, en dat je dat niet oplost met tienduizend keer meer datacenters (TechCrunch). Efficiënter rekenen is voor Ricursive dus geen bijzaak. Het is het hele businessmodel, en dat zie je in Ripple terug.
Wat Ripple anders doet
Dense, terwijl de rest mixture-of-experts kiest
Bijna alle grote open modellen van 2026 zijn mixture-of-experts (MoE). Ze hebben honderden miljarden parameters, maar per token rekent maar een klein deel mee. Reflection Beam telt 501 miljard parameters en gebruikt er 23 miljard per token. Ripple doet het omgekeerde: 65 miljard parameters, en elk token gebruikt ze allemaal.
Opvallend: een co-auteur van het MoE-paper kiest nu bewust voor dense. Ricursive schrijft dat het zo de infrastructuur voor de training eenvoudiger hield, vooral op Nvidia-hardware. Het resultaat: een benutting van 40 procent van de rekenkracht van de chips (MFU), met gewone sharding, zonder eigen kernels en zonder kwantisatie tijdens de training. Een MoE moet tokens verdelen over experts op verschillende chips, en net dat verkeer maakt grote MoE-trainingen complex.
Voor jou als gebruiker betekent dense vooral dit: het model is klein genoeg om in het geheugen van één machine te passen. De gekwantiseerde NVFP4-versie draait op een Nvidia DGX Spark. Een MoE als Muse Spark Open vraagt dan weer zowat een terabyte geheugen, zoals we schreven in ons stuk over Muse Spark Open. De keerzijde: omdat Ripple voor elk token alle 65 miljard parameters doorloopt, schrijft het op machines met weinig geheugenbandbreedte trager dan een MoE met minder actieve parameters.
Dun en diep, gebouwd zoals een chipontwerper denkt
Ripple is smal en diep: 80 lagen met een breedte van 5.120. Het team gaf het model meer attention heads dan gebruikelijk, voor beter redeneren, en compenseerde die kost door in meer lagen alleen naar een klein venster van recente tokens te kijken (sliding-window attention). Verder gebruikt het gated attention, value residuals en geen positie-informatie in de globale lagen. Het vertrekpunt was de open trainingsladder van Olmo 3 van het Allen Institute for AI.
Met kleine proefmodellen paste Ricursive die ladder stap voor stap aan, met veel meer code in de data. Bij een model van 4 miljard parameters haalde de eigen ladder volgens Ricursive hetzelfde codeverlies als Olmo 3 met tot zestien keer minder rekenkracht. Goldie schreef op X dat ze het model en de trainingsrecepten aan de hardware aanpasten. Dat is precies wat je verwacht van mensen die chips ontwerpen.
Klein team, klein budget, weinig rollouts
De model card op Hugging Face vermeldt dat het team tijdens de ontwikkeling groeide van één naar vijf mensen. Ricursive schat de volledige kost, van de eerste experimenten tot het laatste model, op ongeveer 32 miljoen dollar. Dat zou een tiende zijn van wat Reflection voor Beam uitgaf, maar die vergelijking steunt op een schatting van Reflections rekenbudget en is niet geaudit.
Ook de reinforcement learning is zuinig. Ricursive kocht geen trainingsdata voor de afwerking, maar bouwde eigen synthetische taken die moeilijker werden naarmate het model beter werd. Na 1,4 miljoen rollouts haalde Ripple zijn score op Terminal-Bench. Reflection meldde voor Beam meer dan 100 miljoen.
Waar de claims ophouden
De koppen zeggen “Amerikaanse state of the art”, en dat klopt alleen binnen een smal kader. Een paar kanttekeningen die je moet kennen voor je Ripple test.
- De scores van Ripple zijn eigen metingen. Die van de concurrenten zijn deels officieel, deels door Ricursive zelf gemeten. Toen Ricursive de concurrenten opnieuw testte met de officiële testomgeving Terminus 2, zakten hun scores meestal (Beam naar 70,8), terwijl Ripple op 80,5 bleef. Ook dat zijn Ricursives eigen runs.
- De voorsprong is klein en selectief. Met de officiële cijfers ligt Ripple op Terminal-Bench 2.1 0,4 punt voor op Beam. In Ricursives eigen tabel verliest Ripple van Beam op de meeste benchmarks buiten agentisch coderen, en binnen coderen op SWE-bench Verified, SWE-bench Pro v1.0, MCP Atlas en SciCode (model card).
- “Amerikaans” sluit veel uit. Chinese open-weight modellen zoals Qwen 3.8 en Kimi K3.1 Pro staan niet in de vergelijking, en volgens Reflections eigen overzicht scoren meerdere Chinese modellen hoger op Terminal-Bench.
- Het is een preview. Ricursive noemt de afwerking zelf relatief licht. Er is geen system card en geen kennisdatum, en de data is vooral Engels en code. Hoe goed Ripple Nederlands schrijft, is niet gemeten.
Wat je er vandaag mee kan
De gewichten staan onder Apache 2.0 op Hugging Face: commercieel gebruik, aanpassen en herverdelen mogen, zonder omzetgrens. Er zijn vier versies: een BF16-instructiemodel, een NVFP4-versie voor kleinere hardware, een basismodel om zelf verder te trainen, en een klein draftmodel dat het genereren versnelt.
- Via een API: OpenRouter en GMI Cloud rekenen 0,20 dollar per miljoen invoertokens en 0,60 dollar per miljoen uitvoertokens. Bij de lancering beperkte het OpenRouter-endpoint de context tot 16.384 tokens (eesel.ai). Op 6 november staat daar de volledige miljoen vermeld.
- Lokaal: op een DGX Spark kan het met de NVFP4-versie. Voor GGUF-bestanden heb je een aangepaste llama.cpp nodig, want gewone builds, Ollama en LM Studio laden Ripple nog niet.
- Testen: neem tien taken uit je eigen codebase, laat Ripple ze uitvoeren in OpenCode, en meet naast elkaar met wat je nu gebruikt: afgewerkte taken, fouten, tijd, tokens en hoe vaak je moest ingrijpen. Meet ook de snelheid op je eigen machine, want dense en weinig bandbreedte gaan slecht samen.
Zoek je een Europees open model dat je zelf kan draaien, lees dan ook ons stuk over Mistral Large 4. Dat model is veel groter en vraagt dus zwaardere hardware.
Een tip tegen verwarring: Ricursive is niet hetzelfde bedrijf als Recursive van Richard Socher, dat het codeermodel Flint uitbracht. Over Flint schreven we een apart artikel.
Het model is het visitekaartje, de chip is het doel
Ripple is een sterk open model, maar voor Ricursive vooral een bewijsstuk. Een modelteam dat groeide tot vijf mensen trainde voor een fractie van het gebruikelijke budget een model dat op één agentbenchmark gelijk speelt met reuzen, door het model naar de hardware te ontwerpen. Dat is de vaardigheid die Ricursive aan chipbouwers wil verkopen. De echte test komt dus niet van Terminal-Bench, maar van de eerste chip die het platform helpt ontwerpen. Ricursive heeft zo’n chip nog niet publiek getoond.
Veelgestelde vragen over Ripple-65B
Is Ripple-65B open source?
De gewichten zijn open onder Apache 2.0, ook voor commercieel gebruik. De trainingsdata en de trainingscode zijn niet vrijgegeven.
Wat betekent dense bij een taalmodel?
Een dense model gebruikt al zijn parameters voor elk token. Een mixture-of-experts kiest per token een paar deelnetwerken en laat de rest stil. Dense vraagt vaak minder geheugen, MoE minder rekenwerk per token.
Kan ik Ripple-65B op mijn eigen computer draaien?
Ja, met voldoende geheugen. De NVFP4-versie past op een Nvidia DGX Spark, en er zijn community-versies voor Macs met veel geheugen. Reken wel op lagere snelheden dan bij een MoE, en op extra werk omdat gangbare tools het model nog niet ondersteunen.
Is Ripple hetzelfde als Recursive Flint?
Nee. Ricursive Intelligence van Goldie en Mirhoseini bouwt AI voor chipontwerp. Recursive van Richard Socher is een ander bedrijf dat Flint maakte.
Spreekt Ripple Nederlands?
Dat is niet gemeten. De trainingsdata is volgens de model card vooral Engels en code, dus test het zelf voor Nederlandse teksten. Voor code en agenttaken maakt de taal minder uit.