Perplexity lanceerde op 16 november Perplexity Frontier Research, een onderzoeksafdeling met één doel: een AI bouwen die zelf onderzoek doet. Zo’n systeem moet vragen stellen, hypotheses bedenken, experimenten ontwerpen en zijn conclusies bijsturen als de resultaten tegenvallen. Perplexity zet er meer dan 10.000 GPU’s achter en belooft papers, modellen, data en code openbaar te maken. Een werkend systeem is er nog niet. Wel een agenda die toont waar het bedrijf naartoe wil, en een eerlijke erkenning van het moeilijkste stuk: meten of een AI iets begrijpt in plaats van het alleen te voorspellen.
Wat Perplexity precies aankondigde
De aankondiging kwam als blogpost van Perplexity Research en als post op X. Dit is wat er vastligt:
- Het doel is volgens de blogpost “an automatic research scientist”: een AI-systeem dat op eigen houtje onderzoek doet.
- Rekenkracht. Het onderzoek krijgt meer dan 10.000 GPU’s. CEO Aravind Srinivas schreef op X dat het om minstens 10.000 GPU’s gaat, vooral voor multi-agent orchestration en continual learning, zo citeert FourWeekMBA.
- Open werken. Het team wil geregeld papers, blogposts, data, modellen en code vrijgeven, en test zijn resultaten in de producten van Perplexity.
- Leiding. Op de onderzoekssite staat Andrew Gordon Wilson als research lead. Wilson is hoogleraar machine learning aan NYU, werkt rond generalisatie en Bayesian deep learning en won met collega’s een best paper award op ICML 2022. Hij houdt zijn onderzoeksgroep aan NYU aan.
- Werving. Perplexity zoekt onderzoekers en engineers in San Francisco, Palo Alto, New York en Londen. Wie wil solliciteren, krijgt 5 december als prioritaire deadline.
Wat ontbreekt, zijn resultaten, een tijdlijn en details over de GPU’s zelf: welk type, hoe lang en met welke verbindingen. AlphaSignal wijst daar terecht op. Frontier Research is vandaag dus een onderzoeksprogramma en geen product dat je kan testen.
Zo moet een AI-onderzoeker volgens Perplexity werken
Perplexity beschrijft onderzoek als een lus. Je stelt de juiste vraag, vormt een hypothese, ontwerpt een experiment, analyseert de resultaten, gaat om met onzekerheid en stuurt je overtuiging bij. Daarna begint het opnieuw, met een betere vraag. Het verschil met een gewone AI-voorspelling zit in wat eruit komt. Een voorspellend model geeft een antwoord in een smal domein en zegt niet waarom. Perplexity wil nieuwe kennis die mensen kunnen lezen, begrijpen en controleren.
Dat is een stap verder dan Deep Research, dat Perplexity in februari 2025 lanceerde. Deep Research zoekt en vat samen wat al geschreven is. Een AI-onderzoeker moet voorbij de bronnen gaan en iets uittesten wat nog niemand wist.
De zes onderzoekspijlers in gewone taal
Perplexity verdeelt het werk over zes onderzoeksgebieden. Ze klinken technisch, maar elk ervan beantwoordt een concrete vraag. Bij een paar zie je in de huidige producten al een voorloper.
| Pijler | Wat Perplexity wil | Waar je het al ziet |
|---|---|---|
| Multi-agent orchestration | Agents verdelen het werk. De ene doorzoekt duizenden bronnen, een andere test een hypothese, een derde bekritiseert het experiment. Een klein model vraagt een groter model om hulp als dat de kost waard is. | Hybrid Compute verdeelt nu al taken tussen je Mac en de cloud. |
| Pre-training | Architecturen en trainingsmethodes die meer kwaliteit halen uit elk GPU-uur, en de vraag of zelf gemaakte trainingsdata breder leert dan echte data. | Nieuw terrein. Perplexity trainde tot nu vooral bestaande open modellen bij. |
| Continual learning | Modellen die na hun lancering blijven leren en kennis meenemen tussen sessies, zonder veel te vergeten en zonder privégegevens te lekken. | Teammates werken al weken aan één project en onthouden wat ze deden. |
| Reinforcement learning | Modellen die hypotheses voorstellen, ze testen en leren van de uitkomst. Waar het kan, wordt de beloning automatisch gecontroleerd. Elders scoort een rubriek. | Nog niet zichtbaar als product. |
| Systems | Infrastructuur voor training, inferentie en agents die uren of dagen draaien, veilig afgeschermd. | SPACE, de sandbox achter Perplexity Computer, is sinds oktober open source. |
| Evaluations | Tests die redeneren en ontdekken meten, en niet belonen wat een model uit zijn trainingsdata onthield. | Perplexity noemt dit zelf de kern en nog onopgelost. |
De beschrijvingen komen uit de onderzoekssite en de samenvattingen van Superpower Daily en AlphaSignal. Op de site staat bij orchestration ook de ambitie om voor elk budget dat je wil uitgeven het beste resultaat te leveren.
Het moeilijkste deel is meten of een AI iets begrijpt
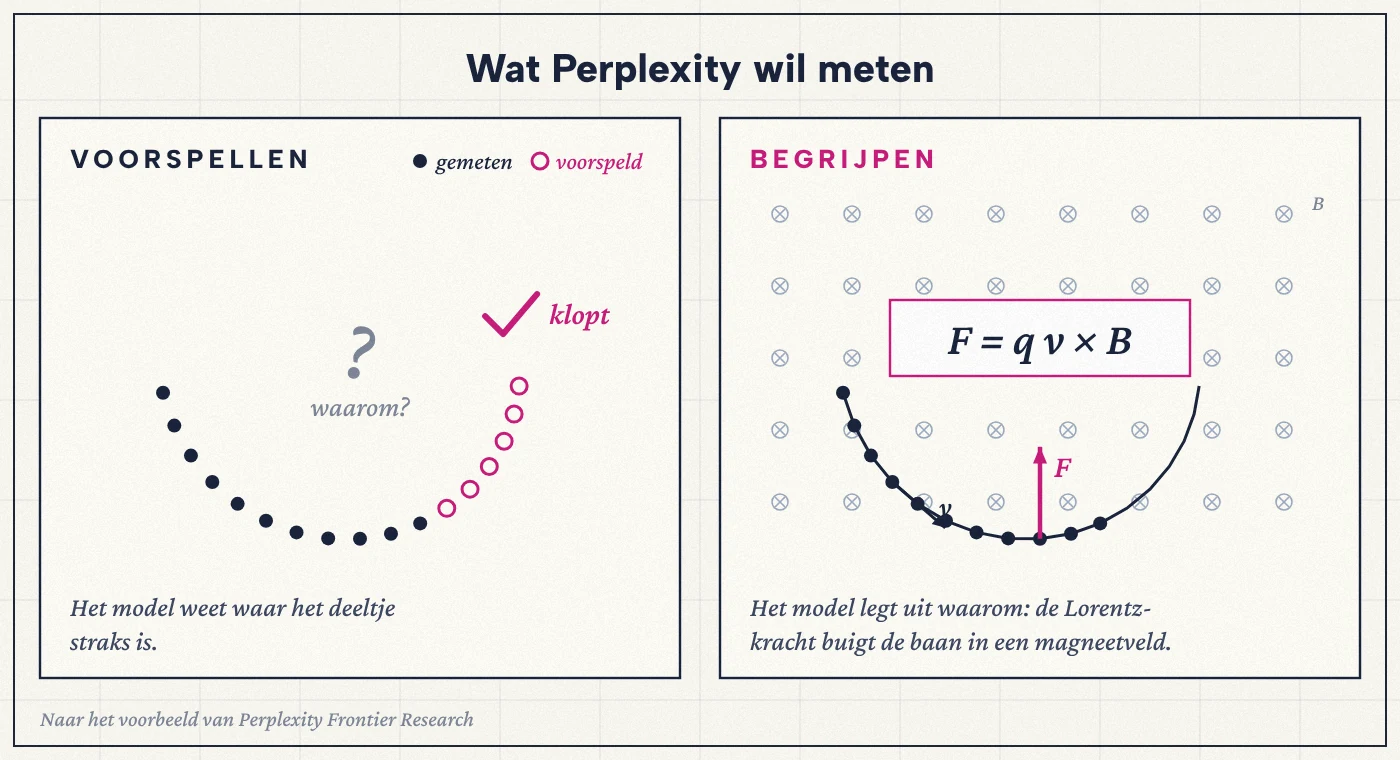
Perplexity geeft zelf een voorbeeld dat het probleem in één beeld vangt. Een model kan perfect voorspellen waar een deeltje straks is, zonder de vergelijking te kennen die verklaart waarom het die baan volgt. Voor een voorspelling volstaat dat. Voor wetenschap niet. Het lab wil daarom tests die begrip scheiden van voorspellend succes en redeneren van onthouden.
Hoe moeilijk eerlijk meten is, toonde Perplexity onlangs zelf. In september liet het negen modellen proberen uit SPACE te breken. Geen enkele van de 108 pogingen raakte uit de virtuele machine. In een vervolgstudie van 11 november bleek dat de klassieke capture-the-flag-opdracht de agents de verkeerde kant op stuurde. Volgens de analyse besteedden 9 van de 12 modellen hooguit 4 procent van hun moeite aan de grens die getest werd. Die nul op het scorebord zei dus minder dan hij leek. Voor een AI-onderzoeker geldt hetzelfde. Een test meet wat hij vraagt, en dat is niet altijd wat je wil weten.
Ook bij bestaande AI-wetenschappers zie je die kloof. Bij Kosmos van FutureHouse vonden onafhankelijke wetenschappers 79,4 procent van de uitspraken in de rapporten juist. Een kritische evaluatie van The AI Scientist van Sakana zag dat 5 van de 12 voorgestelde experimenten mislukten door codeerfouten en dat bekende ideeën als nieuw werden voorgesteld.
Perplexity is niet de enige die een AI-onderzoeker wil
| Wie | Wat | Stand in november 2026 |
|---|---|---|
| OpenAI | Een automated research intern, op weg naar een volledig automatische AI-onderzoeker | Het intern-niveau is volgens OpenAI zelf gehaald in september. De onderzoeker staat gepland tegen maart 2028. |
| Google DeepMind | AI co-scientist, die hypotheses genereert en bekritiseert | Werkt vooral als partner van onderzoekers, die de experimenten zelf uitvoeren. |
| Sakana AI | The AI Scientist, die van idee tot volledige paper gaat | Een paper in Nature in maart 2026, maar ook vragen over robuustheid. |
| FutureHouse | Kosmos, voor langere onderzoekscycli op data | Domeinexperten keurden 79,4 procent van de uitspraken goed. |
| Perplexity | Frontier Research | Een agenda met 10.000+ GPU’s. Nog geen systeem. |
Het verschil met OpenAI zit vooral in het doel. OpenAI wil in de eerste plaats AI-onderzoek automatiseren: modellen die betere modellen bouwen. Perplexity spreekt over onderzoek in het algemeen, legt de nadruk op kennis die mensen kunnen begrijpen en belooft open publicatie. Of dat verschil standhoudt, zie je pas aan wat ze uitbrengen. Wie wil zien hoe ver zelfbouwende AI vandaag al gaat, leest ons stuk over Flint van Recursive, een codeermodel dat grotendeels door een onderzoeks-AI gebouwd werd.
Waarom Perplexity dit nu doet
Perplexity werd groot door de modellen van anderen te verpakken in een sterke zoekervaring. Op Hacker News stond begin november nog de reactie dat Perplexity irrelevant geworden is, zoals Sam Altman ooit voorspelde voor elke startup die rond GPT bouwt. Met Frontier Research wil Perplexity zelf aan de grens van het onderzoek staan, en het heeft er nu ook het geld voor. Srinivas zei op 16 november bij Semafor dat Perplexity een omzetritme van 1 miljard dollar per jaar haalde.
De eerste open bouwstenen liggen al klaar. In oktober gaf Perplexity SPACE vrij als open source. Op 12 november volgde Decider v1.3, een beslismodel op basis van Qwen3.8-27B onder de Apache 2.0-licentie. Dat is veel kleiner dan een AI-onderzoeker, maar het toont dat de belofte van open werken meer is dan een slogan.
Wat je ervan merkt en waar je op let
- Vandaag valt er niets te testen. Er is geen AI-onderzoeker om uit te proberen. Wat het lab vindt, moet volgens Perplexity in zijn producten belanden. Hou dus vooral Computer en Teammates in het oog.
- Let op de eerste evaluaties. De belofte staat of valt met benchmarks die buitenstaanders kunnen nadoen. Een score zonder open testset en zonder code zegt weinig.
- Lees de licentie. Open gewichten zijn niet automatisch open source. Kijk bij elke release naar licentie, modelkaart en wat er over de trainingsdata gezegd wordt. Voor Decider moet je bijvoorbeeld eerst toegang aanvragen op Hugging Face.
- Werk je in onderzoek? Perplexity werft ook in Londen, de dichtste vestiging voor wie vanuit België werkt. De prioritaire deadline is 5 december.
Veelgestelde vragen
Wat is Perplexity Frontier Research?
Een onderzoeksinitiatief van Perplexity, gelanceerd op 16 november 2026, dat een AI wil bouwen die zelf onderzoek doet. Het werkt op zes gebieden, van multi-agent orchestration tot evaluaties, met meer dan 10.000 GPU’s.
Kan ik de AI-onderzoeker van Perplexity al gebruiken?
Nee. Er is nog geen systeem en ook geen datum. Perplexity belooft wel dat papers, modellen, data en code openbaar komen en dat de resultaten in zijn producten terechtkomen.
Wie leidt Perplexity Frontier Research?
Andrew Gordon Wilson, hoogleraar machine learning aan NYU. Hij staat op de onderzoekssite als research lead en houdt zijn onderzoeksgroep aan NYU aan.
Waarin verschilt dit van Deep Research?
Deep Research zoekt en vat samen wat al bestaat. Een AI-onderzoeker moet hypotheses bedenken, ze testen en nieuwe kennis opleveren die nog in geen enkele bron staat.
De kaart is nog leeg
Perplexity bouwde zijn naam op bronnen: elk antwoord met voetnoten naar wat al ergens geschreven staat. Een AI-onderzoeker moet net werken waar geen bron meer is. Daar helpt een citatie niet, alleen een experiment dat iemand anders kan herhalen. De echte maatstaf voor Frontier Research is daarom niet het aantal GPU’s. Het is de vraag of de eerste open evaluatie zo gebouwd is dat een concurrent ze kan gebruiken om Perplexity tegen te spreken.