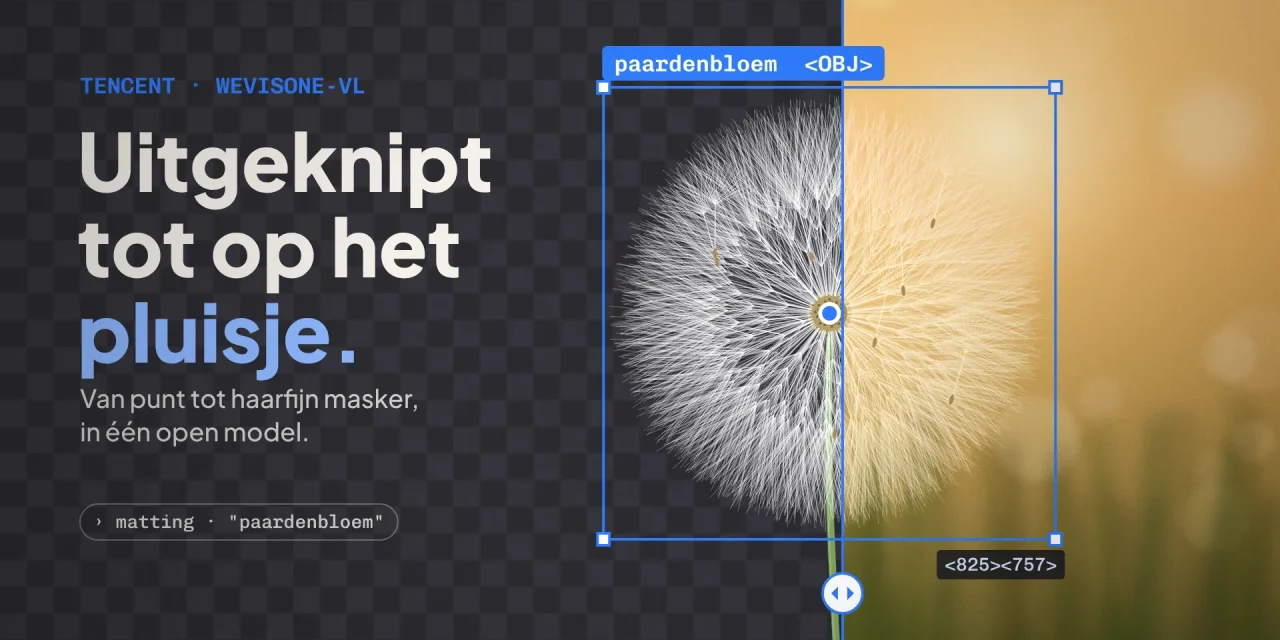
WeVisOne-VL is een open beeldmodel van Tencent dat objecten vindt, telt, aanwijst, tekst leest en uitknipt, tot op de haarlok nauwkeurig. Het WeChat Vision Team zette het op 22 oktober 2026 online in twee maten, 2B en 4B, onder de Apache 2.0-licentie. Wat het opvallend maakt: één klein model doet wat vandaag een keten van drie of vier tools doet, en het antwoordt gewoon None als je vraagt naar iets dat niet op de foto staat.
Waar Tencent begin november met Hy4 Preview een reus van 770 miljard parameters uitbracht, is WeVisOne-VL het omgekeerde: klein genoeg voor één grafische kaart en gemaakt voor één taak, kijken. In dit artikel lees je wat het model doet, hoe het van een punt tot een haarfijn alfamasker gaat, wat de cijfers wel en niet bewijzen en hoe je het zelf probeert.
Wat WeVisOne-VL doet
Je geeft het model een foto, een taak en een korte vraag. Het antwoord komt terug als gestructureerde tekst met coördinaten, en bij segmentatie en matting ook als masker. Dit zijn de taken die het ondersteunt:
| Taak | Wat je vraagt | Wat je terugkrijgt |
|---|---|---|
| Detectie | een lijst categorieën, zoals hond en fiets | kaders rond elk exemplaar |
| Verwijzen | een omschrijving, zoals de vrouw met de gele jas | een kader, of None |
| Aanwijzen | een categorie of omschrijving | punten |
| Tellen | een categorie of omschrijving | kaders of punten met het aantal |
| OCR | niets, of de tekst die je zoekt | tekst met kaders |
| Segmentatie | een categorie of omschrijving | kaders en maskers |
| Matting | een categorie of omschrijving | kaders en alfamaskers |
Dat laatste is het bijzondere stuk. Een gewoon masker zegt per pixel ja of nee. Een alfamasker geeft elke pixel een graad van doorzichtigheid, zodat haar, pluis, rook en glas met hun zachte rand mee uitgeknipt worden. Dat is wat je nodig hebt voor een productfoto op een witte achtergrond of een portret in een nieuw decor.
Het model is gebouwd op Qwen3-VL van Alibaba. Ondanks de naam telt de grote versie volgens de metadata op Hugging Face zo’n 4,8 miljard parameters.
Hoe één taalmodel van een punt tot een haarlok gaat
WeVisOne-VL schrijft plaatsen in een beeld als woorden. Het beeld wordt een raster van 0 tot 1000 in beide richtingen, en elk getal is een eigen token, van <0> tot <1000>. Een punt kost twee tokens, een kader vier. Zo voorspelt het taalmodel coördinaten op dezelfde manier als het een zin voorspelt.
Na elk kader schrijft het model een speciaal token <OBJ>. De interne toestand van dat token, het voorspelde kader en beeldkenmerken uit vier lagen van de eigen beeldencoder gaan naar een kleine pixeldecoder van 9,6 miljoen parameters. Die tekent het masker of alfamasker op volle resolutie, van grof naar fijn in drie stappen. Dat staat beschreven op de projectpagina en in het technische rapport.
Het verschil met de gangbare aanpak zit in wat er wegvalt. Wie vandaag een object wil uitknippen op basis van een omschrijving, koppelt vaak een detector aan een segmentatiemodel zoals SAM van Meta en daarna nog een matting-model. Hier beslist het taalmodel wat en waar, en tekent de kleine decoder de rand. Er is geen SAM nodig.
Waarom None het nuttigste antwoord is
Beeldmodellen hebben een vervelende gewoonte. Vraag naar de rode paraplu op een foto zonder paraplu, en veel modellen tekenen toch ergens een kader. WeVisOne-VL is getraind om dan None terug te geven. Tencent voegde na de gewone training een fase met reinforcement learning toe op 178.000 moeilijke voorbeelden, met scherpere kaders en minder verzonnen objecten als doel.
Op de test WeRef-Bench weigert het 4B-model in 96,4 procent van de gevallen terecht, tegenover 73,0 procent voor het beste vergelijkingsmodel. Op een andere test, RefCOCOg-Rej, zakt dat naar 67,4 procent. In dat scenario vindt het model dus nog altijd in ongeveer een op de drie gevallen iets wat er niet is.
Voor wie beeldherkenning automatiseert, is dat het belangrijkste cijfer. Een verzonnen kader in een telling van winkelrekken, een controle van een productielijn of een robot die een voorwerp moet aanwijzen en vastpakken, kost meer dan geen antwoord. Je pipeline moet None dus netjes afhandelen, en een steekproef met lege beelden hoort in je eigen test.
Wat de cijfers zeggen, en wat niet
Tencent meldt de beste score op meer dan dertig benchmarks. Dit zijn de belangrijkste, voor het 4B-model naast het beste andere model in dezelfde tabel:
| Test | Wat het meet | Beste ander model | WeVisOne-VL-4B |
|---|---|---|---|
| LVIS | detectie van veel categorieën | 50,7 | 55,3 |
| Dense200 | detectie in drukke beelden | 58,7 | 71,3 |
| RefCOCOg | object vinden uit een omschrijving | 77,6 | 81,8 |
| PixMo-Count | tellen, in procent juist | 82,8 | 89,6 |
| TotalText | tekst vinden en lezen | 43,3 | 52,0 |
| ReasonSeg | segmenteren na een redenering | 65,0 | 71,2 |
| P3M-500-NP | matting, fout, lager is beter | 15,4 | 7,3 |
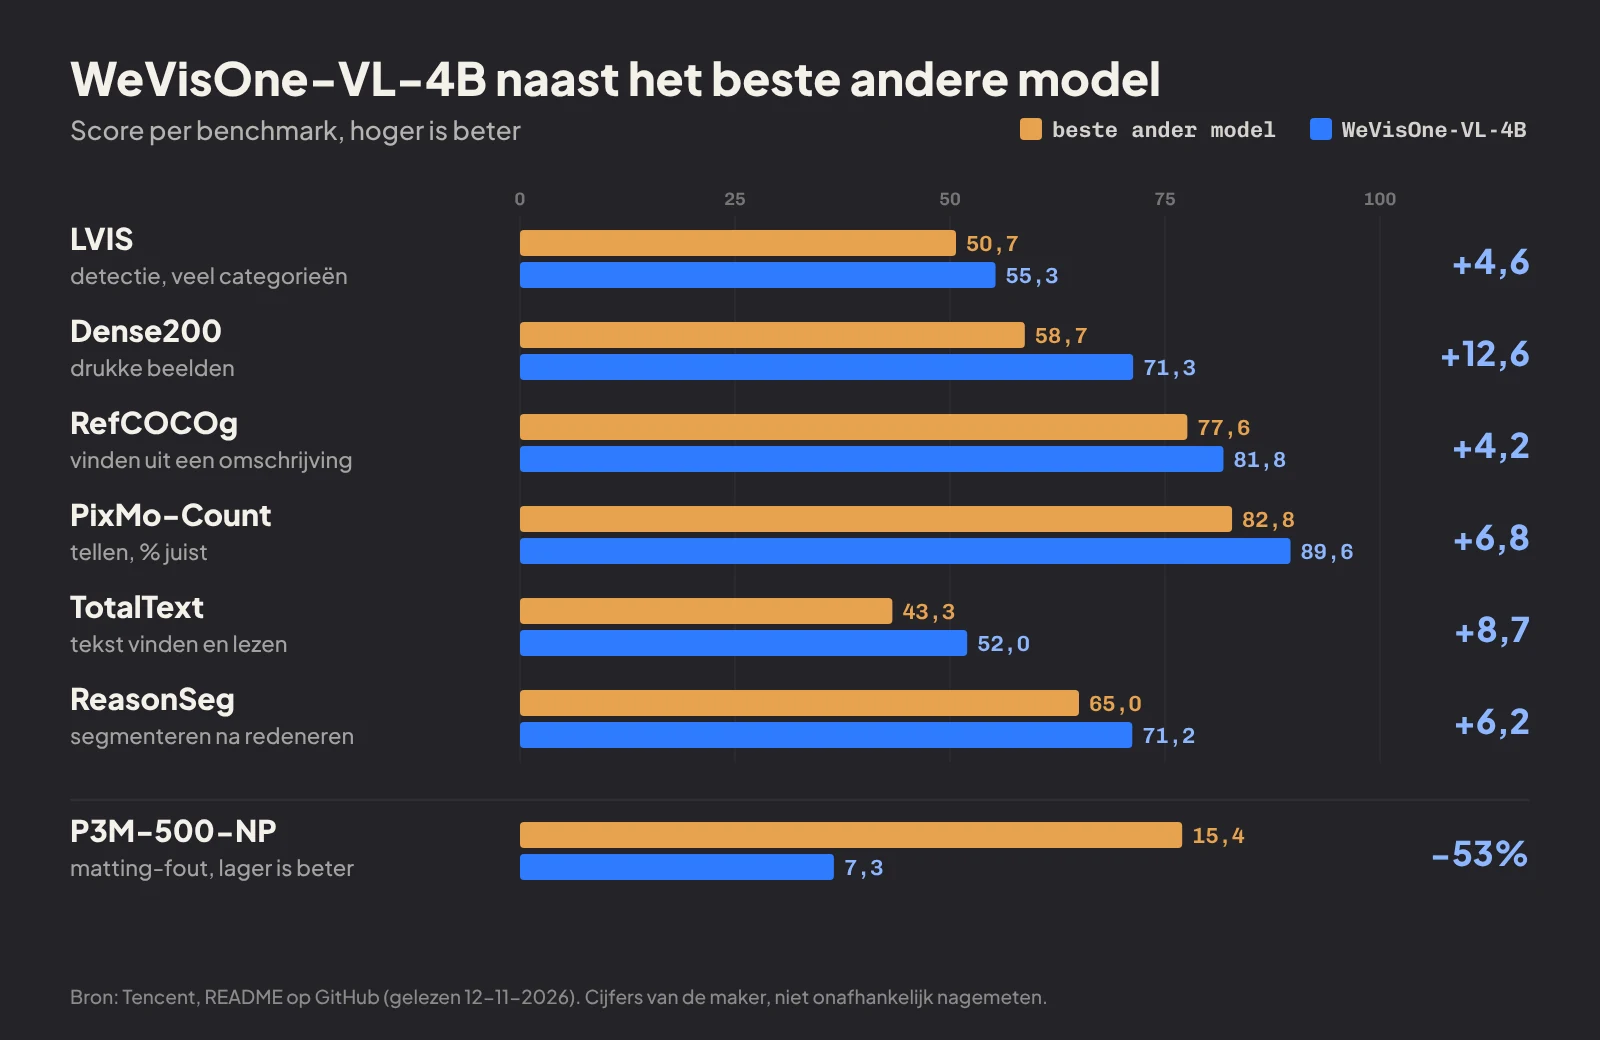
Die cijfers zijn sterk, maar lees ze met vier kanttekeningen:
- Alles komt van Tencent zelf. Op 12 november 2026 vond ik geen onafhankelijke test of reproductie.
- De vergelijking gaat tegen kleine modellen. Volgens de tabellen op GitHub zijn dat onder meer LocateAnything-3B, Rex-Omni-3B, Qwen3-VL-8B, Qwen3.5-9B, GroundingDINO en voor OCR PP-OCRv5. Grote gesloten modellen zoals Gemini of GPT staan er niet in.
- De F1-scores zijn een eigen maat. Ze zijn gemiddeld over overlapdrempels van 0,5 tot 0,95 en zijn dus geen klassieke average precision. Vergelijk ze niet zomaar met cijfers uit andere papers.
- Groter is niet altijd beter. Bij box matting op P3M scoort het 2B-model een fout van 6,6, beter dan de 7,3 van het 4B-model.
De sprong op Dense200 en op VisDrone, dronebeelden met veel kleine objecten waar het 4B-model 44,7 haalt, is voor de praktijk het interessantst. Drukke scènes zijn precies waar algemene beeldmodellen vandaag het vaakst objecten missen of dubbel tellen.
Hoe Tencent het model trainde
De trainingsdata komen uit een eigen data-engine die volgens Tencent meer dan 100 miljoen beelden annoteerde. Een kennisgraaf van categorieën en omschrijvingen bepaalt wat er gezocht wordt. Gespecialiseerde detectiemodellen stellen plaatsen voor, een vision-language model controleert ze, SAM2 breidt goedgekeurde kaders uit tot maskers en een eigen annotator, Mask2Alpha, maakt er alfamaskers van. Fouten van het model gaan terug in de volgende ronde.
Daarna volgden drie fases supervised fine-tuning met 90,2 miljoen, 40,5 miljoen en 41,8 miljoen voorbeelden, en de fase met reinforcement learning. Mask2Alpha is apart vrijgegeven, wat interessant is voor wie zelf matting-data wil maken.
WeVisOne-VL zelf proberen
Een betaalde API is er niet. Je probeert het model in de demo’s op Hugging Face of je draait het zelf. De code en de installatie staan op GitHub:
git clone https://github.com/Tencent/WeVisOne-VL.git && cd WeVisOne-VL
conda create -n wevisone-vl python=3.10 -y && conda activate wevisone-vl
pip install -r requirements.txt && pip install -v -e .
Daarna laad je het model in Python en vraag je bijvoorbeeld task="matting", query="person". Het pakket werkt met Transformers of vLLM en draait op een Nvidia-GPU, op een npu of trager op de cpu.
Drie dingen om te weten voor je begint:
- Geheugen. In bfloat16 nemen alleen de gewichten van het 4B-model zo’n 9,7 GB in, die van het 2B-model ongeveer 4,9 GB, volgens een schatting van AiCybr. Grote beelden en maskers vragen meer. Een kaart met 12 GB of meer geeft je ademruimte voor 4B; het 2B-model past op kleinere kaarten, net als andere kleine modellen die lokaal draaien.
- Zonder pixeldecoder geen maskers. Laad je het model gewoon via Transformers of serveer je het met vLLM of SGLang, dan krijg je kaders en tekst. Voor maskers en alfamaskers heb je het pakket van Tencent nodig, met het bestand
mask_decoder.pt. - Fine-tunen kan nog niet. De code daarvoor staat op 12 november 2026 nog op de takenlijst van het project.
Waar het model stopt
Tencent is in de model card duidelijk over de grenzen:
- Het werkt met één beeld per vraag. Video weigert de pixeldecoder.
- Het redeneert niet hardop voor het antwoordt. Vage opdrachten uit de praktijk zijn moeilijker dan de nette vragen uit benchmarks, en twee bijna gelijke formuleringen kunnen een ander masker opleveren.
- Fijne randen hangen af van resolutie, overlapping en doorzichtige materialen.
- De auteurs noemen zelf een afweging: wat het model wint aan precies kijken, verliest het deels aan algemene vaardigheden tegenover het basismodel.
- Het is bedoeld voor onderzoek en niet om personen te identificeren of zelfstandig zware beslissingen te nemen. In Europa valt herkenning van personen bovendien onder de strenge regels van de AI Act.
Veelgestelde vragen
Mag ik WeVisOne-VL commercieel gebruiken?
De code en de modelpagina’s vallen onder Apache 2.0, een licentie die commercieel gebruik toelaat. Onderdelen van derden behouden hun eigen licentie, dus controleer die voor je het in een product stopt.
Wat is het verschil tussen de 2B- en de 4B-versie?
Het 4B-model scoort op de meeste tests hoger, vooral bij drukke beelden en OCR. Het 2B-model is lichter en doet het bij sommige matting-tests zelfs beter.
Heb ik SAM nodig om maskers te maken?
Nee. De eigen pixeldecoder van 9,6 miljoen parameters tekent maskers en alfamaskers. SAM2 werd alleen gebruikt om trainingsdata te maken.
Kan WeVisOne-VL video verwerken?
Nee. Het model werkt met één beeld per vraag. Voor video moet je zelf frames aanleveren.
Een schaar in plaats van een gereedschapskist
WeVisOne-VL is stil gelanceerd, zonder persbericht en zonder API, en de grote versie telde in de maand voor 12 november zo’n 16.600 downloads. Toch zit er een verschuiving in die verder gaat dan dit model. Pixelwerk wordt een deel van het antwoord van een taalmodel, en de vraag voor wie bouwt is niet langer welke detector je aan welk segmentatiemodel koppelt, maar hoe je je vraag formuleert en wat je doet als het antwoord None is. Wie vandaag productfoto’s laat uitknippen of documenten laat doorzoeken, kan met een middag testen op eigen beelden zien of een open model van 4B dat werk aankan. Benieuwd wat de rest van China bouwt? Bekijk ons overzicht van de 40 meest innovatieve AI-labs in China.