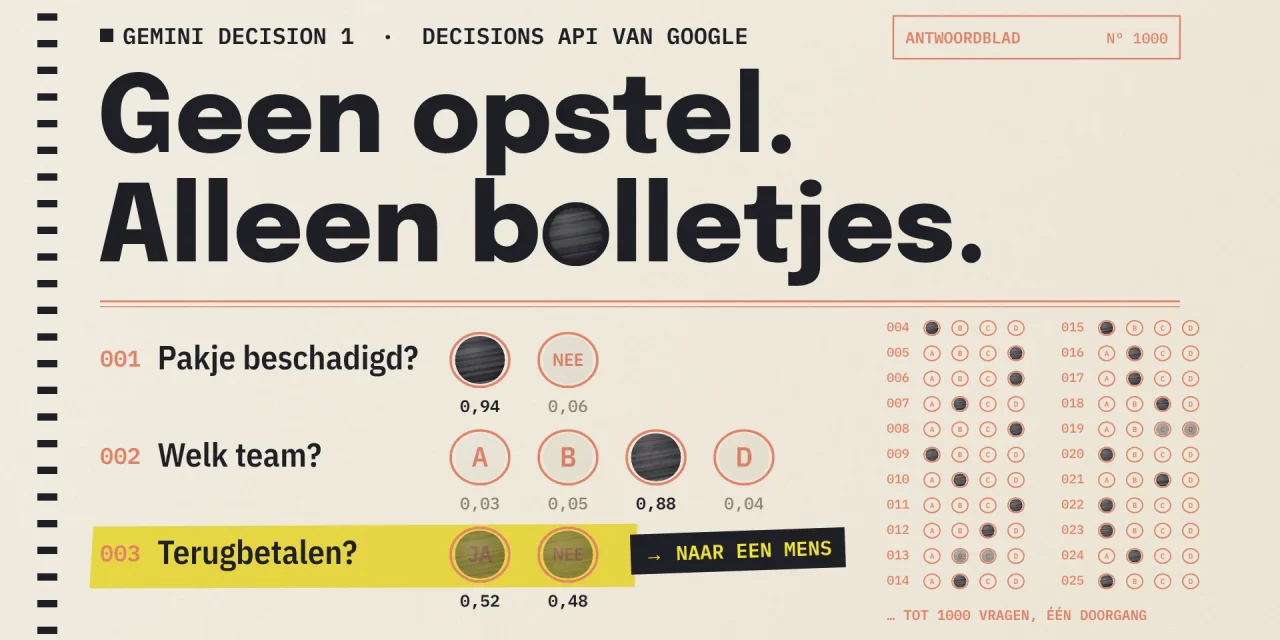
Google lanceerde op 11 november de Gemini Decisions API, met een nieuw model dat Gemini Decision 1 heet. Dat model schrijft geen antwoord. Je geeft het één input en tot 1.000 vragen met vaste antwoordopties, en je krijgt per vraag een kans en een betrouwbaarheidsscore terug. Volgens Google duurt dat 150 tot 250 milliseconden en kost het $0,10 per miljoen inputtokens, terwijl output niets kost. Het is gemaakt voor de vele kleine beslissingen in software en AI-agents: welk team, welk model, mag deze actie door, is dit pakje beschadigd.
Hieronder lees je hoe het werkt, wat het met een concreet rekenvoorbeeld kost, hoe het zich verhoudt tot de OpenAI Decisions API, Jev en Strands Decider, welke valkuilen in de documentatie staan en wat je in België nakijkt voor je het inzet.
Wat de Gemini Decisions API doet
Een gewoon taalmodel genereert zijn antwoord token per token. Gemini Decision 1 doet dat niet. Het bekijkt de input één keer en geeft elke toegelaten antwoordoptie een score, in één doorgang door het model. Daardoor maakt het voor de snelheid weinig uit of je één vraag stelt of honderd: volgens Google blijft de latency bijna gelijk van 1 tot 100 vragen per request, gemeten op inputs tot 16.000 tokens.
De input mag tekst, beeld, audio, video en pdf combineren, tot 256.000 tokens. Google geeft zelf het voorbeeld van een gespreksopname met de klantgegevens erbij, of een gescande schadeclaim met foto’s van de schade. Elke vraag hoort bij een van drie soorten:
- Ja of nee, in de API
noulgenoemd. Je krijgt de kans dat een voorwaarde klopt, bijvoorbeeld of een factuur een btw-nummer bevat. - Meerkeuze,
choice. Het model kiest uit 2 tot 255 opties en geeft per optie een kans, die samen op 1 uitkomen. - Score,
score. Het model plaatst de input op een geordende schaal, zoals dringendheid van 0 tot 4, en geeft een gewogen score plus een kans per niveau.
Bij elk antwoord hoort een betrouwbaarheid tussen 0 en 1. Die is bedoeld om te routeren: een duidelijke zaak handelt je software zelf af, een twijfelgeval gaat naar een collega of naar een groter model.
Waarvoor Google het zelf gebruikt
De interessantste voorbeelden komen van Google zelf. In Gemini Notebook stuurt het model elke vraag naar het juiste modelniveau en de juiste denkdiepte, wat voor alledaagse vragen tot 40 procent lagere latency zou opleveren. In Google Search dient het als veiligheidslaag voor MCP-tools, om misbruik en schadelijke inhoud te herkennen voor een tool iets uitvoert. In een experiment van Stitch verwerkt het spraak- en tikbewerkingen op een klikbaar wireframe, en een Labs-app kiest er een emoji-reactie mee uit meer dan 200 opties.
Voor een gewoon bedrijf liggen de toepassingen dichter bij de dagelijkse werking:
- inkomende mails en tickets naar het juiste team sturen, met een dringendheidsscore;
- een klantfoto naast de bestelnota leggen en vragen of het product beschadigd lijkt;
- leads uit een webformulier kwalificeren en het passende pakket voorstellen;
- een AI-agent laten controleren voor hij een riskante tool gebruikt, als vaste stap in de harness rond je agent.
Wat het niet doet: tekst schrijven, redeneren in stappen of een functie aanroepen. Het kiest alleen tussen opties die jij vooraf vastlegt.
Wat het kost, met een rekenvoorbeeld
De prijs is eenvoudig. Je betaalt $0,10 per miljoen inputtokens en niets voor output, want het model maakt geen tekst. De gedeelde input wordt één keer per request aangerekend, hoeveel vragen je er ook aan hangt. Elke vraag voegt alleen de tokens van haar eigen instructie en opties toe. Er zijn geen aparte kosten voor transcriptie van audio of OCR.
Een rekenvoorbeeld met eigen aannames: je klantendienst krijgt 10.000 mails van gemiddeld 1.500 tokens en je stelt per mail 12 vragen van gemiddeld 60 tokens, over team, taal, dringendheid, sentiment en opzegrisico. Dat is 2.220 tokens per mail en 22,2 miljoen tokens in totaal, of $2,22.
Stel je dezelfde 12 vragen elk apart aan Gemini 3.5 Flash-Lite, met telkens de mail erbij en een kort antwoord, dan betaal je volgens de prijslijst van Google ongeveer $62. Bundel je alle vragen in één Flash-Lite-call met een JSON-antwoord, dan zit je rond $10,40. Het verschil komt vooral van de outputtokens, die bij Flash-Lite $2,50 per miljoen kosten. Google zelf spreekt over bijna vijf keer goedkoper dan Flash-Lite op zijn eigen testreeks.
Twee dingen maken het duurder dan dit voorbeeld. Beeld, audio en video tellen als veel tokens, al kan je de resolutie van beeld en video lager zetten. En er is geen context caching en geen Batch API: stuur je dezelfde lange input twee keer, dan betaal je twee keer.
Hoe het zich verhoudt tot OpenAI, Jev en Strands Decider
Google is niet de eerste. TypeSafe lanceerde Jev op 15 september en haalde in oktober 870 miljoen dollar op. AWS volgde met het open model Strands Decider 2B, en OpenAI maakte zijn Decisions API op 22 oktober algemeen beschikbaar.
| Aanbod | Prijs per 1M inputtokens | Vragen per request | Input | Waar het draait |
|---|---|---|---|---|
| Gemini Decision 1 | $0,10, output gratis | tot 1.000 | tekst, beeld, audio, video, pdf tot 262.144 tokens | Gemini API en AI Studio, Google Cloud later |
| OpenAI Decisions API | $0,10, korting op gecachete input | tot 400 | tekst, JSON en beelden | OpenAI API, op GPT-6 Luna |
| Jev van TypeSafe | $0,042, output gratis | niet gepubliceerd | tekst tot 32.000 tokens | TypeSafe, op Cloudflare |
| Strands Decider 2B van AWS | je eigen rekenkracht | afhankelijk van je opstelling | tekst | open onder Apache 2.0, zelf te draaien |
Gemini Decision 1 springt eruit met de grootste input en audio en video. Jev is per token het goedkoopst, maar alleen voor tekst. OpenAI heeft caching, wat helpt als je dezelfde lange context vaak hergebruikt. Wie geen data naar een externe API wil sturen, kijkt naar Strands Decider. Google claimt de laagste kalibratiefout van de modellen die het testte, maar toont de cijfers alleen in grafieken, en onafhankelijke tests zijn er nog niet.
Vijf valkuilen die in de documentatie staan
De documentatie van de Decisions API is eerlijker dan de aankondiging. Deze vijf punten bepalen of je toepassing betrouwbaar wordt.
- Meerkeuze kiest altijd iets. De kansen van een
choice-vraag tellen altijd op tot 1, ook als geen enkele optie past. Een mail over iets heel anders krijgt dus toch een team. Voeg een optieanderstoe en kijk naar de betrouwbaarheid. - Ja of nee komt nooit boven 0,99. Een
noul-antwoord ligt tussen 0,01 en 0,99. Een regel die pas handelt boven 0,99, handelt dus nooit. - De input kan voor zichzelf pleiten. Google schrijft letterlijk dat tekst van gebruikers kan argumenteren voor zijn eigen classificatie. Een klant die in zijn mail zet dat dit een dringende terugbetaling is, kan de score beïnvloeden. Laat een mens of een tweede controle meekijken bij alles wat geld of rechten raakt.
- Het model ziet je sleutels niet. Het leest alleen de
instructionsvan een vraag en de beschrijving van de opties, niet de naam die jij de vraag gaf. Opties worden bovendien alfabetisch gesorteerd. Schrijf elke vraag dus volledig uit. - Een score is een gemiddelde. De
scoreis een gewogen gemiddelde van de niveaus. Kies niveaus met gelijke stappen ertussen, en neem het niveau met de hoogste kans als je één niveau nodig hebt.
Wat je in België nakijkt
De Gemini API en Google AI Studio zijn in België beschikbaar, dus je kan vandaag testen. Drie punten verdienen aandacht.
De gratis laag is voor testdata. Google mag inhoud uit de gratis laag gebruiken om zijn producten te verbeteren, uit de betaalde laag niet. Zet dus geen echte klantmails of schadefoto’s in de gratis laag.
Google Cloud komt later. Het model draait nu alleen via de Gemini Developer API, als v1beta. Wil je het via Vertex AI gebruiken, met de contracten en de keuze van regio die je daar hebt, dan wacht je op de versie voor Google Cloud. Google noemt die coming soon, zonder datum.
Beslissingen over mensen vallen onder de AI Act. Gebruik je zo’n model om sollicitanten te rangschikken of de kredietwaardigheid van personen in te schatten, dan is dat een hoog-risicotoepassing. De meeste verplichtingen daarvoor gelden vanaf december 2027, maar je ontwerp maak je nu. Een betrouwbaarheidsscore met een drempel en een menselijke wachtrij is een goed begin van menselijk toezicht, en het loggen van elke vraag, kans en drempel maakt je beslissingen achteraf controleerbaar. Analist Lian Jye Su van Omdia waarschuwt in InfoWorld dat een betrouwbaarheidsscore op zich nog niet bewijst dat een beslissing klopt, zeker als je data verschuift of iemand de input manipuleert.
Google zegt niet hoe goed Gemini Decision 1 Nederlands en Frans aankan. Ga ervan uit dat je dat zelf moet meten.
Zo test je het in een middag
- Maak een API-sleutel in Google AI Studio en probeer de playground van de Decisions API met een paar eigen voorbeelden.
- Verzamel 100 tot 200 echte gevallen, geanonimiseerd, en noteer per geval het juiste antwoord. Neem Nederlandse en Franse teksten mee als je klanten beide talen spreken.
- Schrijf je vragen volledig uit, met korte en duidelijk verschillende opties en altijd een optie anders.
- Stuur alle vragen per geval in één request en bewaar de kansen en betrouwbaarheid.
- Kies per vraag de drempel waarboven je automatisch handelt, op basis van hoeveel fouten je boven die drempel nog ziet. De documentatie raadt precies dat aan.
- Laat alles onder de drempel naar een mens gaan en meet na een maand opnieuw.
Veelgestelde vragen
Is Gemini Decision 1 gratis?
Er is een gratis laag in Google AI Studio om te prototypen. In productie betaal je $0,10 per miljoen inputtokens en niets voor output.
Kan Gemini Decision 1 ook tekst schrijven?
Nee. Het geeft alleen kansen en scores voor opties die je zelf vastlegt. Voor uitleg of een antwoord aan de klant heb je een ander model nodig.
Wat is het verschil met structured output van een gewoon model?
Met structured output schrijft een taalmodel een JSON-antwoord, token per token, en betaal je die outputtokens. Een decision model scoort de opties in één doorgang en geeft per optie een kans, wat sneller en goedkoper is en een drempel mogelijk maakt.
Kan ik het met mijn bestaande tools gebruiken?
Google rolt integraties uit met onder meer OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit en OpenCode, naast de eigen google-genai SDK’s vanaf versie 3.2.
Het saaie werk wordt meetbaar
De lage prijs trekt de aandacht, maar de grotere winst is dat een beslissing van AI een getal wordt dat je kan controleren. Een gegenereerd ja kan je moeilijk beoordelen. Een kans van 0,62 met een drempel van 0,8 kan je wel loggen, uitleggen en bijstellen. Dat werkt alleen als je die drempels op je eigen gelabelde gevallen afstelt, en daar helpt geen enkel model je bij.