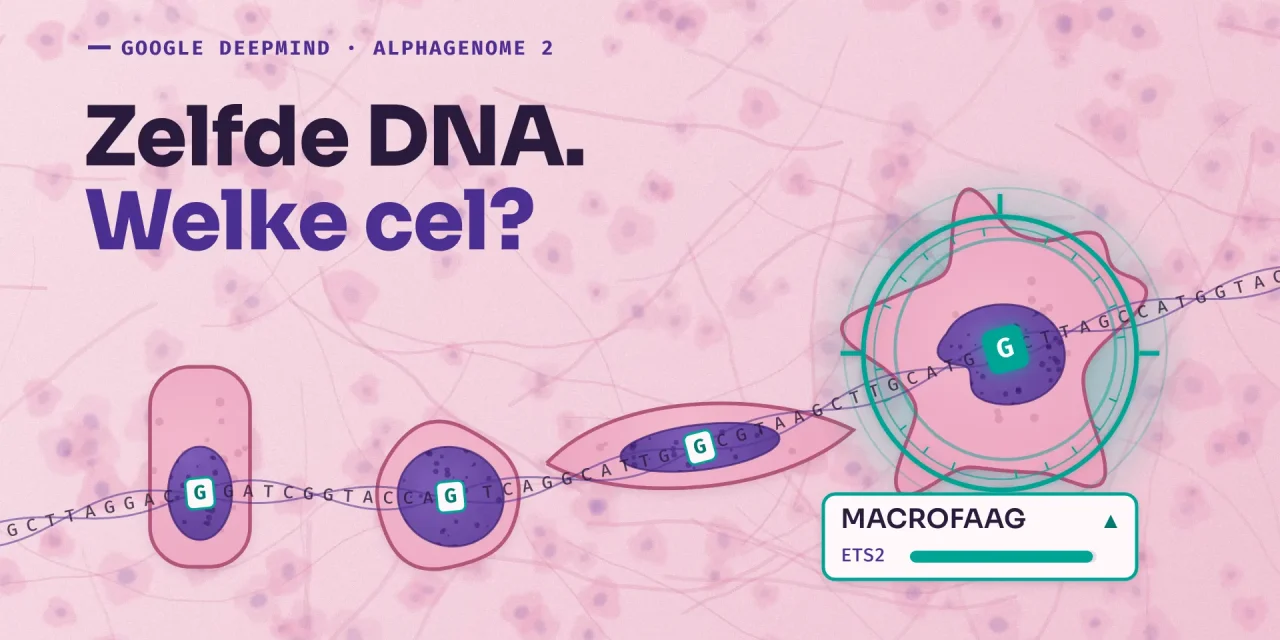
AlphaGenome 2 is het nieuwe DNA-model van Google DeepMind, aangekondigd op 11 november 2026. Het voorspelt wat een verandering in je DNA doet, en nu ook in welk celtype. Dat klinkt als een detail, maar het is de kern van het probleem: dezelfde letter in je genoom kan in een darmmacrofaag een gen opjagen en in een levercel niets doen. Hier lees je hoe het model dat aanpakt, wat de cijfers echt zeggen, wie het mag gebruiken en waar het nog tekortschiet.
Wat AlphaGenome 2 precies voorspelt
Je krijgt van elke ouder een genoom van zo’n drie miljard letters. Het overgrote deel codeert niet voor eiwitten, maar regelt wanneer, waar en hoe sterk genen aanstaan. De meeste varianten die genoomwijde studies aan ziektes koppelen, liggen in dat regelgebied. Daar zit ook de moeilijkheid: een statistische studie wijst vaak een hele reeks varianten aan die samen overerven, zonder te zeggen welke de schuldige is of in welk weefsel ze haar werk doet.
AlphaGenome 2 leest een stuk DNA van één miljoen letters en voorspelt wat er in een gekozen cel gebeurt: hoeveel RNA een gen aanmaakt, hoe het RNA gesplitst wordt, hoe open het chromatine ligt, welke histonmerken er zitten en, nieuw, hoe sterk het DNA gemethyleerd is. Verander je één letter, dan zie je het verschil tussen de gewone en de gewijzigde versie. Het model werkt voor mens en muis.
Waarom de cel het verschil maakt
De eerste AlphaGenome uit juni 2025 voorspelde duizenden experimenten tegelijk, over honderden weefsels en celtypes. Dat was handig, maar de capaciteit van het model raakte zo verdeeld over al die uitkomsten dat nauw verwante celtypes moeilijk uit elkaar te houden waren. Bij de publicatie in Nature in januari 2026 wezen experts daar ook op. Kristian Helin van het Institute of Cancer Research noemde cel-specifieke regulatie toen “an important challenge”.
AlphaGenome 2 draait dat om. Je kiest eerst een conditie: een weefsel, een celtype of een celtoestand, zoals een T-cel die net geactiveerd is door een vaccin. Het model rekent dan alleen voor die ene conditie, met alle capaciteit erop gericht. Wil je tien celtypes vergelijken, dan doe je tien voorspellingen.
Zo werkt de conditionering
Het technisch paper beschrijft een architectuur die sterk lijkt op die van de eerste versie: een U-Net met een transformer in het midden. Het verschil zit in de plek waar de conditie binnenkomt. Die stuurt elke laag bij, van de eerste encoderlagen tot de decoder. De onderzoekers testten ook varianten waarbij de conditie pas aan het einde binnenkwam. Dat leverde bijna niets op. Het model moet het DNA dus van bij het begin bekijken door de ogen van die specifieke cel.
Een conditie kan op twee manieren ontstaan. Je kiest er één uit een vaste lijst referentiecondities, of je laat het model je eigen single-cell data inlezen. Daarvoor heeft AlphaGenome 2 een cell encoder, getraind op meer dan 100 miljoen profielen van afzonderlijke cellen uit 68 weefsels. Die zet de genactiviteit van jouw cellen om in een compacte beschrijving van hun toestand, zonder dat het model opnieuw getraind moet worden. Volgens de documentatie kan je tot 256 cellen per oproep meegeven, als ruwe tellingen per gen. DeepMind schrijft dat een paar dozijn cellen al volstaat. Sarah Teichmann, medeoprichter van het Human Cell Atlas-consortium, wijst in de aankondiging net op dat punt: het model past zich aan nieuwe single-cell data aan zonder hertraining.
Een tweede nieuwigheid is imputatie. Meet je in een cel alleen genactiviteit, dan voorspelt AlphaGenome 2 ook hoe open het chromatine er zou liggen. Elke uitkomst krijgt in de API een label: gemeten tijdens de training, onderbouwd geïmputeerd of verkennend. Dat laatste label behandel je als hypothese.
Wat de cijfers echt zeggen
De kop van de aankondiging is dat AlphaGenome 2 bijna twee keer zoveel varianten vindt die genexpressie in cellen veranderen. Dat cijfer komt uit TenK10K, een grote single-cell-studie van bloedcellen met 28 soorten immuuncellen. Daar vond het model 30 procent van de vermoedelijk causale varianten bij een precisie van 90 procent, tegenover 16 procent voor AlphaGenome 1 dat extra op single-cell data was bijgetraind. Voor de richting van het effect, gaat het gen harder of zachter, steeg dat van 23 naar 43 procent.
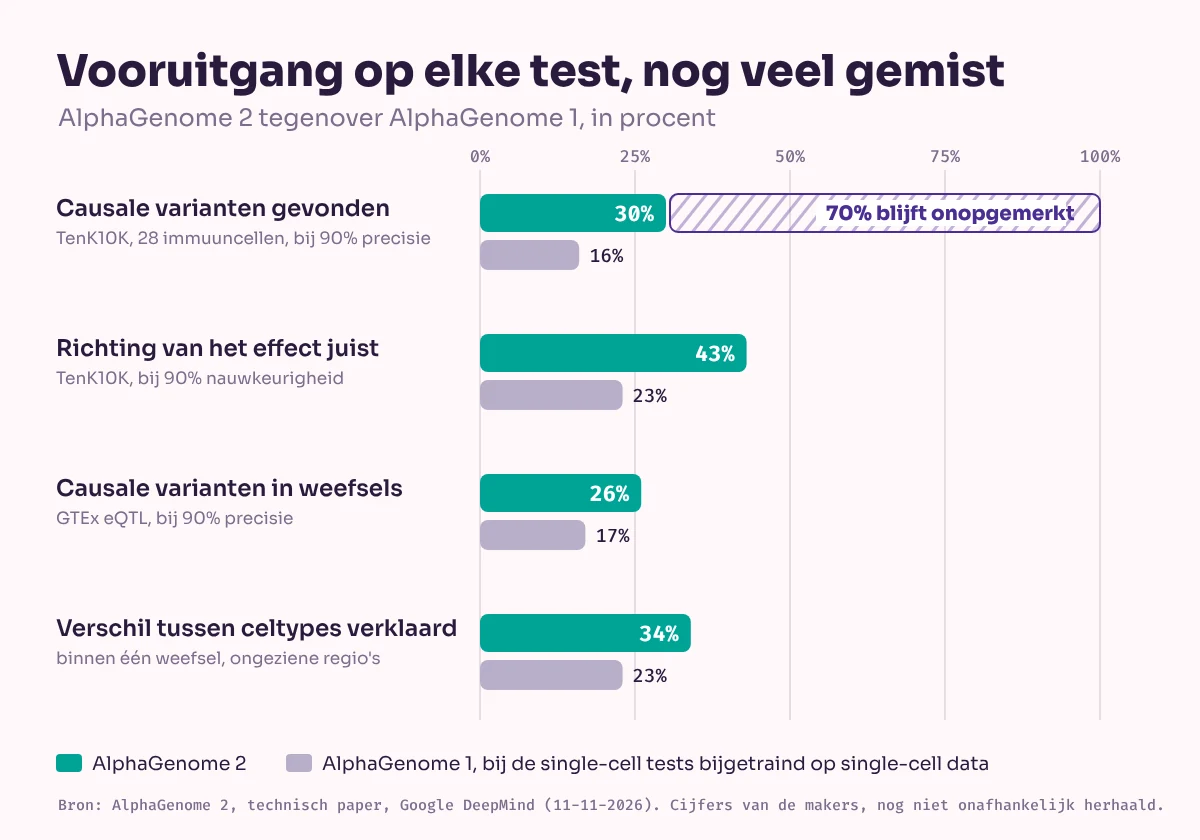
Lees die getallen goed. Recall bij 90 procent precisie betekent: van de varianten die het model aanwijst, klopt negen op tien, maar het wijst er maar een minderheid aan. Zeven op de tien causale varianten in deze test blijven onopgemerkt. Het paper zegt dat zelf ook. De sprong is groot, het probleem is niet opgelost.
Het paper bevat meer cijfers dan de blog. In de GTEx-weefseldata gaat de correlatie tussen voorspelde en gemeten expressie van 0,61 naar 0,71. Binnen een weefsel verklaart het model 34 procent van de verschillen tussen celtypes, tegenover 23 procent. Bij het koppelen van enhancers aan hun doelgen, gecontroleerd met CRISPR-experimenten, scoort het 0,78 AUPRC tegenover 0,73 voor de vorige versie en 0,61 voor Borzoi, een bekend concurrerend model. Allemaal cijfers van DeepMind zelf. Een onafhankelijke herhaling bestaat op de dag van de release nog niet.
Twee voorbeelden uit het paper
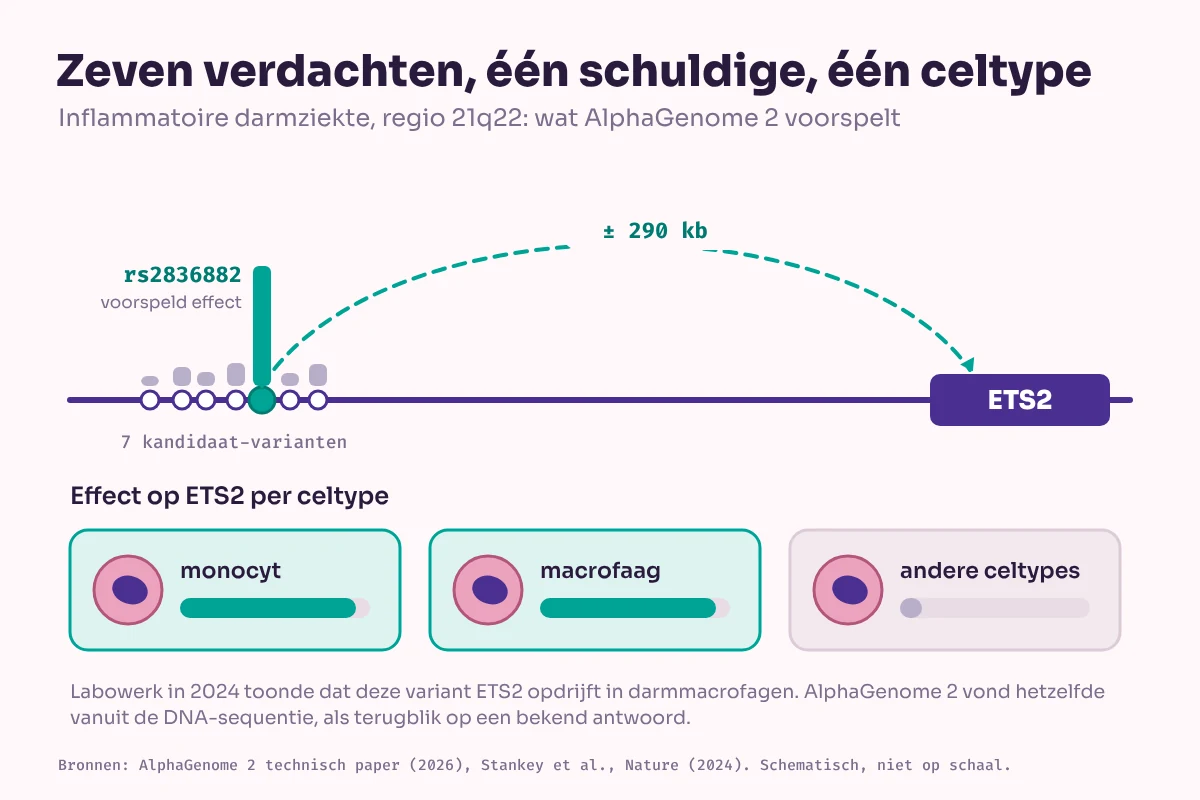
Het sterkste voorbeeld komt uit inflammatoire darmziekte. Een studie in Nature uit 2024 toonde met uitgebreid labowerk aan dat een variant ver van het gen ETS2 dat gen opdrijft in macrofagen van de darm, wat de ontsteking aanwakkert. AlphaGenome 2 kreeg de zeven varianten uit die regio te zien. Het gaf er maar één een groot effect, rs2836882, koppelde die aan ETS2 op ongeveer 290.000 letters afstand, en zag het effect alleen in monocyten en macrofagen. Andere cellen en genen bleven grotendeels ongemoeid. Het is wel een terugblik: het antwoord was al bekend.
Het tweede voorbeeld is vooruitkijkend. De onderzoekers gaven het model single-cell data uit een studie naar een mRNA-vaccin tegen COVID-19, data die het nooit gezien had. Het onderscheidde T-cellen die door het vaccin geactiveerd waren van rustende T-cellen, en voorspelde dat een variant die met ernstige COVID-19 samenhangt sterker doorweegt in de geactiveerde toestand. Dat is precies het soort vraag waar een model zonder celcontext op stukloopt.
Wie het mag gebruiken en wat je ermee mag
AlphaGenome 2 is vanaf vandaag gratis beschikbaar voor niet-commercieel onderzoek via de AlphaGenome API, met Colab-notebooks om te starten. Bedrijven krijgen toegang via een private preview. Een prijs is niet bekendgemaakt en de snelheid van de API hangt af van de drukte. De gewichten van het model komen niet vrij: wie de eerste versie lokaal wil draaien, vindt die wel op GitHub, voor niet-commercieel gebruik en met minstens een H100-gpu.
Voor wie met de API werkt, zijn er een paar praktische verschillen met versie 1:
- Elke oproep gaat over één conditie. Een vergelijking over weefsels heen bouw je zelf met een lus.
- Variantscores komen alleen nog als ruwe score. De gekalibreerde quantielscores van versie 1 zijn er niet meer.
- PRO-cap-voorspellingen zijn verdwenen. Voor activiteit rond het startpunt van genen gebruik je CAGE.
- AlphaGenome 1 blijft beschikbaar, onder meer om de resultaten uit het Nature-paper te reproduceren of alle weefsels in één keer te scoren.
De gebruiksvoorwaarden zijn streng. Volgens de FAQ zijn de uitkomsten alleen voor niet-commercieel onderzoek, mag je ze niet gebruiken om andere machinelearningmodellen te trainen, en zijn ze niet bedoeld voor klinische beslissingen. DeepMind herhaalt dat het model niet gevalideerd of goedgekeurd is voor diagnose.
Er komen ook AlphaGenome 2 Skills voor Antigravity, het agentplatform van Google. Een agent op basis van Gemini 4 zou het model dan zelf kunnen aanroepen tijdens een analyse. Dat past in een bredere beweging waarin gespecialiseerde wetenschapsmodellen en agents samen het onderzoekswerk opschuiven, zoals ook Discovery Loop nastreeft. Wetenschappers kunnen tot 30 november via een formulier een project indienen voor extra quota.
Waar AlphaGenome 2 nog tekortschiet
De auteurs zijn opvallend eerlijk over de grenzen:
- Het model vindt maar een minderheid van de causale varianten die statistische studies aanwijzen.
- Het onderschat effecten buiten open chromatine, via heel verre regelgebieden of via mechanismen die pas na de transcriptie spelen.
- Tijdelijke, gestimuleerde en zieke celtoestanden zitten weinig in de trainingsdata. Fijne subtypes van neuronen blijven moeilijk te onderscheiden.
- De beschrijving van een celtoestand komt uit observaties van cellen in rust. Ze vangt samenhang, geen oorzaak. Of het model voorspelt wat er gebeurt als je een gen uitschakelt, is nog niet getest.
- Elke conditie vraagt een aparte berekening. Een genoombrede atlas zoals de AlphaGenome Atlas van september, met voorspellingen voor alle 9 miljard mogelijke lettervervangingen, wordt zo veel duurder.
Daarbovenop komt de les van versie 1. Xianghua Li van King’s College London stelde toen dat AlphaGenome even goed presteerde als de beste bestaande tools, “but not better”. Bij versie 2 is de voorsprong op papier groter, maar ook hier testen de makers hun eigen model.
Veelgestelde vragen
Kan ik AlphaGenome 2 gebruiken voor mijn eigen DNA-test?
Nee. Het model is niet gemaakt of gevalideerd om een persoonlijk genoom te interpreteren en is uitdrukkelijk niet bedoeld voor diagnose. Medische vragen over je DNA horen bij een arts of een centrum voor menselijke erfelijkheid.
Wat kost AlphaGenome 2?
Voor niet-commercieel onderzoek is de API gratis. Commerciële toegang loopt via een private preview, zonder publieke prijs.
Wat is het verschil met AlphaFold?
AlphaFold voorspelt de vorm van eiwitten. AlphaGenome voorspelt hoe het DNA rond genen hun activiteit regelt. Ze vullen elkaar aan: de AVI-score van de AlphaGenome Atlas combineert al voorspellingen van AlphaGenome met die van AlphaMissense.
Hoeveel cellen heb ik nodig om met eigen data te werken?
De API aanvaardt tot 256 cellen per oproep. DeepMind zegt dat een paar dozijn cellen kan volstaan, maar waarschuwt dat data die sterk afwijkt van de trainingsdata minder goed gevat wordt.
Een model dat eerst vraagt welke cel je bedoelt
Het belangrijkste aan AlphaGenome 2 is misschien niet een benchmarkcijfer, maar de vraag die het je stelt voor het iets voorspelt: in welke cel? Biologen weten al lang dat het antwoord op “wat doet deze variant” afhangt van waar je kijkt. Een AI-model dat dat ingebakken heeft en je eigen cellen kan inlezen, verschuift het werk van gissen naar gericht testen. Zeven op de tien causale varianten mist het nog. Het labo blijft dus nodig, maar weet beter waar het moet beginnen. Wie in de zorg met AI bezig is, ziet dezelfde les als bij SymptomAI van Google: indrukwekkende cijfers op een vooraf gekozen test zijn een begin, geen bewijs in de praktijk.