Scribe v3 is het nieuwe spraak-naar-tekstmodel van ElevenLabs, en het komt met een broertje voor live gesprekken: Scribe v3 Live. Volgens ElevenLabs maakt Scribe v3 27 % minder woordfouten dan zijn voorganger en weet het beter wie wat zei, voor exact dezelfde prijs van 0,20 dollar per uur audio. Voor het Nederlands publiceert ElevenLabs geen eigen cijfer. Wel testte de Nederlandse energieleverancier Eneco het live model al op echte klantengesprekken. Hieronder lees je wat er nieuw is, hoe zwaar je de cijfers mag nemen, wat het kost, waar je audio naartoe gaat en hoe je zelf test of het jouw opnames aankan.
Wat zijn Scribe v3 en Scribe v3 Live
ElevenLabs lanceerde beide modellen op 10 november 2026. Ze vervangen Scribe v2 en Scribe v2 Realtime, die wel beschikbaar blijven.
- Scribe v3 is voor opgenomen audio: vergaderingen, interviews, podcasts, lessen, voicememo’s. Het herkent tot 32 sprekers, plakt tijdcodes op elk woord, labelt geluiden zoals gelach of applaus en kan opvulwoorden en valse starts weglaten. Je stuurt bestanden tot 5 GB en 15 uur.
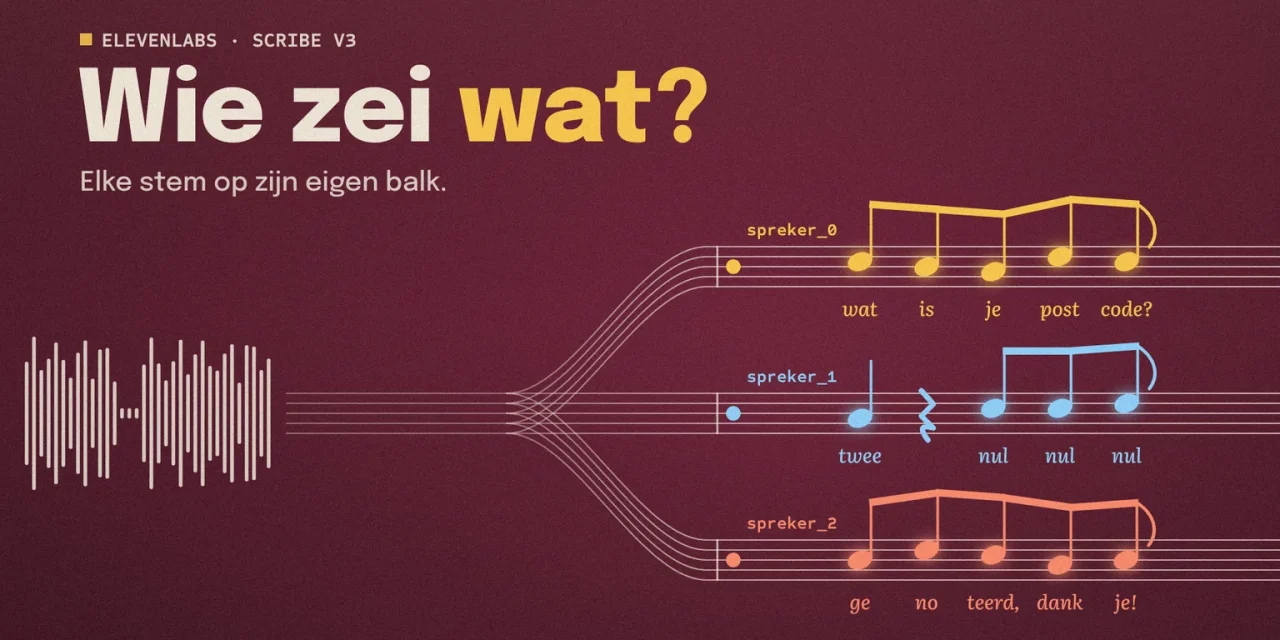
- Scribe v3 Live schrijft mee terwijl iemand praat, met een vertraging die geschikt is voor voice agents van ElevenLabs en live ondertiteling. Nieuw is dat het nu ook in realtime zegt wie er spreekt.
Beide modellen zijn meteen de standaard in de app van ElevenLabs en staan in de API. Wie al met Scribe v2 werkt, past alleen de model-id aan naar scribe_v3 of scribe_v3_live. De rest van de aanroep blijft werken, zegt de documentatie.
Hoeveel beter is Scribe v3, en wie mat dat
De grote cijfers komen van ElevenLabs zelf, uit de aankondiging en de documentatie:
- Op FLEURS, een testset van korte voorgelezen zinnen in 102 talen, zakt het woordfoutpercentage van Scribe v3 van 16,94 % naar 12,38 %. Dat is de 27 % minder fouten uit de titel. Het lijkt een hoog foutpercentage, maar ElevenLabs telt elke taal even zwaar mee, ook talen waar spraakherkenning nog zwak is.
- Bij het herkennen van sprekers maakt Scribe v3 12 % minder fouten dan v2, en 17 % minder bij opnames met drie of meer sprekers.
- Scribe v3 Live maakt 43 % minder fouten dan Scribe v2 Realtime, gemeten als semantische fouten: fouten die de betekenis veranderen. Op de klassieke woordfoutmaat is het 31 % minder.
- Op opgenomen toespraken uit het Europees Parlement daalt de foutmaat van het live model van 2,13 % naar 1,71 %, op Engelstalige telefoongesprekken over kwartaalcijfers van 5,99 % naar 3,91 %.
Twee kanttekeningen. FLEURS is schone, voorgelezen spraak, geen rumoerige vergadering waar mensen door elkaar praten. En de dataset voor de sprekerherkenning, met vergaderingen, telefoongesprekken en voicememo’s in 16 talen, heeft ElevenLabs nog niet vrijgegeven. Het belooft dat wel.
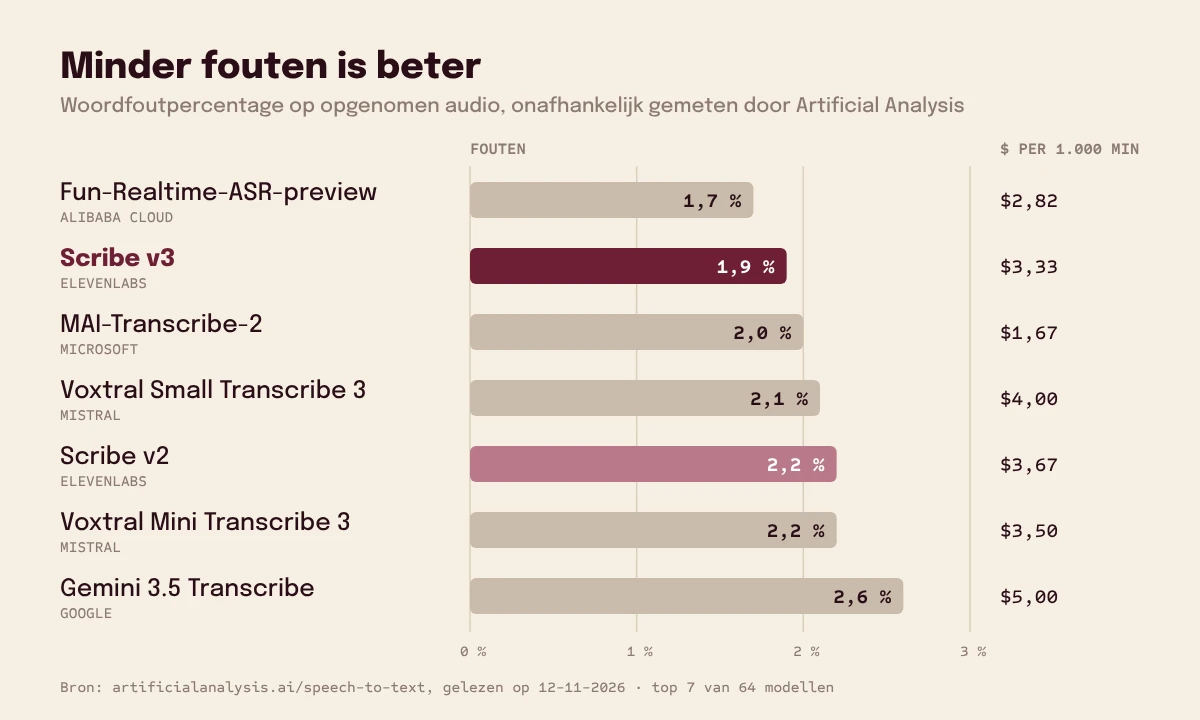
Er is wel al een onafhankelijke meting. In het klassement van Artificial Analysis staat Scribe v3 op 12 november tweede van 64 modellen voor opgenomen audio, met 1,9 % fouten. Alleen een preview-model van Alibaba Cloud doet beter met 1,7 %. MAI-Transcribe-2 van Microsoft volgt met 2,0 %, Voxtral Small Transcribe 3 van Mistral met 2,1 % en Scribe v2 met 2,2 %. Het verschil met v2 is daar dus kleiner dan 27 %, maar de testsets verschillen ook.
Een eerste externe test van het live model kwam van Voice Arena, dat Scribe v3 Live liet los op meer dan 70 uur echte telefoongesprekken. Volgens een samenvatting van CellCog daalde de foutmaat in het Roemeens van 21,2 % naar 7,3 % en in Amerikaans Engels van 3,5 % naar 2,9 %. In Amerikaans Engels bleef een realtime model van AssemblyAI wel beter. Nederlands zat niet in die test.
Verstaat Scribe v3 Nederlands
Ja, maar hoe goed precies, zegt ElevenLabs niet. Het publiceert winst per taal voor onder meer Duits, Spaans en Engels, maar niet voor het Nederlands. Wat je wel hebt:
- In de taaloverzichten van ElevenLabs stond Nederlands bij Scribe v2 al in de beste groep, met hooguit 5 % woordfouten. Een aparte tabel voor v3 is er nog niet. ElevenLabs schrijft dat v3 in elke geteste taal vooruitgaat.
- Eneco, dat in Nederland meer dan twee miljoen gezinnen en bedrijven van energie voorziet, testte Scribe v3 Live voor de lancering op echte klantengesprekken met zijn voice agent. Postcodes werden 40 % vaker in één keer goed herkend, huisnummers 15 % vaker. Hoe vaak dat eerst lukte, staat er niet bij, dus je weet niet van waar die winst vertrekt.
Over Vlaams, met zijn tussentaal en dialecten, is er geen enkel cijfer. Dat geldt voor bijna alle spraakmodellen, ook voor Nemotron 3.5 Transcribe van Nvidia. Wie in Vlaanderen werkt, test dus zelf.
Waarom die postcodes ertoe doen
Het Eneco-voorbeeld wijst naar de functie die in de praktijk het meest verandert: turn detection. Een klassieke spraaklijn wacht op een stilte en besluit dan dat jij klaar bent met praten. Zeg je je postcode met een pauze in het midden, dan schrijft het systeem de eerste helft uit en begint de agent al te antwoorden. Scribe v3 Live kijkt ook naar de inhoud van het gesprek en voorspelt zo of je zin af is. ElevenAgents gebruikte die techniek al, nu zit ze in het spraakmodel zelf.
Daarnaast heeft het live model een meertalige modus voor wie midden in een zin van taal wisselt, iets wat in Brussel en in internationale teams vaak gebeurt. En je kan een bibliotheek van tot 10.000 vaktermen meegeven, zoals productnamen, straatnamen of medische termen.
Wat kost Scribe v3
De prijs verandert niet. Volgens de prijspagina van ElevenLabs, gelezen op 12 november 2026, zonder btw:
| Model | Basisprijs per uur | Met vaktermen | Transcript laten bewerken |
|---|---|---|---|
| Scribe v3 | 0,20 dollar | +0,05 dollar | +0,07 dollar |
| Scribe v3 Live | 0,22 dollar | +0,08 dollar | +0,12 dollar |
Een uur vergadering uitschrijven kost dus zo’n twintig dollarcent. Stilte telt mee in de factuur. Naast de concurrentie zit ElevenLabs in het midden: Artificial Analysis rekent voor MAI-Transcribe-2 ongeveer de helft per minuut, voor Voxtral Small Transcribe 3 en Gemini 3.5 Transcribe meer. De betaalde abonnementen van ElevenLabs bevatten ook een aantal inbegrepen uren spraak-naar-tekst.
Wat is nieuw voor wie ermee bouwt
- Tot 1.000 vaktermen per opname bij Scribe v3, om merknamen en afkortingen juist te krijgen.
- Je kiest of getallen als cijfers of als woorden uitgeschreven worden, en je kan een tweede taal opgeven voor gemengde opnames.
- Opmaakregels in gewone taal, bijvoorbeeld dat elke datum als JJJJ-MM-DD moet staan.
- Herkenning van gevoelige gegevens zoals namen, rekeningnummers en adressen, die je desgewenst laat wegmoffelen. Het live model kent er 65 soorten.
- De officiële SDK’s ondersteunen turn prediction, de meertalige modus en de termenbibliotheek nog niet. Daarvoor praat je rechtstreeks met de websocket.
Waar gaat je audio naartoe
Standaard verwerkt ElevenLabs je audio in de Verenigde Staten. Een aparte omgeving in de EU bestaat, maar alleen voor enterpriseklanten. Je krijgt dan een apart account met eigen API-sleutel en eigen adressen. De documentatie over dataresidentie zegt er twee dingen bij die je best kent: opslag gebeurt in de EU, maar verwerking voor support en moderatie kan nog buiten de regio gebeuren, tenzij je Zero Retention Mode gebruikt. Die modus staat niet vanzelf aan. En het laten bewerken van transcripts werkt niet in die afgeschermde omgevingen.
Voor een kmo die vergaderingen of klantengesprekken laat uitschrijven, betekent dat: stemmen en wat mensen zeggen zijn persoonsgegevens. Je regelt een verwerkersovereenkomst, je informeert de deelnemers en je kijkt na of de doorgifte naar de VS gedekt is. Wie een opnametoestel zoekt dat dit voor je doet, vindt een vergelijking in ons stuk over AI-recorders voor gsm-gesprekken en Teams-meetings.
Zo test je of Scribe v3 jouw opnames aankan
- Kies vijf echte opnames die je typische werk tonen: een vergadering met vier mensen, een telefoongesprek, iemand met een sterk accent, een opname met lawaai.
- Maak een correcte referentietekst van een paar minuten per opname. Zonder referentie meet je niets.
- Laat dezelfde fragmenten uitschrijven door Scribe v2 en v3, en als je wil ook door een concurrent zoals Voxtral of MAI-Transcribe.
- Tel wat voor jou telt: verkeerde namen en cijfers, verkeerde sprekers, gemiste woorden. Een fout in een bedrag weegt zwaarder dan een gemist eh.
- Herhaal met een lijst vaktermen en kijk hoeveel dat oplevert. Bij Scribe v3 kost dat vijf dollarcent per uur extra.
Een uur testaudio kost je minder dan een euro per model. De tijd voor de referentietekst is de echte investering.
Veelgestelde vragen
Is Scribe v3 gratis?
Spraak-naar-tekst zit ook in het gratis abonnement van ElevenLabs, zodat je het kan uitproberen. Voor werk via de API betaal je 0,20 dollar per uur audio voor Scribe v3 en 0,22 dollar voor Scribe v3 Live.
Wat is het verschil tussen Scribe v3 Live en Eleven Realtime?
Scribe v3 Live zet spraak om in tekst. Eleven Realtime is een volledig spraakmodel voor voice agents dat luistert, denkt en antwoordt. ElevenAgents gebruikt Scribe v3 Live als de oren van zo’n agent.
Hoeveel sprekers herkent Scribe v3?
Tot 32 in opgenomen audio. Scribe v3 Live geeft in realtime voorlopige sprekerlabels en na elke afgeronde zin een definitief label.
Kan ik Scribe v3 zelf hosten?
Er zijn geen open gewichten. ElevenLabs biedt wel private deployment aan voor grote klanten. Zoek je een model dat je zelf draait, kijk dan naar Nemotron 3.5 Transcribe of de open modellen van Mistral.
Minder fouten is niet hetzelfde als minder werk
Een foutmaarge die van 4 naar 2 % zakt, scheelt in een vergadering van een uur zo’n 180 verkeerde woorden, rekent ElevenLabs voor. Dat merk je in een verslag. Maar wie transcripts gebruikt voor beslissingen, contracten of klantendossiers, leest nog altijd na. De echte winst van Scribe v3 zit wellicht minder in de gemiddelde foutmaat dan in de plaatsen waar fouten pijn doen: een naam op de verkeerde spreker, een postcode die halverwege wordt afgeknipt. Precies daar beloofde ElevenLabs het meest, en precies daar test je het best zelf.