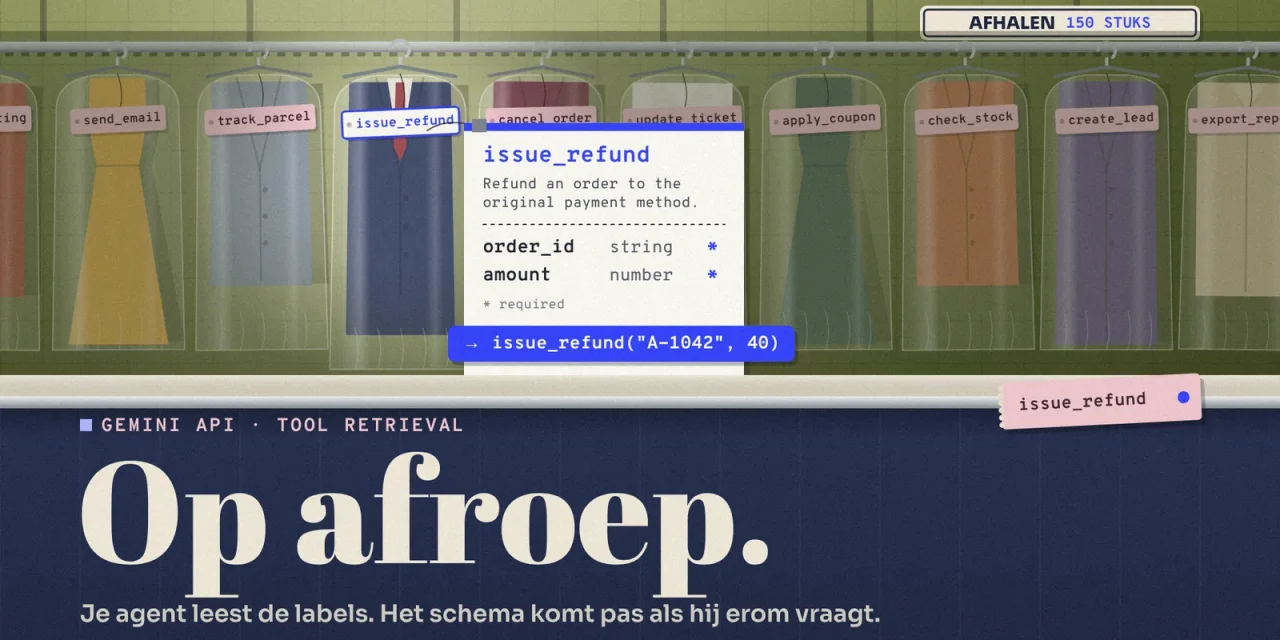
Agents in de Gemini API kunnen sinds 19 november een tool pas volledig laden als ze hem nodig hebben. Met Tool Retrieval ziet het model van elke tool alleen de naam en een korte omschrijving. Het schema met alle parameters komt er pas bij als het model de tool opvraagt, en dat gebeurt binnen hetzelfde verzoek. Bij een agent met tientallen of honderden tools bespaar je zo veel inputtokens en blijft de toolkeuze scherp. Bij een agent met een handvol tools win je er weinig mee, en soms betaal je zelfs meer.
De functie zit in preview in de Interactions API, werkt met Gemini 3.6 en nieuwer en kost niets extra. Hieronder lees je hoe het werkt, wat het oplevert, wanneer het niet loont en waar je op let voor je het aanzet.
Wat is Tool Retrieval in de Gemini API?
Een agent krijgt tools om iets te doen: een terugbetaling uitvoeren, een klant opzoeken, een afspraak inplannen. Elke tool heeft een schema in JSON dat zegt welke parameters hij verwacht. Tot nu toe stuurde je bij elk verzoek alle schema’s mee, ook die van tools die de agent die beurt niet gebruikt. Ze zijn een vast deel van de harness rond het model, en je betaalt ze elke keer opnieuw.
Dat loopt snel op. Volgens de metingen die Unblocked in mei 2026 bundelde, telt één toolschema gemiddeld 300 tot 600 tokens. Anthropic rekent voor een gewone combinatie van vijf MCP-servers, met onder meer GitHub, Slack en Sentry, ongeveer 55.000 tokens aan tooldefinities voor de agent ook maar iets doet. Het kost bovendien nauwkeurigheid: volgens de documentatie van Anthropic kiest een model slechter zodra het meer dan 30 tot 50 tools tegelijk ziet.
Met Tool Retrieval blijft je volledige toolbibliotheek beschikbaar, maar laad je een schema pas als een taak erom vraagt. Google noemt dat uitgesteld laden.
Zo werkt het in één verzoek
Je zet het aan met twee wijzigingen in je verzoek:
- Je voegt een tool van het type
tool_searchtoe. - Je zet
defer_loading: trueop de tools die je wil achterhouden.
Het model ziet daarna de naam en de omschrijving van elke uitgestelde tool, maar niet de parameters. Heeft het voor een vraag een uitgestelde tool nodig, dan vraagt het die op bij naam. De API laadt het schema en het model roept de functie meteen op. Jouw app voert de functie uit en stuurt het resultaat terug, zoals bij gewone function calling.
In het voorbeeld van Google meldt een klant dat bestelling A-1042 beschadigd aankwam en vraagt hij 40 dollar terug. Het model zoekt de tool issue_refund, krijgt het schema met order_id en amount, en roept de functie op met A-1042 en 40. In het antwoord zie je dat als drie stappen: tool_search_call, tool_search_result en function_call. Zo kan je nagaan welke tools het model overwoog. Google gebruikt in het voorbeeld Gemini 4 Hydrogen.
tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "issue_refund",
        "description": "Refund an order to the original payment method.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "amount": {"type": "number"},
            },
            "required": ["order_id", "amount"],
        },
    },
    # ... de rest van je uitgestelde tools
]

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Order A-1042 arrived damaged. Please refund 40 dollars.",
    tools=tools,
)
Tools die je agent bijna altijd gebruikt, stel je beter niet uit. Die blijven meteen oproepbaar, zonder zoekstap. Het zoeken zelf gebeurt op de servers van Google, dus je hoeft geen index te bouwen of te hosten.
Server of client, wie zoekt de tool?
Standaard zoekt Google. Je kan het zoeken ook zelf doen met "execution": "client". Dan geef je de zoektool een naam, een omschrijving en een parameter voor de zoekvraag. Roept het model die zoektool op, dan zoekt jouw app in een eigen register en stuurt ze de volledige functiedefinities terug. Het gesprek gaat verder met previous_interaction_id.
Dat is nuttig als je al een toolregister hebt, een eigen zoekindex, of rechten per gebruiker. Je tools hoeven dan niet vooraf in het verzoek te staan, dus je kan er tijdens het gesprek bijvoegen, bijvoorbeeld als een gebruiker net een nieuwe koppeling aanzet. Elke zoekopdracht kost wel een extra heen-en-weer tussen je app en de API.
| Server, standaard | Client | |
|---|---|---|
| Wie zoekt | Google, op naam en omschrijving | Jouw app, met je eigen logica |
| Tools vooraf meesturen | Ja, met defer_loading | Nee, je app geeft ze terug na een zoekopdracht |
| Extra heen-en-weer | Nee | Eén per zoekopdracht |
| MCP-servers uitstellen | Ja | Nee |
| Past bij | Een grote, vaste toolbibliotheek | Rechten per gebruiker, een eigen register, tools die tijdens het gesprek bijkomen |
De twee mengen in één verzoek kan niet. defer_loading werkt alleen met zoeken aan de kant van Google.
Een hele MCP-server in één keer uitstellen
Gebruik je remote MCP-servers in de Gemini API, dan zet je defer_loading: true op de mcp_server zelf. Alle tools van die server worden dan op aanvraag geladen, zonder dat je ze één voor één moet opsommen. De API voert die tools zelf uit en toont ze als mcp_server_tool_call en mcp_server_tool_result. Dat werkt alleen als Google zoekt, en de documentatie noemt alleen remote MCP-servers.
Hier zit de grootste winst. De MCP-server van een SaaS-pakket telt al snel tientallen tools, en wie er drie of vier koppelt, zit aan honderden. Met één instelling per server hou je dat beheersbaar.
Wat het kost, en wanneer het niet loont
Tool Retrieval heeft geen eigen prijs. Je betaalt de gewone tarieven van het model, maar een paar dingen tellen mee:
- De zoektool zelf voegt een vast blok inputtokens toe.
- Elke uitgestelde tool blijft meetellen met zijn naam en korte omschrijving.
- Elk schema dat het model laadt, telt als input voor de rest van het gesprek, net als een tool die je vooraf meestuurt.
- Elke zoekopdracht aan de kant van Google is een extra modeloproep. Die tokens staan apart in
total_tool_use_tokensen kosten het gewone inputtarief.
Google zegt zelf dat je wint als de schema’s die je niet laadt zwaarder wegen dan wat je wel laadt, en raadt aan het op je eigen verkeer te meten. Een rekenvoorbeeld maakt dat concreet. We namen aan dat een schema 400 tokens telt, een naam met korte omschrijving 25 tokens en het zoekblok 500 tokens. Google geeft voor dat blok geen getal. 500 is wat Anthropic voor zijn eigen zoektool opgeeft.
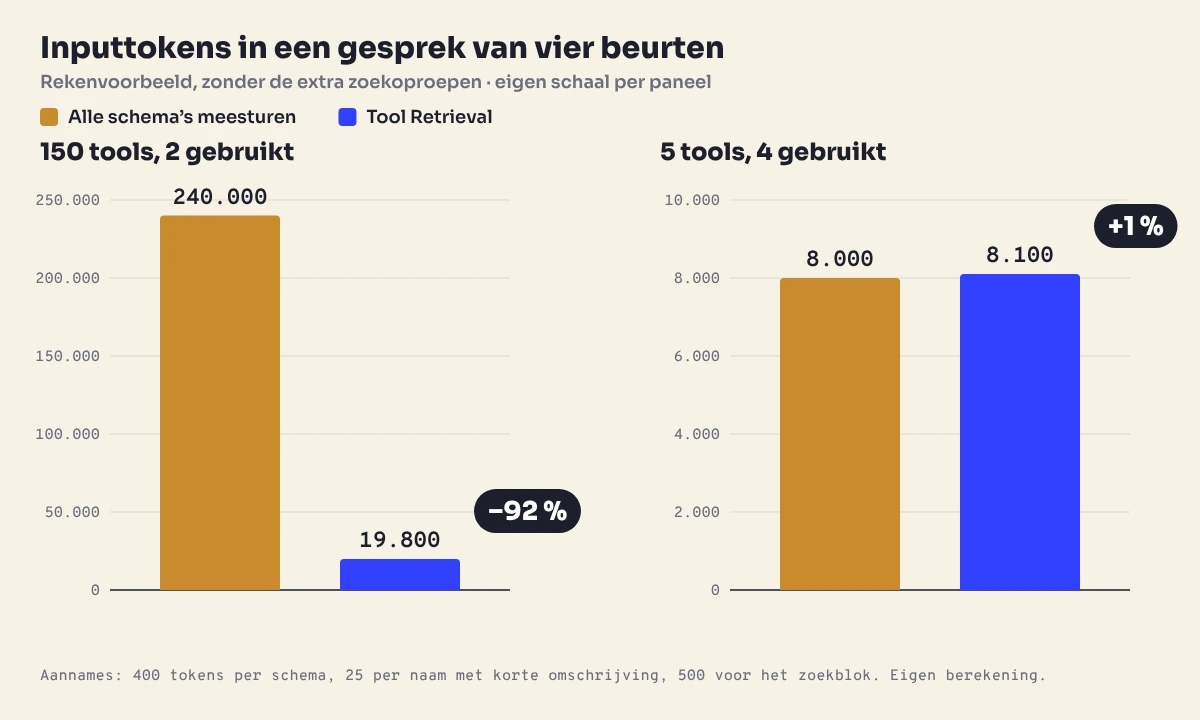
Een agent met 150 tools die er in een gesprek van vier beurten twee gebruikt, stuurt zonder Tool Retrieval 240.000 inputtokens. Met Tool Retrieval is dat ongeveer 19.800, of 92 procent minder. Een agent met vijf tools die er in de eerste twee beurten vier oproept, gaat van 8.000 naar 8.100 tokens. Daar komen de zoekoproepen nog bij, dus die agent betaalt meer. De documentatie raadt bij minder dan 20 stabiele tools daarom gewoon statisch laden aan.
Caching verkleint het verschil in geld. Gemini past impliciete caching toe als het begin van je prompt gelijk blijft. Bij Gemini 4 Hydrogen kost een gecachet inputtoken 0,075 dollar per miljoen in plaats van 1,50 dollar. Staan je 150 schema’s elke beurt identiek vooraan, dan zakt de statische versie in ons voorbeeld van 0,36 naar ongeveer 0,10 dollar per gesprek, als de cache raakt. De uitgestelde versie kost ongeveer 0,03 dollar, plus de zoekoproepen. Omgekeerd kan uitstellen een middelgrote prompt onder de minimale grootte voor caching duwen. Meten blijft de enige manier om zeker te zijn.
Belangrijker dan de rekening is misschien de juiste toolkeuze. Anthropic mat bij zijn eigen versie dat Claude Opus 4 op evaluaties met grote MCP-bibliotheken vaker de juiste tool koos, van 49 naar 74 procent. Google publiceerde voor Gemini nog geen cijfers.
Google doet nu wat Anthropic en OpenAI al deden
Het idee is niet nieuw, en de naam ook niet. Anthropic bracht in november 2025 zijn Tool Search Tool uit, met dezelfde vlag defer_loading: true. OpenAI volgde in maart 2026 met tool search bij GPT-5.4, opnieuw met defer_loading en met een keuze tussen zoeken door OpenAI of door je eigen app.
| Aanbieder | Sinds | Hoe je het aanzet | Gepubliceerde winst |
|---|---|---|---|
| Anthropic | 24 november 2025 | Zoektool en defer_loading | 85 % minder tokens, Opus 4 kiest in 74 % in plaats van 49 % de juiste tool |
| OpenAI | 5 maart 2026, GPT-5.4 | tool_search en defer_loading | 47 % minder tokens bij gelijke nauwkeurigheid, op 250 taken met 36 MCP-servers |
| 19 november 2026 | tool_search en defer_loading | Nog geen cijfers |
De 47 procent van OpenAI komt uit een test op Scale’s MCP Atlas-benchmark, zoals The Decoder en andere media meldden. Dat de drie grote API’s dezelfde vlag gebruiken, is handig. Wie zijn tools nu verdeelt in een kern en een staart, met goede namen en omschrijvingen, neemt die indeling mee naar een andere aanbieder. De details verschillen wel. OpenAI raadt aan tools te groeperen in namespaces van minder dan tien functies en Anthropic geeft je kant-en-klare zoektools op basis van regex en BM25. Google zegt niet hoe zijn eigen zoektocht werkt.
Waar het nog wringt
- Preview en alleen in de Interactions API. Het werkt in v1beta en niet met
generateContent. De API kan nog veranderen voor hij algemeen beschikbaar wordt. - Geladen is geladen. Een schema dat het model ophaalt, blijft de rest van het gesprek in de context en blijft meetellen. Ontladen kan niet.
- De omschrijving beslist. Het model kiest op naam en omschrijving. Vage of overlappende omschrijvingen leiden tot de verkeerde tool. Google raadt aan de dienst vooraan in de naam te zetten, zoals
billing_get_customerencrm_get_customer. - Tools uit je instructies niet uitstellen. Noem je een tool bij naam in je systeeminstructies, laat hem dan geladen. Anders kan het model hem oproepen zonder te zoeken, en dat geeft een foutmelding.
- Zonder opslag zelf de stappen bewaren. Met
store=falsestuur je elke stap ongewijzigd terug, met de handtekening erbij. Laat jetool_search_resultweg, dan krijg je geen fout, maar valt het geladen schema stil weg. - Opslag bij Google. Standaard bewaart de Interactions API je interacties 55 dagen op een betaald project en 1 dag op de gratis versie, volgens de documentatie van Google.
- Geen cijfers. Google publiceerde geen benchmarks, geen latentie en geen limiet op het aantal tools.
Zo begin je eraan
- Tel wat je tools nu kosten. Log de inputtokens per verzoek, met en zonder je tooldefinities.
- Kies je kern. De drie tot vijf tools die bijna elk gesprek gebruikt, blijven geladen. De rest stel je uit.
- Herschrijf namen en omschrijvingen. Zet de dienst vooraan in de naam en laat de eerste zin zeggen wat de tool doet. Voor een lange omschrijving is er een apart veld
short_description. - Test in een testomgeving. Vergelijk tokens en toolkeuze, en kijk in
interaction.stepswelke tools het model zocht. - Zet het alleen aan waar het loont. Dus waar de besparing groter is dan het zoekblok en de zoekoproepen samen.
Dat is werk aan de omgeving rond het model, wat we eerder harness engineering noemden: het model blijft hetzelfde, de agent wordt beter.
Veelgestelde vragen over Tool Retrieval in de Gemini API
Kost Tool Retrieval extra?
Nee. Je betaalt de gewone tarieven van het model. Het zoekblok, de geladen schema’s en de zoekoproepen tellen wel als input.
Met welke modellen werkt Tool Retrieval?
Met Gemini 3.6 Flash, Gemini 3.8 Flash en alle Gemini 4-modellen: Hydrogen, Neon, Argon en Carbon. Oudere modellen geven een foutmelding.
Werkt het met generateContent?
Nee. Tool Retrieval werkt alleen in de Interactions API, in v1beta.
Wanneer zet ik het beter niet aan?
Bij een kleine, stabiele set van minder dan 20 tools, of als je agent in de meeste gesprekken toch bijna al zijn tools gebruikt. Dan kost het zoeken meer dan het bespaart.
Werkt Tool Retrieval met MCP?
Ja, met remote MCP-servers. Je zet defer_loading: true op de server, en Google zoekt en laadt de tools van die server op aanvraag.
Je tools moeten nu gevonden worden
Met Tool Retrieval leest het model geen volledige handleiding meer, maar een lijst met namen en één zin uitleg. Wat in die ene zin staat, beslist of je agent de juiste tool vindt. Een tool met een vage omschrijving bestaat voor het model straks gewoon niet. Wie zijn tools vandaag een heldere naam en een scherpe eerste zin geeft, wint dus twee keer: minder tokens en een agent die vindt wat hij zoekt, bij Google en bij de andere twee.