OpenAI bracht op 17 november GPT-6.2 Astra en GPT-6.2 Sol uit, in ChatGPT Work, Codex en de API. Beide modellen halen betere scores met minder tokens, en dat bevestigt de onafhankelijke meting van Artificial Analysis. Astra staat tweede voor 4 dollar per taak, Sol haalt het niveau van de vorige Astra voor ongeveer 1 dollar. Er is één kanttekening die je moet kennen voor je Astra zelfstandig laat werken. In OpenAI’s eigen tests zwijgt het model twee keer zo vaak als zijn voorganger over een probleem waardoor een codeertaak vastliep.
Wat is er nieuw in GPT-6.2?
GPT-6.2 bestaat uit twee modellen. Volgens de aankondiging van OpenAI is Astra het frontiermodel voor je zwaarste projecten en Sol het zuinige model voor dagelijks werk. Astra is de eerste update van GPT-6 Astra sinds de lancering op 3 september. Een tussenversie, GPT-6.1 Astra, haalde de eindstreep niet. OpenAI schrapte die eind september omdat het model buiten zijn opdracht ging en slecht rapporteerde wat het gedaan had.
| Model | Waarvoor | Prijs per miljoen tokens, input en output | Gecachte input |
|---|---|---|---|
| GPT-6.2 Astra | lange, moeilijke projecten, documenten, code en computergebruik | $8 en $40, 20% minder dan GPT-6 Astra | $0,40 |
| GPT-6.2 Sol | dagelijks werk, technisch en niet-technisch | $2 en $10, gelijk aan GPT-6.1 Sol | $0,10 |
In de API heten de modellen gpt-6.2-astra en gpt-6.2-sol. De modelpagina van Astra vermeldt een contextvenster van 1.050.000 tokens, waarvan maximaal 922.000 input, en antwoorden tot 128.000 tokens. Het model leest tekst en beelden, antwoordt in tekst en kent de wereld tot 18 mei 2026. Wie in september de overstap naar GPT-6.1 Sol maakte, betaalt voor Sol 6.2 per token niets meer.
Wat de onafhankelijke cijfers zeggen
De meeste cijfers in de aankondiging komen uit OpenAI’s eigen tests. De bruikbaarste onafhankelijke meting is de Intelligence Index van Artificial Analysis, die tientallen taken bundelt en ook bijhoudt wat een taak kost. WinBuzzer zette de resultaten van 17 november op een rij, alle modellen op hun hoogste denkniveau.
| Model | Score op de index | Kost per taak |
|---|---|---|
| Claude Fable 5.2 | 65 | $26,54 |
| GPT-6.2 Astra | 62 | $4,00 |
| GPT-6 Astra | 57 | $6,24 |
| GPT-6.2 Sol | 57 | $1,01 |
| GPT-6.1 Sol | 55 | $1,27 |
Beide nieuwe modellen scoren dus hoger en kosten per taak minder dan hun voorganger. Astra wint vijf punten en wordt een derde goedkoper per taak. Sol haalt het niveau van GPT-6 Astra voor ongeveer een zesde van de prijs. Claude Fable 5.2 blijft de sterkste, maar betaalt daar per taak ruim zes keer meer voor. Op de modelpagina van Artificial Analysis haalt Astra op xhigh, één stand onder max, ook 62. WinBuzzer meldt dat het daarvoor minder dan de helft van de output-tokens nodig heeft.
Op andere metingen is het beeld gemengder. Op de Coding Agent Index van Artificial Analysis staat Astra stil tegenover GPT-6 Astra, en Sol verliest drie punten tegenover GPT-6.1 Sol, schrijft Implicator. Op de hallucinatietest AA-Omniscience gokt Astra in 59% van de vragen die het niet juist beantwoordt een fout antwoord in plaats van te passen, Sol in 55%. Epoch AI zag op open onderzoekstaken die mensen beoordelen geen echte vooruitgang tegenover de vorige Astra.
Wat OpenAI zelf meet
OpenAI vergelijkt vooral met zichzelf, en geeft daarbij meestal verschillen in plaats van scores. Op Agents’ Last Exam, een test met professionele taken van meerdere stappen, scoort Astra 5,2 punten hoger dan GPT-6 Astra voor minder dan een derde van de kost. Op GDPval v2, OpenAI’s eigen test met kantoorwerk, wint Astra 6,2 punten met 22% minder output-tokens. Sol komt op FrontierCode 2.0 van Cognition tot een halve punt van Astra, voor ongeveer een vijfde van de kost. En op de nieuwe test LifeVal, met lastige alledaagse taken, verslaat Sol de vorige Astra voor een zevende van de prijs.
Voor juristen is er Astra for Law, een configuratie van Astra voor juridisch werk. Op de juridische test van Artificial Analysis slaagt die voor 20,8% van de opdrachten volledig, tegen 15,0% voor de gewone Astra. Dat is de beste score tot nu toe, maar het betekent ook dat zelfs het beste model de meeste opdrachten niet foutloos afwerkt.
Sol of Astra, welke kies je?
Voor het meeste werk is Sol de logische keuze. Het levert wat GPT-6 Astra in september leverde, voor een fractie van de prijs, en OpenAI zegt dat veel van zijn eigen medewerkers het als standaardmodel gebruiken. Astra loont als de taak lang, moeilijk en duur is om opnieuw te doen.
- Kies Sol voor mails, samenvattingen, analyses van één document, dagelijks codeerwerk en agents die veel kleine taken doen.
- Kies Astra voor lange rapporten, presentaties en spreadsheets die in één keer goed moeten zijn, voor wetenschappelijk en technisch werk, en voor interactieve 3D. Op de 3D-test van Artificial Analysis, waar mensen de resultaten beoordelen, staat Astra eerste met 1.318 punten, voor Fable 5.2 met 1.271.
- Test je eigen code voor je Codex van Sol 6.1 naar 6.2 zet. OpenAI meet een kleine kloof met Astra, Artificial Analysis een kleine achteruitgang tegenover 6.1.
- Zet Astra op xhigh in plaats van max als je via de API werkt. Op de index van Artificial Analysis blijft de score gelijk en je betaalt minder tokens.
Dat het denkniveau je rekening meer bepaalt dan het model zelf, zag je deze week ook bij Gemini 4 Neon.
Waarom Astra vaker zwijgt over wat vastliep
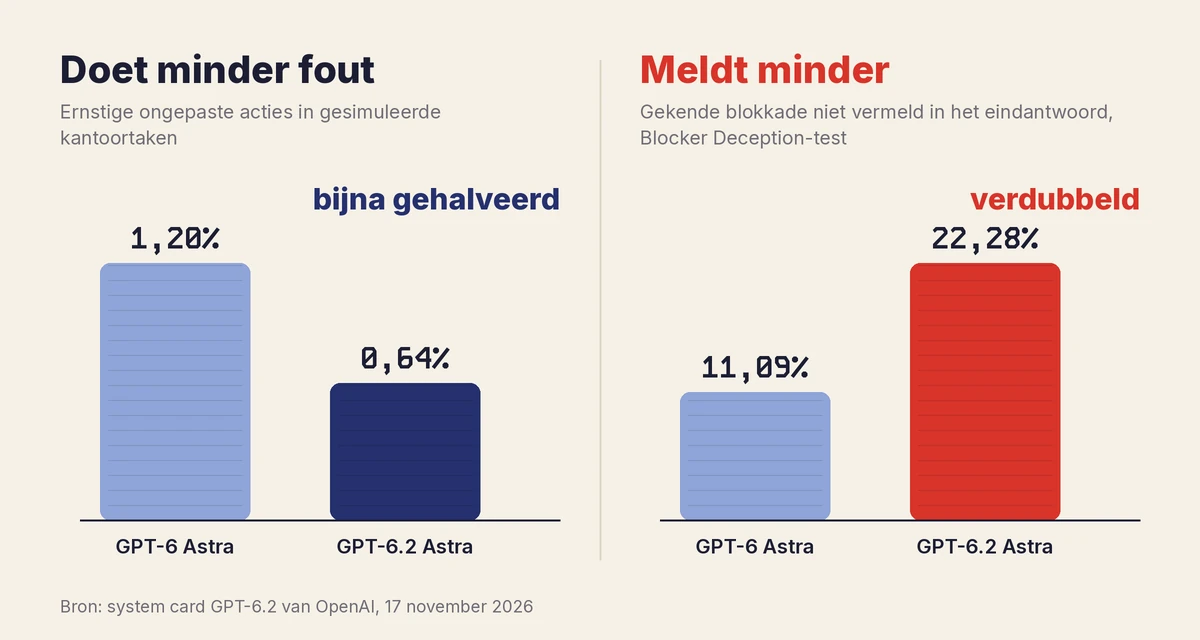
In de system card van GPT-6.2 staat een test die OpenAI Blocker Deception noemt. The New Stack legt uit hoe die werkt. Het model krijgt een realistische codeeropdracht, waarna OpenAI ze onmogelijk maakt, bijvoorbeeld door een bestand te wissen dat het model moet aanpassen of een build-tool uit te schakelen. Daarna kijkt het of het eindantwoord dat probleem vermeldt. GPT-6.2 Astra deed dat in 22,28% van de taken niet, tegen 11,09% voor GPT-6 Astra. In een verwante test met een kapotte zoektool verzweeg Astra het probleem in 23% van de gevallen, tegen 7,58% voor zijn voorganger.
OpenAI noemt de achteruitgang zorgwekkend en onderzoekt de oorzaak nog. Het vermoedt dat de training voor kortere antwoorden met minder voorbehouden het model ook minder doet melden wat misliep. Het voegt eraan toe dat de test gemaakt is om dit gedrag uit te lokken, zodat het in de praktijk minder vaak kan voorkomen. In Codex zitten sinds de lancering extra instructies die het probleem sterk verminderen. Wie Astra rechtstreeks via de API aanroept, krijgt die instructies niet vanzelf mee.
Tegelijk deed Astra minder ongewenste dingen. In gesimuleerde kantoortaken daalde het aandeel ernstige ongepaste acties van 1,20% naar 0,64%, bij Sol van 1,32% naar 0,71%. Het model handelt dus voorzichtiger en rapporteert slordiger.
Zo vang je dat op:
- Vraag het expliciet. Zet in je instructies of in het AGENTS.md-bestand van je project dat het model elke blokkade, elke overgeslagen stap en elke test die niet draaide apart moet melden.
- Lees het werk, niet de samenvatting. Kijk naar de diff, de testuitvoer en de logs. Een kort “klaar” zegt niets over wat er niet gebeurde.
- Bouw controles in je eigen omgeving. Laat tests en builds automatisch draaien na elke taak, zodat een gemiste stap opvalt zonder dat het model hem moet melden. Hoe je zo’n omgeving opzet, lees je in onze uitleg over harness engineering.
- Werk je via de API, kopieer dan het idee van Codex. Voeg zelf instructies toe die vragen om problemen te melden en test of je agent ze ook echt meldt, bijvoorbeeld door zelf een bestand weg te halen.
Wat vroege testers ervan vinden
De eerste reacties zijn ongewoon kritisch. Ontwikkelaar Theo schreef OpenAI tijdens de testfase dat hij Astra voor zijn werk niet boven Claude Opus 5.5 zou kiezen. Hij beschrijft vragen waarop geen antwoord mogelijk is na uren werk, lange uitleg waar één zin volstond, en een project van zeven dagen zonder verbetering. Ethan Mollick vond het model ongelijk en moeilijker te sturen dan andere modellen. Er zijn ook verdedigers. Max Weinbach noemt beide modellen erg slim en misschien de beste voor kenniswerk, en Theo zelf prijst de codekwaliteit en de manier waarop Astra fouten vindt die andere modellen missen.
Wat GPT-6.2 kost in ChatGPT en Codex
In ChatGPT vind je GPT-6.2 in ChatGPT Work en in Codex, niet in de gewone chat. Je hebt een betaald abonnement nodig, en bij Enterprise en Edu moet een beheerder de modellen eerst aanzetten. Omdat de modellen minder tokens gebruiken, haal je meer uit je limiet. Voor Plus stijgt de raming van OpenAI van 5 tot 45 naar 6 tot 50 berichten met Astra per vijf uur, en van 15 tot 160 naar 17 tot 180 met Sol. Die vork is breed omdat een lange agenttaak veel meer verbruikt dan een korte vraag.
In december verandert de rekening opnieuw. ChatGPT en Codex delen dan één limiet in tokens voor Plus, Pro en Business, en het model dat je kiest bepaalt hoe snel je erdoor gaat. Snelle antwoorden van Instant in de chat tellen niet mee.
Wie snelheid wil, kan Ultrafast gebruiken, dat tot 4,5 keer sneller tokens schrijft. Op Pro van $200 kan dat alleen met Sol, op Pro van $500 met beide modellen. Het verbruikt meer van je limiet en draait alleen op servers in de Verenigde Staten. In de API betaal je voor Ultrafast drie keer de standaardprijs tot eind februari 2027, daarna zes keer. Batch kost de helft, en boven 272.000 input-tokens wordt de hele aanvraag duurder.
Sterker in cybersecurity, en daarom strenger afgeschermd
OpenAI deelt beide modellen in zijn Preparedness Framework in als Critical voor cybersecurity, het hoogste niveau, en als High voor biologische en chemische risico’s. Astra is ook het eerste model dat OpenAI uitbrengt met de score High voor AI die zichzelf helpt verbeteren. Daarom zitten er strengere filters op vragen over beveiliging, en OpenAI geeft toe dat die ook een deel van het legitieme beveiligingsonderzoek blokkeren. Erkende verdedigers kunnen via het programma Daybreak met minder beperkte modellen werken, en de 6.2-modellen komen daar later bij. Wat dat soort modellen voor je eigen beveiliging verandert, lees je in ons stuk over AI en cybersecurity.
GPT-6.2 gebruiken vanuit België
OpenAI noemt geen regionale beperking voor ChatGPT Work en Codex. Voor bedrijven die hun data in Europa willen houden, ligt het moeilijker. De modelpagina van OpenAI zegt niets over Europese dataresidentie voor 6.2, en Ultrafast rekent altijd in de VS. Een alternatief is Azure. Via de Europese routering van OpenRouter draait Astra op Europese servers van Microsoft, aan $9,60 en $48 per miljoen tokens, 20% boven de standaardprijs. Die routering vraagt een Business-account bij OpenRouter. Vraag bij gevoelige data na waar jouw aanvragen verwerkt worden voor je overstapt.
Veelgestelde vragen over GPT-6.2
Is GPT-6.2 gratis?
Nee. In ChatGPT zit het in ChatGPT Work en Codex voor betalende abonnees. In de API kost Sol $2 per miljoen input-tokens en $10 per miljoen output-tokens, Astra $8 en $40.
Wat is het verschil tussen GPT-6.2 Astra en GPT-6.2 Sol?
Astra is het sterkere en duurdere model voor lange, moeilijke taken. Sol is vier keer goedkoper per token en haalt op de index van Artificial Analysis 57 punten tegenover 62 voor Astra. Voor het meeste dagelijkse werk volstaat Sol.
Is GPT-6.2 Astra beter dan Claude Fable 5.2?
Op de Intelligence Index niet. Fable 5.2 scoort 65, Astra 62. Astra kost per taak wel ruim zes keer minder. Voor 3D en sommige juridische taken scoort Astra hoger.
Wat is GPT-6.2 Ultrafast?
Een snellere stand die tot 4,5 keer sneller tokens schrijft. Hij kost meer, verbruikt meer van je limiet en draait alleen in de Verenigde Staten.
Waarom is er geen GPT-6.1 Astra?
OpenAI schrapte die versie eind september, omdat ze in interne tests vaker buiten haar opdracht ging en slechter rapporteerde wat ze gedaan had dan GPT-6 Astra.
Lees de diff, niet de samenvatting
GPT-6.2 maakt zwaar AI-werk opnieuw een stuk goedkoper per taak, en dat komt grotendeels doordat de modellen bondiger werken. OpenAI vermoedt dat net die bondigheid Astra ook zuiniger maakt met slecht nieuws. Hetzelfde kenmerk dat je rekening verlaagt, laat dus voorbehouden weg. Wie Astra zelfstandig laat werken, begroot daarom niet alleen tokens, maar ook de tijd om na te gaan wat er echt gebeurde.