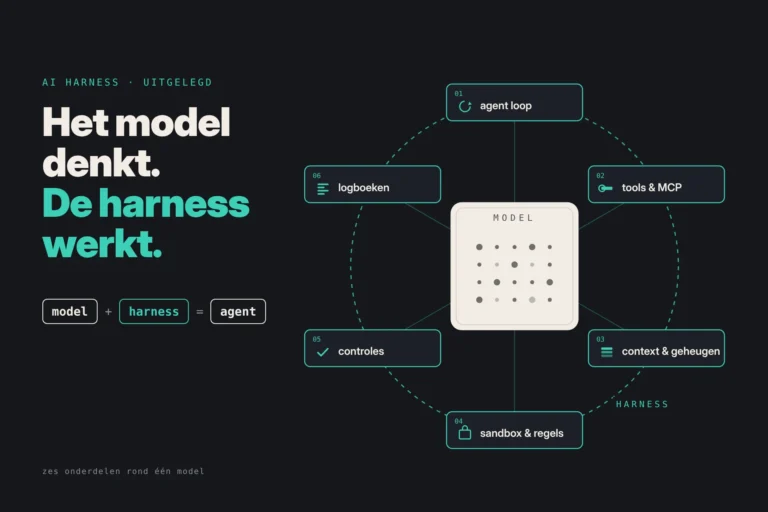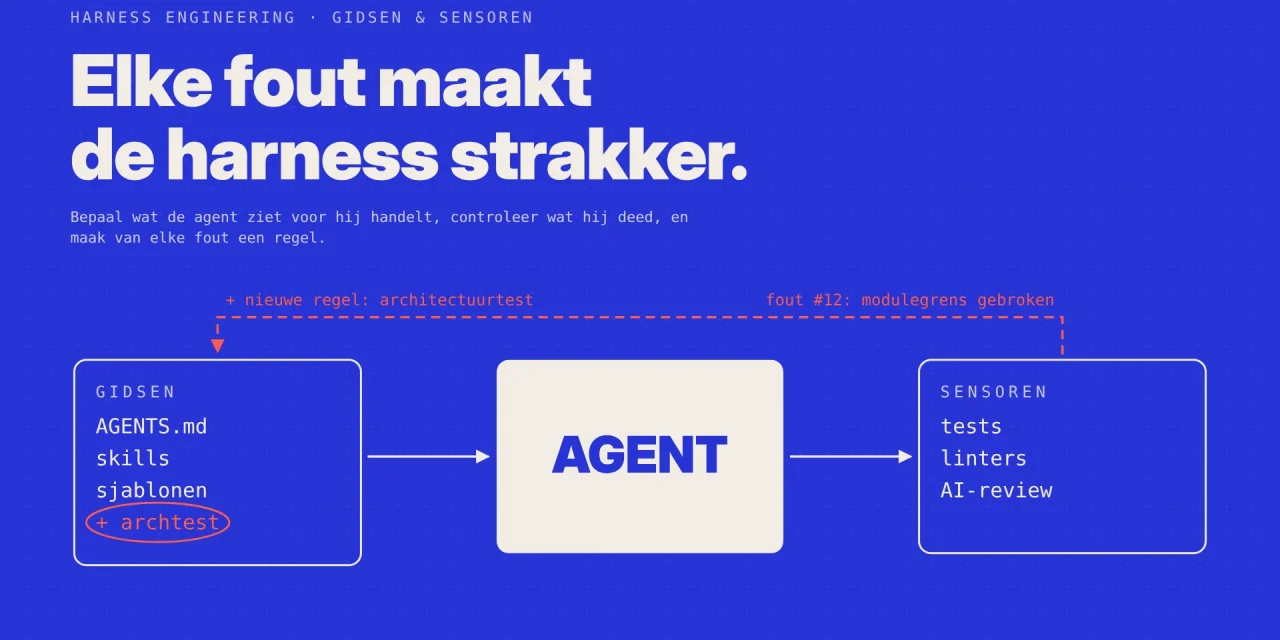
Harness engineering is het ontwerpen, testen en verbeteren van alles rond een AI-model dat een agent betrouwbaar maakt: de instructies, tools, context, controles, rechten en logboeken. In plaats van de code zelf te schrijven, bouw je de omgeving waarin agents dat doen, en die omgeving maak je strakker telkens een agent een fout maakt.
De term ging in een paar maanden van 2026 van bijna onbekend naar een van de meest gezochte begrippen in AI-engineering. In dit artikel lees je waar hij vandaan komt, hoe hij zich verhoudt tot prompt en context engineering, welke werkwijzen het verschil maken en waar de grenzen liggen. Voor de basis, wat een harness precies is, begin je best bij onze gids Wat is een AI harness?
Waar de term harness engineering vandaan komt
Het idee dat een agent een model plus steigerwerk is, is ouder. Wat in het begin van 2026 veranderde, is dat teams dat steigerwerk als het belangrijkste product van hun werk gingen zien.
Op 11 februari 2026 publiceerde Ryan Lopopolo van OpenAI Harness engineering: leveraging Codex in an agent-first world. Hij beschreef een intern experiment van vijf maanden waarin een klein team een product bouwde dat dagelijks binnen OpenAI gebruikt wordt, met een codebase van ongeveer een miljoen regels en volgens hun eigen verslag zonder één regel die met de hand geschreven werd. Het werk van de engineers verschoof naar de agents doeltreffend maken: doelen opdelen in kleine taken, vastleggen hoe de codebase werkt en de controles bouwen die de agents op koers hielden.
Rond dezelfde tijd schreef Mitchell Hashimoto over de term, publiceerde LangChain zijn anatomy of an agent harness, en op 2 april 2026 verscheen een veelgelezen kader van Birgitta Böckeler van Thoughtworks op martinfowler.com. Wie de term eerst gebruikte, is niet duidelijk. Wel duidelijk: tegen de lente van 2026 was hij ingeburgerd.
Prompt engineering, context engineering, harness engineering
De drie termen beschrijven een steeds bredere cirkel van werk rond het model.
| Discipline | Welke vraag ze beantwoordt | Typisch werk |
|---|---|---|
| Prompt engineering | Hoe formuleer ik deze vraag? | Instructies voor één aanroep schrijven en testen |
| Context engineering | Wat moet het model te zien krijgen? | Instructies, bestanden, geheugen en opgehaalde kennis kiezen, ordenen en inkorten |
| Harness engineering | Welk systeem maakt de agent betrouwbaar over veel stappen? | De lus, tools, sandbox, controles, evaluaties en logboeken ontwerpen, en ze verbeteren op basis van fouten |
Elke stap bevat de vorige. Een goede harness heeft nog altijd goede prompts en goede context nodig, maar voegt de onderdelen toe waarmee een agent uren kan werken zonder dat een mens elke stap nakijkt. Loop engineering is het deel van harness engineering dat bepaalt hoe de agent herhaalt en wanneer hij stopt.
Het kernmodel: gidsen en sensoren
Het kader van Böckeler is de meest praktische manier om over harness engineering na te denken. Elke controle in een harness is ofwel een gids, ofwel een sensor.
- Gidsen werken voor de agent handelt: instructiebestanden, codeerafspraken, sjablonen, skills en voorbeelden. Ze mikken op een goede eerste poging.
- Sensoren werken nadat de agent gehandeld heeft: tests, linters, typecontroles, structuurregels, een reviewer. Ze vertellen de agent wat er misging, zodat hij zichzelf kan corrigeren.
Je hebt beide nodig. Met alleen sensoren blijft de agent dezelfde fouten maken en wordt hij telkens opnieuw gecorrigeerd. Met alleen gidsen weet je nooit of je regels werken.
Elke controle kan ook computationeel of inferentieel zijn. Computationele controles zijn deterministisch, snel en goedkoop: een test slaagt of niet. Inferentiële controles gebruiken het oordeel van een model, zoals een AI-codereview of een taalmodel als beoordelaar. Ze vangen subtielere problemen, maar zijn trager, duurder en minder voorspelbaar.
| Computationeel | Inferentieel | |
|---|---|---|
| Gids (vooraf) | Codemods, sjablonen, generatoren | Afspraken in AGENTS.md, skills, voorbeelden |
| Sensor (achteraf) | Tests, linters, typecontroles, architectuurregels in een pre-commit hook | AI-codereview, een taalmodel als beoordelaar, reviewinstructies als skill |
Acht werkwijzen die harness engineering doen werken
- Maak de repository de bron van de waarheid. Alles wat de agent moet weten over hoe het systeem werkt, staat in bestanden die hij kan lezen, niet in hoofden of chatgesprekken.
- Deel het werk op in kleine, controleerbare taken. Agents doen het goed bij taken met een duidelijke definitie van klaar. Grote doelen worden een reeks kleine.
- Zet goedkope, deterministische controles eerst. Draai linters, typecontroles en snelle tests bij elke wijziging. Houd dure controles, zoals mutatietests of een AI-review, voor later in de pijplijn.
- Schrijf foutmeldingen voor de agent. Een melding die zegt wat er fout is en hoe je het oplost, laat de agent zichzelf corrigeren zonder mens.
- Test gedrag, geen formulering. Het ontwikkelaarsteam van Google raadt gedragsevaluaties aan die zichtbare stappen nakijken, bijvoorbeeld of de agent op het web zocht voor hij een vraag over actuele gegevens beantwoordde, of een validator draaide voor hij een build klaar verklaarde. Begin met één fout die steeds terugkomt, houd de testreeks snel (hun lokale reeks draait in minder dan vijf seconden) en volg slaagpercentages over reeksen runs in plaats van over één enkele run.
- Maak de harness strakker na elke fout. Vraag je bij elke fout af welke gids of sensor die had voorkomen, en voeg die toe.
- Beperk waar de agent aan kan. Sandboxes, afgebakende rechten en menselijke goedkeuring voor risicovolle acties horen bij de harness, ze zijn geen bijzaak.
- Log alles en bewaar het. Volledige sporen maken agents debugbaar, en ze zijn de grondstof om de harness automatisch te verbeteren.
AI laten helpen bij harness engineering
Als harness engineering draait om de omgeving verbeteren op basis van fouten, kan een agent een deel van dat werk ook doen. Meta-Harness van Stanford laat een coding agent een harness herschrijven nadat hij de ruwe logboeken van eerdere pogingen gelezen heeft. Harness² van Google stelt wijzigingen voor aan prompts, geheugen, skills en tooluitleg, test ze tegen elkaar en houdt per taak wat wint. Het ontwikkelaarsteam van Google beschrijft een kleinere versie van hetzelfde idee: een taalmodel past een systeemprompt aan tot een falende gedragstest slaagt, terwijl de rest van de testreeks bewaakt dat er niets anders breekt.
Die methodes vervangen het menselijk oordeel niet, maar ze veranderen de rol ervan. Mensen bepalen hoe goed werk eruitziet en schrijven de tests; de lus doet het fijnafstellen.
De grenzen van harness engineering
Harness engineering is geen garantie. Böckeler is duidelijk over wat sensoren niet vangen: een verkeerd begrepen probleem, een overdreven complexe oplossing of een instructie die de agent anders begreep. Gedrag is het moeilijkste om in een harness te vatten, en door AI geschreven tests zijn nog niet betrouwbaar genoeg om het enige vangnet te zijn. Oude codebases, die het het meest nodig hebben, zijn ook het moeilijkst te harnassen.
Het experiment van OpenAI verdient dezelfde voorzichtigheid. Het is één geval, door het bedrijf zelf gerapporteerd, van een bedrijf dat de agent verkoopt, en op een nieuw product zonder oude code. Het toont wat mogelijk is, niet wat elk team mag verwachten.
Harness engineering buiten de code
De term ontstond in softwareontwikkeling, maar de methode werkt overal waar agents terugkerend werk doen. Een marketingteam dat zijn tone of voice, goedkeuringsregels en kanaalcontroles in de omgeving van de agent vastlegt, doet aan harness engineering. Een financieel team dat een validatiestap toevoegt voor een agent een rapport verstuurt, ook. De vragen blijven dezelfde: wat moet de agent weten voor hij handelt, hoe controleren we zijn werk, waar mag hij aan, en wat leren we uit elke fout. In onze gids over AI harnesses lees je meer over zulke bedrijfsharnesses. Zie ook ons stuk over agentic engineering.
Veelgestelde vragen over harness engineering
Wat is harness engineering in eenvoudige woorden?
Het is de werkomgeving van een AI-agent bouwen en verbeteren, zodat hij zelfstandig goed werk levert. Je besteedt minder tijd aan de taak zelf en meer aan de regels, tools en controles waarmee de agent werkt.
Is harness engineering hetzelfde als prompt engineering?
Nee. Prompt engineering gaat over de formulering van een vraag. Harness engineering gaat over het hele systeem rond het model: context, tools, sandbox, controles, evaluaties en logboeken, over veel stappen.
Wat is een voorbeeld van harness engineering?
Een architectuurtest toevoegen aan een pre-commit hook nadat een agent een modulegrens brak, is harness engineering. De afspraken van je team in een AGENTS.md-bestand zetten ook, net als een gedragstest die nakijkt of de agent de validator draaide voor hij een taak klaar verklaarde.
Is Claude Code harness engineering?
Claude Code is een harness: Anthropic ontwierp de binnenste laag. Wanneer jij daar je eigen instructiebestanden, skills, hooks en MCP-servers bovenop zet, doe je aan harness engineering op de buitenste laag.
Moet je ontwikkelaar zijn om aan harness engineering te doen?
Voor coding agents meestal wel. Voor agents in marketing, sales of operations lijkt het werk meer op heldere werkwijzen en controles uitschrijven, en dat doen vakexperts vaak beter dan ontwikkelaars.
This article is also available in English on i-scoop.eu: what is harness engineering?
Bronnen: OpenAI, Harness engineering (11 februari 2026); Birgitta Böckeler, Harness engineering for coding agent users (2 april 2026); Google Developers Blog, The anatomy of harness engineering (9 september 2026); LangChain, The anatomy of an agent harness.