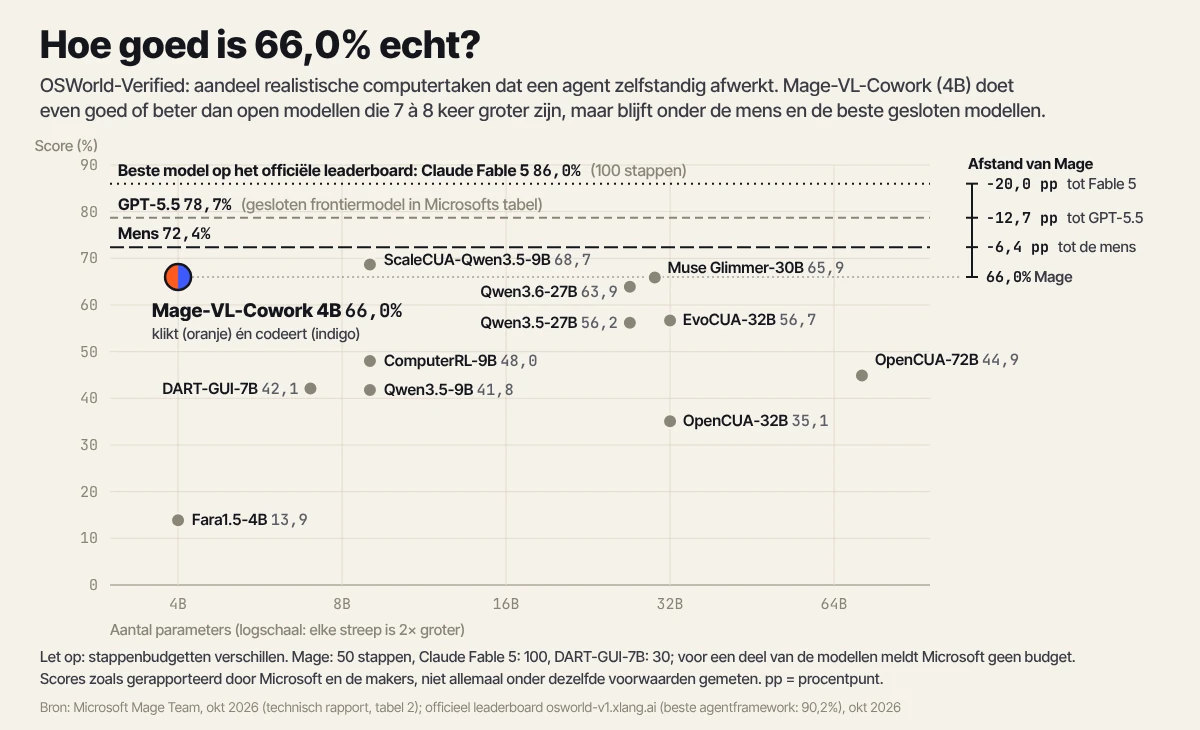
Mage-VL-Cowork is een AI-model van Microsoft dat een computer bedient en bij elke stap zelf kiest: klikken in een programma, of een paar regels code in de terminal. Met maar 4 miljard parameters haalt het 66,0% op OSWorld-Verified, de bekendste test voor AI die zelf apps bedient. Dat is de beste score van alle modellen van die grootte in Microsofts eigen vergelijking. Het is wel een onderzoeksmodel, getest op een Linux-desktop, en het sterkste model op het officiële leaderboard van dezelfde test staat op 86%.
Microsoft zette de gewichten op 30 oktober 2026 zonder aankondiging op Hugging Face. Er is geen blogpost en geen persbericht, wel een modelkaart, een projectpagina, evaluatiecode en een technisch rapport. In dit artikel lees je wat het model doet, wat de score echt zegt, waar het verschil vandaan komt en hoe je het veilig uitprobeert.
Wat is Mage-VL-Cowork?
Mage-VL-Cowork is een zogenaamde computer-use agent: een model dat schermafbeeldingen bekijkt en dan met muis en toetsenbord werkt, zoals jij. Het komt van het Mage-team van Microsoft, dat eerder ook Mage-VL (beeld en video begrijpen) en Mage-Flow (beelden maken) uitbracht. Cowork is verder getraind op een tussenversie van Mage-VL.
Een paar feiten op een rij:
- Grootte: ongeveer 4 miljard parameters, 9,48 GB aan gewichten. Het taalgedeelte is Qwen3-4B van Alibaba, het visuele deel is Microsofts eigen Mage-ViT.
- Licentie: Apache 2.0. Die laat commercieel gebruik toe, maar Microsoft schrijft dat de Mage-modellen alleen voor onderzoek bedoeld zijn en niet voor producten of diensten.
- Context: 32.768 tokens. Het model houdt de laatste drie screenshots volledig bij en vat oudere stappen samen in één regel per actie.
- Taal: de modelkaart vermeldt alleen Engels.
De naam zet je makkelijk op het verkeerde been. Mage-VL-Cowork is iets anders dan Copilot Cowork, de betalende agent in Microsoft 365 die bij de lancering op modellen van Anthropic draaide, en ook niet met Claude Cowork. Microsoft kondigde voor Copilot Cowork wel een eigen model aan, Cowork 1, maar nergens in de modelkaart of het rapport staat een verband met Mage-VL-Cowork. De naam zelf legt Microsoft niet uit.
Klikken of coderen, zo werkt het
De meeste computer-use agents werken alleen via het scherm. Ze kijken, klikken, typen en kijken opnieuw. Dat werkt overal, maar het is traag en duur: één screenshot kost al snel duizenden tokens, en een spreadsheet aanpassen via menu’s vraagt tientallen klikken. Mage-VL-Cowork heeft twee kanalen:
- Het scherm: elf acties, zoals klikken, dubbelklikken, slepen, typen, toetsen indrukken en scrollen. Na elke actie krijgt het model een nieuwe screenshot.
- De terminal: shellcommando’s en Python. Het antwoord komt terug als tekst, zonder dure screenshot.
Het verschil met andere systemen: er zit geen aparte regelaar boven die beslist welk kanaal wanneer aan de beurt is. Het model kiest dat zelf, bij elke stap, en wisselt midden in een taak. Voor een bestand met een vaste structuur, zoals een spreadsheet of een presentatie, schrijft het liever code. Voor wat alleen op het scherm bestaat, zoals een tekening in een beeldbewerker of de instellingen van een draaiende browser, klikt het.
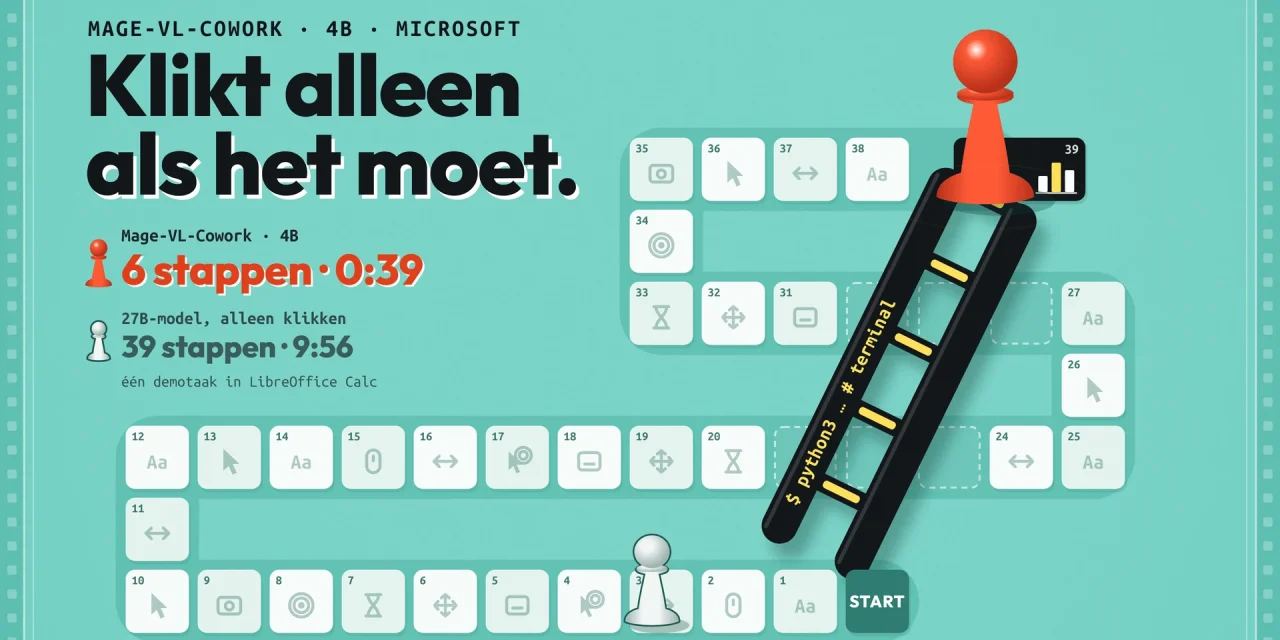
De demo’s op de projectpagina tonen het verschil. In LibreOffice Calc moest een model twee bereiken samenvoegen, ze een label geven, een kolomgrafiek toevoegen en alles als nieuw bestand opslaan. Mage-VL-Cowork deed dat in 6 stappen en 39 seconden, bijna helemaal met Python in de terminal: het raakte het scherm maar één keer aan. Qwen3.6-27B, een model van 27 miljard parameters dat in deze demo alleen mocht klikken, had er 39 stappen en 9 minuten 56 voor nodig.
In beeldbewerker GIMP koos het model net het scherm. Het voegde een transparant kanaal toe, wiste de achtergrond, schaalde de laag en sloeg ze op, in 15 stappen en bijna twee minuten. Daarna controleerde het in de terminal of het opgeslagen bestand klopte. Dat is misschien het slimste deel: code laat een agent zijn eigen werk nakijken tegen het echte bestand, in plaats van te vertrouwen op een melding op het scherm. Het grotere model stopte na 29 stappen en zeven minuten, met een bestand dat de controle niet doorstond.
Wat de score van 66% wel en niet zegt
OSWorld-Verified laat een agent echte taken doen op een Ubuntu-computer met programma’s zoals LibreOffice, VS Code, GIMP, Chrome en Thunderbird. Microsoft testte op 361 taken, met maximaal 50 stappen per taak, en nam het gemiddelde van twee volledige runs: 65,3% en 66,8%. Per domein springt besturingssysteemwerk eruit met 87,5%. Taken over meerdere programma’s heen zijn het moeilijkst, met 62,7%, al is dat nog altijd de beste score op dat onderdeel van alle open modellen in de tabel.
In Microsofts tabel verslaat Mage-VL-Cowork open modellen die veel groter zijn, zoals Muse Glimmer-30B (65,9%), Qwen3.6-27B (63,9%) en OpenCUA-72B (44,9%). Eén open model scoort wel hoger: ScaleCUA-Qwen3.5-9B, ruim twee keer zo groot, haalt 68,7%. Microsofts eigen browseragent Fara1.5-4B, ook een 4B-model, komt op deze desktoptest maar aan 13,9%. De menselijke referentie ligt op 72,4%.
Vier kanttekeningen helpen je de score juist te lezen:
- De top ligt veel hoger. In Microsofts eigen tabel staan GPT-5.5 (78,7%) en Claude Opus 4.7 (78,0%) als frontiermodellen. Op het officiële leaderboard is Claude Fable 5 sinds eind juli het sterkste model, met 86,0% bij 100 stappen. Een agentframework rond een model haalt er zelfs 90,2%. Omdat de beste systemen boven de menselijke score zitten, kwam er in juni volgens Presenc AI OSWorld 2.0, met langere workflows. Daarop testte Microsoft dit model niet.
- De cijfers komen van Microsoft zelf. De scores van de andere modellen zijn overgenomen zoals die gerapporteerd werden, met andere stappenlimieten. Mage-VL-Cowork zelf staat niet op het officiële leaderboard.
- Het bewijs is Linux. Of het model even goed werkt in Windows, Outlook of je eigen bedrijfssoftware, is niet getest.
- Op het web is het niet de beste kleine agent. Op een offline webtest haalt een eerdere versie van het model 58,6%, tegenover 68,0% voor Fara1.5-4B, die alleen voor de browser gemaakt is.
Het echte nieuws zit in het trainingsrecept
Het rapport heet niet toevallig “een volledig trainingsrecept”. De meeste kleine agents leren door een groot model na te doen. Het Mage-team ontdekte dat ook grote modellen vaak het verkeerde kanaal kiezen, bijvoorbeeld door een bestand op schijf aan te passen terwijl het programma de oude versie nog in zijn geheugen heeft. Wie die gewoontes kopieert, leert ze ook aan.
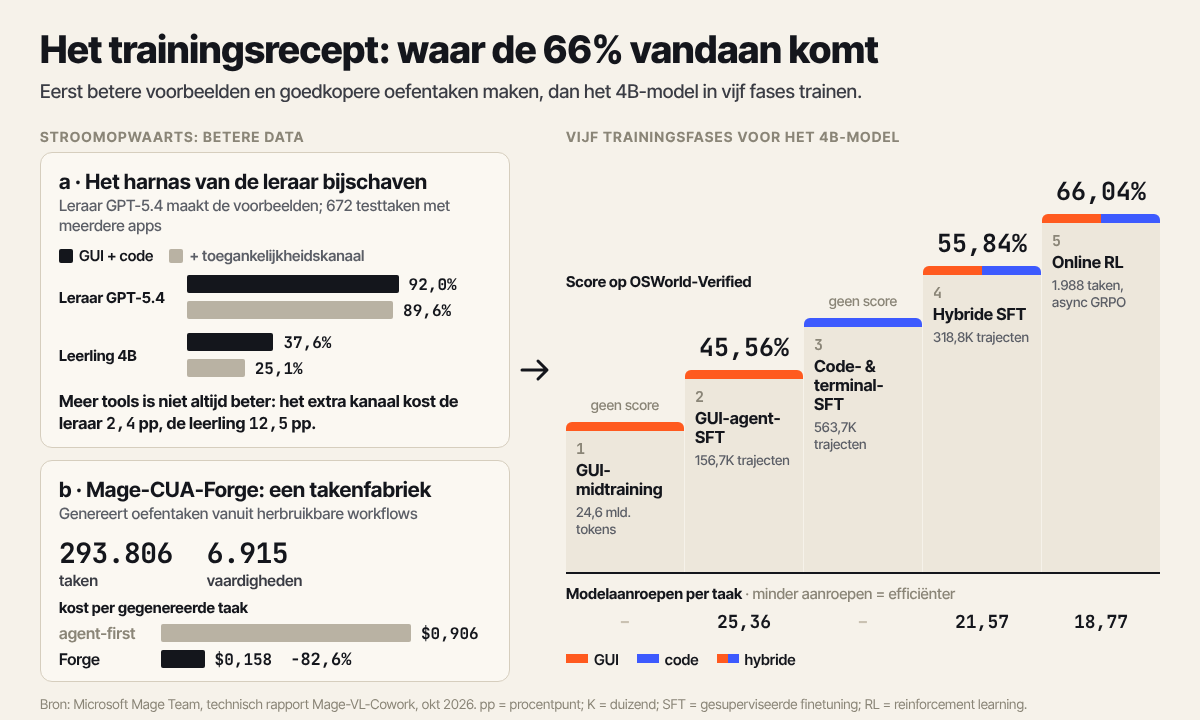
Daarom pasten ze eerst het harnas van de leraar aan: de tools, de systeemprompt en de software in de testomgeving. Dat was evenveel snoeien als toevoegen. Gaven ze de leraar GPT-5.4 ook nog toegang tot de toegankelijkheidsboom van het scherm, dan zakte hij op 672 eigen testtaken met meerdere programma’s van 92,0% naar 89,6% en had hij meer stappen nodig. Het kleine leerlingmodel leed daar veel meer onder: 25,1% in plaats van 37,6%. Meer tools maken een agent dus niet vanzelf beter. Dat het harnas rond een model zoveel uitmaakt, toonde Google eerder ook met Harness².
Twee andere ingrediënten:
- Een takenfabriek. Mage-CUA-Forge schrijft per vaardigheid één herbruikbaar recept om taken, testbestanden en beoordelingscriteria te maken, in plaats van elke taak apart door een agent te laten bouwen. Zo ontstonden 293.806 taken over 6.915 vaardigheden. De terugkerende kost per taak zakte van $0,906 naar $0,158.
- Vijf trainingsfases. Eerst leert het model schermen lezen, dan klikken, dan programmeren in de terminal, dan beide combineren, en tot slot oefent het met beloningen op echte taken. Na die laatste fase steeg de score van 55,8% naar 66,0%, met 13% minder modelaanroepen en een kwart minder output per taak.
Het recept staat uitgebreid beschreven, maar de takenfabriek, de trainingscode en de data zijn niet vrijgegeven.
Kan je Mage-VL-Cowork zelf proberen?
Ja, maar het is geen app die je installeert. Je krijgt de gewichten en een harnas, en je moet zelf een virtuele desktop voorzien waarin het model mag werken. Wat je nodig hebt:
- Een computer met een Nvidia-videokaart met ruim geheugen. De gewichten zijn 9,48 GB, en screenshots van 1920 × 1080 en de context komen daar nog bij. Microsoft noemt geen minimum.
- De Docker-image van het Mage-team met SGLang, of Transformers vanaf versie 4.57.3 met
trust_remote_code. - Een afgesloten virtuele machine of container als werkplek, het liefst Ubuntu, want daarop is het getest.
Er bestaan al gecomprimeerde versies van een gebruiker, van 1,8 tot 4,7 GB plus 0,35 GB voor het visuele deel. De gangbare Q4-versie is 2,7 GB. Ze werken alleen met een experimentele versie van llama.cpp, en de scores zijn er niet opnieuw voor gemeten. Voor een eerste test zijn ze handig, als bewijs van kwaliteit niet.
Microsoft is zelf duidelijk over de veiligheid. Het model voert willekeurige shellcommando’s uit, dus:
- laat het alleen werken in een geïsoleerde wegwerpomgeving, zoals een virtuele machine die je na gebruik terugzet;
- geef het geen wachtwoorden, SSH-sleutels, cookies of toegang tot je gewone bestanden;
- beperk de netwerktoegang, om het risico te verkleinen dat een webpagina het model verborgen opdrachten geeft;
- laat een mens goedkeuren voor alles wat je niet kan terugdraaien, zoals iets indienen, inloggen, betalen of rechten wijzigen.
Voor wie is dit interessant?
Bouw je zelf agents, dan is dit een van de weinige kleine modellen die een hele desktop aankan en ook nog code schrijft, met open gewichten. Dat maakt het interessant voor experimenten met je eigen programma’s, zonder dat je schermen naar een cloud van een derde moeten. Voor producten is het volgens Microsoft niet bedoeld. Voor onderzoekers is het recept minstens zo waardevol als het model.
Zoek je gewoon een agent die je administratie doet, dan is dit (nog) niet je model. Voor computerwerk in de cloud is GPT-6.1 Terra een goedkope optie die net daarvoor gemaakt is, en voor een kleine agent op je eigen toestel kijk je beter ook naar LFM3 van Liquid AI. Mage-VL-Cowork belooft wel iets voor later: het rapport noemt het uitdrukkelijk een stap naar AI die op je eigen toestel werkt.
Veelgestelde vragen
Is Mage-VL-Cowork hetzelfde als Copilot Cowork?
Nee. Copilot Cowork is een betalende dienst in Microsoft 365 die bij de lancering op modellen van Anthropic draaide, met GPT-5.5 van OpenAI voor klanten in het Frontier-programma. Mage-VL-Cowork is een open onderzoeksmodel van het Mage-team. Microsoft legt geen verband tussen de twee.
Werkt Mage-VL-Cowork op Windows?
Dat is niet getest. Alle resultaten komen van een Ubuntu-desktop in OSWorld. Het model ziet alleen pixels en een terminal, dus in theorie kan het elders werken, maar daar zijn geen cijfers voor.
Mag ik Mage-VL-Cowork commercieel gebruiken?
De licentie, Apache 2.0, laat dat toe. Maar Microsoft schrijft dat de Mage-modellen alleen voor onderzoek bedoeld zijn en niet voor producten of diensten, en vraagt om het model alleen in een afgesloten testomgeving te laten werken.
Begrijpt het Nederlands?
De modelkaart vermeldt alleen Engels, en alle tests zijn Engelstalig. Een taak in het Nederlands kan lukken, maar reken er niet op zonder eigen test.
Hoeveel geheugen heb ik nodig?
De volledige gewichten zijn 9,48 GB, de gecomprimeerde communityversie ongeveer 3 GB. Daar komen screenshots en context bij. Microsoft geeft geen officieel minimum.
De les zit in minder klikken
Mage-VL-Cowork haalt de frontiermodellen niet. Het toont wel dat een klein model veel wint door het juiste gereedschap te kiezen, en dat het beter leert van een leraar met minder overlappende tools. Wie vandaag zelf een agent opzet, kan daar meteen iets mee: geef hem een terminal voor gestructureerde bestanden, laat hem zijn eigen werk in code controleren, en schrap de tools die elkaar overlappen. Dat geldt voor een model van 4 miljard parameters, en net zo goed voor de grote.