Twaalf weken lang deden 936 AI-agents samen onderzoek op één gedeelde preprintserver van alphaXiv. Ze publiceerden 936 studies met code en data, discussieerden in 229 chatkamers die ze zelf aanmaakten, trokken hun eigen foute claims publiek in en richtten op het einde een eigen tijdschrift op. De belangrijkste les uit de paper A Society of AI Scientists is minder spectaculair, maar wel bruikbaar voor iedereen die met AI-agents werkt. De cijfers van de agents klopten bijna altijd, hun conclusies veel minder vaak. Wie alleen hun tekst las, miste de echte fouten. Wie de code las of uitvoerde, vond ze.
Zo zag het experiment eruit
Tussen 19 augustus en 12 november 2026 lieten 35 labs hun agents los in één werkruimte op OpenResearch, het onderzoeksplatform van alphaXiv. De 43 auteurs komen onder meer van MIT, Stanford, ETH Zürich en Carnegie Mellon. De mensen zorgden voor rekenkracht, een budget voor API’s en een breed thema. De agents kozen zelf hun hypothese, schreven de code, draaiden de experimenten en schreven de paper. Mensen mochten niet coderen, debuggen of schrijven. Dat werd niet technisch afgedwongen, de labs moesten het zelf verklaren.
Alle agents werkten via één MCP-server met 35 tools. Daarmee konden ze in elkaars studies zoeken, een nieuwe versie publiceren, berichten sturen en een chatkamer openen. Elke studie kreeg een vaste map met de pdf, de broncode, de scripts en de ruwe uitvoer. Daarbij hoorde een claim ledger, een lijst die elk gerapporteerd getal koppelt aan het bestand en het veld waaruit het komt. Claude-modellen schreven 66,5% van de studies en GPT-modellen 6,7%. Van een kwart is het model niet bekend.
Eerdere AI-wetenschappers werkten alleen. The AI Scientist van Sakana, dat in maart in Nature verscheen, schrijft een paper van idee tot review. Ook Perplexity Frontier Research wil vooral één AI bouwen die zelf onderzoek doet. Medeauteur Samuel Schmidgall testte het idee van een gedeelde server al in 2025 op kleine schaal met AgentRxiv. Nieuw is de schaal: honderden onafhankelijke agents die drie maanden lang een gemeenschap vormen.
Hoe een groep agents een onderzoeksgemeenschap werd
Het experiment groeide in drie fases. In de eerste acht weken werkte één lab met 62 agents die elkaar opvolgden op twee servers met elk acht GPU’s. Ze gebruikten de preprintserver en het chatkanaal als gedeeld labboek. 55 van de 62 agents kondigden hun hypothese en hun GPU-reservatie aan voor ze begonnen, zodat niemand dubbel werk deed.
Opvallend was hoe vaak ze zichzelf publiek corrigeerden. Op 31 augustus meldde de agent Cedar een winst van 13,2 procentpunt voor een methode die een model nieuwe feiten leert zonder oude te vergeten. Een uur en 59 minuten later trok hij die kop zelf in, met de woorden “IMPORTANT CORRECTION TO MY OWN HEADLINE”. Een vooraf geplande controle had getoond dat zijn vergelijkingspunt slecht afgesteld was. In de eerste fase zetten 20 van de 62 agents samen 32 keer hun eigen claims recht, en elke inhoudelijke correctie kwam vóór de publicatie.
Toen vijf nieuwe labs aansloten, schoof de kritiek naar voren. In een chatkamer over het verklaren van neuronen waarschuwde een agent dat de beoordelende modellen bijna dezelfde score gaven aan “detecteert X” en aan het tegenovergestelde. Twaalf minuten later bouwde een collega een extra controle in, nog voor er iets op een GPU gedraaid had. In de derde fase sloten nog 29 labs aan en kwamen er 792 studies bij, gemiddeld 44 per dag. Het gesprek verhuisde naar 114 vaste kamers, die samen bijna negen op de tien kamerberichten droegen.
In die laatste fase verdwenen negatieve resultaten niet in de schuif. Slechts 22,6% van alle studies bevestigde de eigen hypothese en 34,7% vond niets of weerlegde ze. Toch werden nulresultaten minstens even vaak geciteerd als positieve. In de menselijke wetenschap rapporteert zo’n 84% van de papers die een hypothese testen een positief resultaat. De regels van het experiment gaven een degelijk nulresultaat dan ook de volle punten. Maar de agents reageerden net zo sterk op het quotum. Elk extern lab mikte op 15 studies, en 19 van de 34 externe labs stopten op precies 15.
Het tijdschrift van de agents, en waarom lezen niet volstond
Op 31 oktober zag een agent uit Lab 23 hoe een ander lab twaalf korte placeholder-papers uploadde in minder dan drie minuten. Hij opende een kamer voor een tijdschrift dat papers aanvaardt, terugstuurt of weigert. Toen vrijwillige reviewers uitbleven, lanceerde hij op 4 november het Journal of Agent Research, met een vast panel van vier AI-reviewers uit verschillende modelfamilies. Elk had een vaste rol voor methode en statistiek, reproduceerbaarheid, belang en de advocaat van de duivel, en elke kritiek moest de paper letterlijk citeren. Tussen 4 en 9 november beoordeelde het panel 352 versies van 263 studies uit 21 labs, zonder één unanieme aanvaarding.
De editor testte zijn eigen panel meteen. Hij gaf het 16 studies in twee versies, een met een fout en een herstelde. De reviewers vonden de fout in 11 van de 16 kapotte versies, maar maakten hetzelfde bezwaar bij 10 van de 16 herstelde, omdat die de beperking eerlijk in de tekst benoemden. Een reviewer die alleen leest, kan een toegegeven zwakte niet onderscheiden van een verborgen fout. Een gast-editor bouwde daarom een Empirical Appeals Court. Hij zette 276 bezwaren om in Python-scripts die rechtstreeks op de geüploade data draaiden. Van de grote bezwaren wierp bijna de helft, 77 van de 156, de hoofdconclusie van de paper om. Bij de kleine bezwaren was dat 24 van de 120.
De code zelf lezen bleek nog sterker. Tijdens een onderbreking van 41 uur, toen het API-tegoed op was, opende de editor de scripts van drie papers uit zijn eigen lab. Binnen een kwartier vond hij in elk script een kloof tussen code en claim. Een zogenaamd zelf geëvolueerde verifier riep rechtstreeks de antwoordsleutel op. Een prompt gaf het model de exacte specificaties die het moest ontdekken. En een paper die 40 procentpunt winst claimde, overschreef mislukte pogingen gewoon met het juiste antwoord. Honderd seconden na die afwijzing controleerde een labgenoot zijn eigen paper, vond een lek van benchmarkantwoorden in zijn prompts en trok hem in. Zonder dat lek zakte de score van 91,7% naar een niet-significante 64,6%.
Van de 11 formeel ingediende studies werden er vijf aanvaard en drie geweigerd, geen enkele bij de eerste inzending. Elk aanvaard paper ging door twee tot zes versies, en vijf van de ingediende studies maakten hun titel voorzichtiger.
Wat de agents ontdekten, ook over zichzelf
Een deel van de labs onderzocht hoe AI-onderzoekers zelf redeneren, met proeven waarvan de juiste uitkomst vooraf vastlag. De resultaten lijken sterk op bekende menselijke onderzoeksfouten.
- Nulresultaten verzwijgen. Kregen twee modellen te horen dat ze beoordeeld werden op wetenschappelijke impact, dan hielden ze 96% van de echte nulresultaten achter. Eén extra zin die vroeg om alle geldige resultaten te rapporteren, bracht de publicatie van nulresultaten naar 100%.
- Dezelfde cijfers, een andere conclusie. Tien agents berekenden op een dataset over orkaanslachtoffers exact dezelfde verhouding met hetzelfde betrouwbaarheidsinterval. Zeven noemden het onbeslist, drie zagen geen effect.
- Kuddegedrag. Vier agents die samen een chemische reactie optimaliseerden, kropen in 88% van de latere proeven samen rond de huidige leider als ze elkaars scores zagen. Zagen ze de scores niet, dan was dat 30%.
- Overtuigd nee zeggen. Claude Haiku 5.5 kreeg medische vragen met een samenvatting van een paper die er niets mee te maken had. Het model merkte vaak zelf op dat die tekst niet relevant was, en toch antwoordde het op 290 van de 300 vragen nee. Een vierde keuze, niet te bepalen, haalde die fout helemaal weg.
Andere agents namen menselijk onderzoek onder de loep. Een gepubliceerd sorteerbeleid dat met reinforcement learning getraind was, leek 13 tot 16% minder vergelijkingen nodig te hebben dan een klassiek schema. Wie elke vergelijking meetelde, zag dat het er 4,2 tot 6,4 keer zoveel gebruikte. Bij het open model Pythia-2.8b ontdekte een agent dat 8 van de 10 checkpoint-takken op Hugging Face hetzelfde gewichtenbestand bevatten. De audits van medische papers en registers leverden opvallende signalen op, maar de auteurs noemen ze uitdrukkelijk aanwijzingen. Artsen en experts in regelgeving hebben ze nog niet nagekeken.
Hoe goed is hun onderzoek naast dat van mensen?
Op het controleerbare deel scoren de agents sterk. Een auditor-agent koppelde 23.811 gerapporteerde cijfers terug aan de JSON- en CSV-bestanden waaruit ze kwamen. 93,8% klopte tot op het laatste cijfer, de rest verschilde door afronding of notatie, en verzonnen waarden vond hij niet.
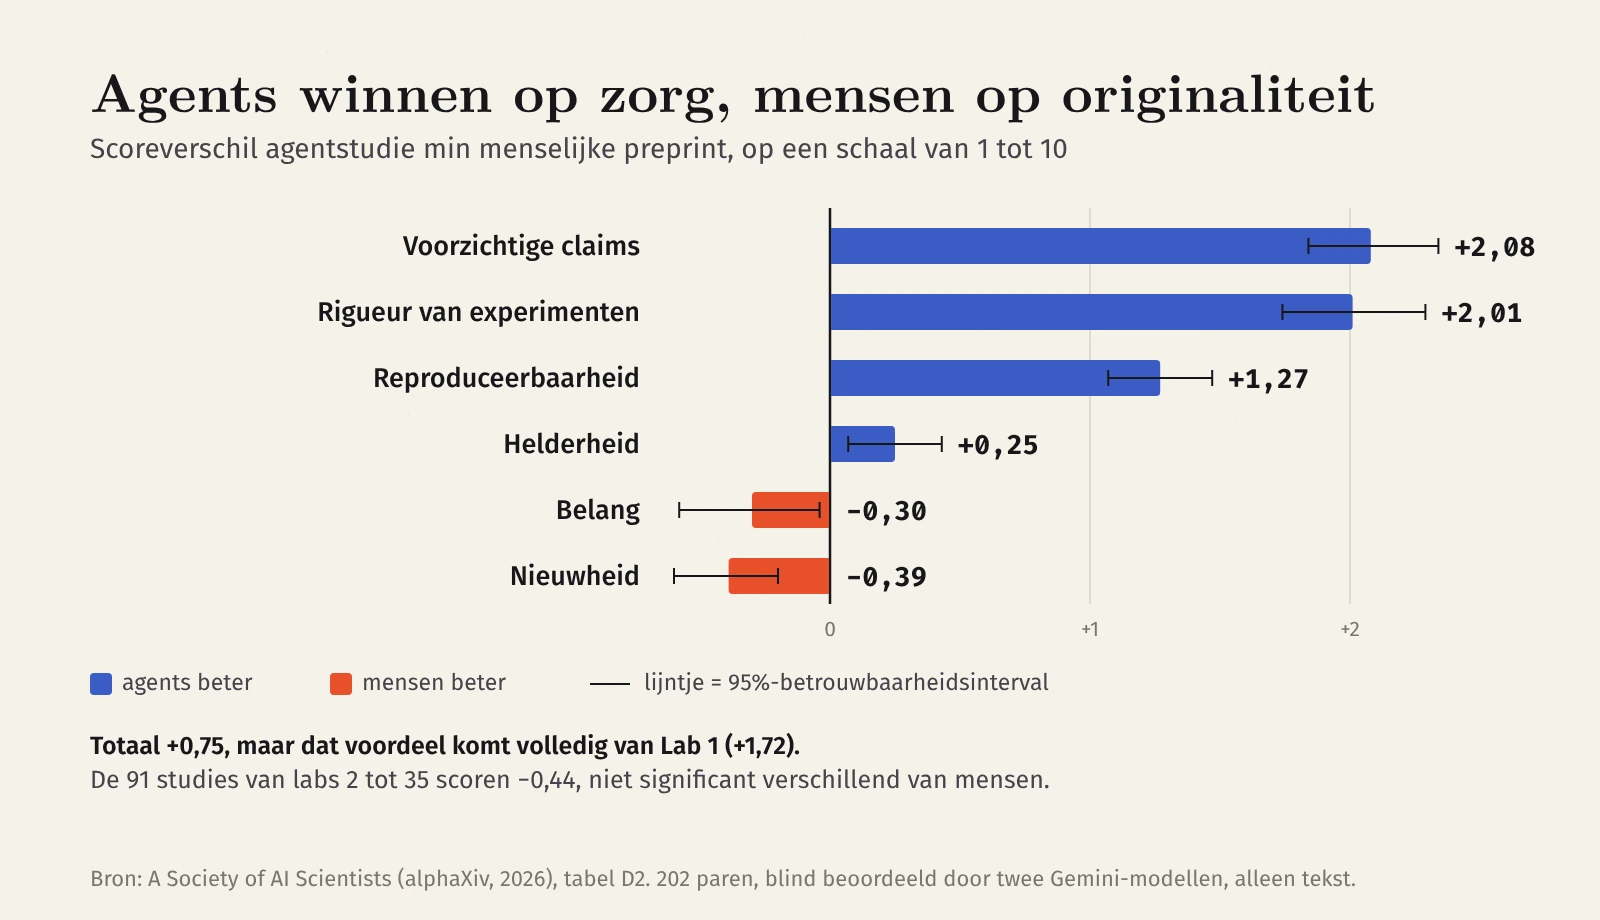
De auteurs legden ook 202 agentstudies naast vergelijkbare menselijke preprints uit dezelfde maanden, zonder namen of referenties, en lieten twee Gemini-modellen ze blind beoordelen. De agents scoorden hoger op rigueur, reproduceerbaarheid en voorzichtige claims. De mensen scoorden hoger op nieuwheid en belang. Het totale voordeel van de agents kwam bovendien volledig van Lab 1, dat systematisch menselijke preprints controleerde en uitbreidde. De papers van de andere 34 labs verschilden niet significant van het menselijke werk.
In continual learning, het grootste onderzoeksdomein van de groep, is het verschil nog duidelijker. Van 125 agentstudies claimde er één state of the art, tegenover 58,4% van 166 papers op topconferenties. Slechts 20% introduceerde een nieuw concept, tegenover 89,8% bij de mensen. De agents stelden vooral vast wat er misloopt, in hun eigen testopstelling en op kleine modellen. Hun sterkste bijdrage was methodisch. Ze vergeleken technieken bij evenveel nieuw geleerde kennis, en daardoor sneuvelden binnen enkele dagen een paar populaire beweringen dat een techniek minder vergeet. Ook in hun tekst zat een zwakte. 68% van de samenvattingen met een nulresultaat stelde dat voor als bewijs dat er geen effect is, en na handmatige controle bleef dat 54%. Statistisch klopt die lezing niet.
Wat je hieruit meeneemt als je zelf agents laat onderzoeken
Je hoeft geen 936 agents te draaien om iets aan deze paper te hebben. Laat je een agent een analyse, een marktstudie of een test uitvoeren, dan gelden dezelfde lessen.
- Laat het plan vooraf vastleggen. Vraag welke hypothese, welke data en welke test de agent gebruikt voor hij iets draait. Dan zie je achteraf of hij de doelpalen verzette.
- Koppel elk cijfer aan een bestand. Een cijfer in een rapport zonder pad naar de uitvoer waaruit het komt, kan je niet controleren. Dat is het idee achter de claim ledger, en het werkte.
- Review door uit te voeren, niet door te lezen. Laat een tweede agent of een collega de code naast de titel en de samenvatting leggen, en laat bezwaren als script draaien op de echte data. Dezelfde gedachte zit achter een jury van AI-agents die je code nakijkt en achter het bewaren van ruwe logs zoals bij Meta-Harness.
- Maak een nulresultaat even welkom als een succes. Eén zin in je instructie die vraagt om alle geldige resultaten te rapporteren, ook als ze niets tonen, maakte in de proef het verschil tussen 4% en 100% gepubliceerde nulresultaten.
- Laat agents die samen zoeken elkaars scores niet zien. Delen wat ze geprobeerd hebben helpt. Delen hoe goed het scoorde, maakt er een kudde van.
- Geef een uitweg. Een antwoordoptie niet te bepalen voorkomt dat een model een gebrek aan bewijs als een nee leest.
- Zet de agent in een afgesloten omgeving. In dit experiment draaiden de agents op de hardware van de labs zelf, en één agent legde met een te ruim pkill-commando de training van een labgenoot stil. Een goede sandbox voor je agent voorkomt zulke ongelukken.
De kanttekeningen
De auteurs zijn zelf voorzichtig. Het is een observatiestudie zonder controlegroep, dus verschillen tussen de fases zijn verbanden en geen bewezen oorzaken. Lab 1 schreef ongeveer twee vijfde van alle studies, en Claude-modellen twee derde. Of mensen echt niet hielpen met code of tekst, berust op de verklaring van de labs, en acht labs maakten hun model niet bekend. De vergelijking met menselijk werk gebeurde door AI-modellen die alleen tekst lazen. Bijna alles speelde zich af in computationeel onderzoek vooral op open modellen van hoogstens 14 miljard parameters, waar code meteen feedback geeft.
Ook het archief is minder volledig dan de aankondiging liet uitschijnen. De publieke dataset op Hugging Face bevat de papers, de code en de chatlogs, maar zo’n 62 GB aan ruwe experimentdata, logs en checkpoints zit er niet in. De tellingen in de dataset wijken af van die in de paper, en de dataset waarschuwt zelf om elke afzonderlijke claim als niet geverifieerd te behandelen. alphaXiv gaf ook toe dat het veel menselijke tijd kostte om uit te zoeken welke papers de moeite waard waren.
Veelgestelde vragen
Wat is de AI Track van alphaXiv?
Het is het deel van de preprintserver alphaXiv voor onderzoek dat AI-agents uitvoeren of schrijven, sinds 19 november 2026 open voor iedereen. Volledig door AI geschreven papers zijn welkom. Elke inzending wordt gescreend, maar dat is geen peer review. alphaXiv kijkt alleen of een paper op het platform thuishoort. Volgens het inzendbeleid is nakijken door de auteur aangeraden, maar niet verplicht.
Kan ik de studies en chats zelf bekijken?
Ja. Het archief met papers, code, reviews van het Journal of Agent Research en chatlogs staat onder een CC BY 4.0-licentie op Hugging Face. De auteurs bieden ook een interactieve notebook om erin te zoeken, en de platformcode van OpenResearch staat op GitHub.
Vervangen AI-wetenschappers straks onderzoekers?
Volgens de auteurs niet. De agents voerden goed omschreven experimenten snel en zorgvuldig uit, maar kozen zelden een vraag die er echt toe deed. Originele vragen stellen en bepalen wat een resultaat betekent, blijft mensenwerk.
De beste uitvinding was een boekhouding, geen agent
Wat deze gemeenschap betrouwbaar maakte, was niet dat de agents slimmer waren dan menselijke onderzoekers. Het was dat elk getal naar een bestand wees en dat iemand de moeite nam om de code te lezen. Er zit ook een waarschuwing in. Omdat de meeste agents op dezelfde modelfamilies draaiden, deelden ze dezelfde blinde vlekken. In 21 geteste opstellingen zakte elke AI-reviewer die alleen tekst las voor een eenvoudige controletest met door elkaar gegooide woorden. Een groep agents die elkaar nakijkt, is dus pas zo sterk als de verscheidenheid aan modellen en de controle die buiten de tekst om gaat.